Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
Raw-RAG 쉬운 읽기
대화 원문을 잘라 찾고 다시 순위만 매기는 Raw-RAG가 12개 에이전트형 메모리 시스템과 비교해 일곱 설정 중 여섯에서 가장 높았습니다. 이긴 폭과 진 설정, 증거 확보와 활용의 차이, 가공 단계의 정보 손실을 조건과 함께 설명합니다.
Paper: Zhengye Bao; Shengtao Zhang; Haokai Zhang; Shiqi Lou; Muning Wen; Minnan Luo (2026). "Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought". arXiv preprint, arXiv:2610.30755v1, 2026-10-22. 원문 · PDF.
판본: arXiv:2610.30755v1, 2026-10-22, 62쪽 읽기 버전: 2026-10-31
1. 대화 기록을 꼭 가공해서 기억해야 할까요
LLM 비서는 여러 날에 걸친 대화를 기억해야 하지만, 기록은 금방 컨텍스트 창을 넘습니다. 그래서 대화에서 사실을 뽑아내고, 요약하고, 그래프로 엮고, 오래된 정보를 고치거나 지우는 agentic memory(에이전트형 메모리) 시스템이 많이 나왔습니다. 이 논문은 이런 복잡한 처리가 정말 항상 필요한지 묻습니다.
출발점은 Mem0의 기록 감사입니다. 메모리를 고치거나 지우는 결정(UPDATE, DELETE)은 LoCoMo에서 전체 쓰기 결정의 4.39%, LongMemEval에서 2.46%뿐이었고, 저장 내용이 실제로 바뀐 경우는 1.90%와 1.34%였습니다. 고치기를 '추가'로, 지우기를 '아무것도 안 함'으로 바꾸자 LoCoMo 정확도는 오히려 67.36%에서 69.42%로 올랐습니다.
2. Raw-RAG는 원문을 자르고 찾아 읽기만 합니다
저자들이 기준으로 세운 Raw-RAG는 대화 원문을 가공하지 않습니다. 대화를 256토큰 창(앞뒤 32토큰 겹침)으로 잘라 벡터 색인에 넣고, 질문이 오면 유사도로 후보 128개를 고른 뒤 **reranker(재순위 모델)**로 다시 매겨 상위 15개를 읽기 모델에 줍니다. 저장할 때 LLM으로 사실을 뽑거나 요약하지 않으며, 시간 순서나 상태 변화의 해석은 답을 쓰는 읽기 모델이 맡습니다.
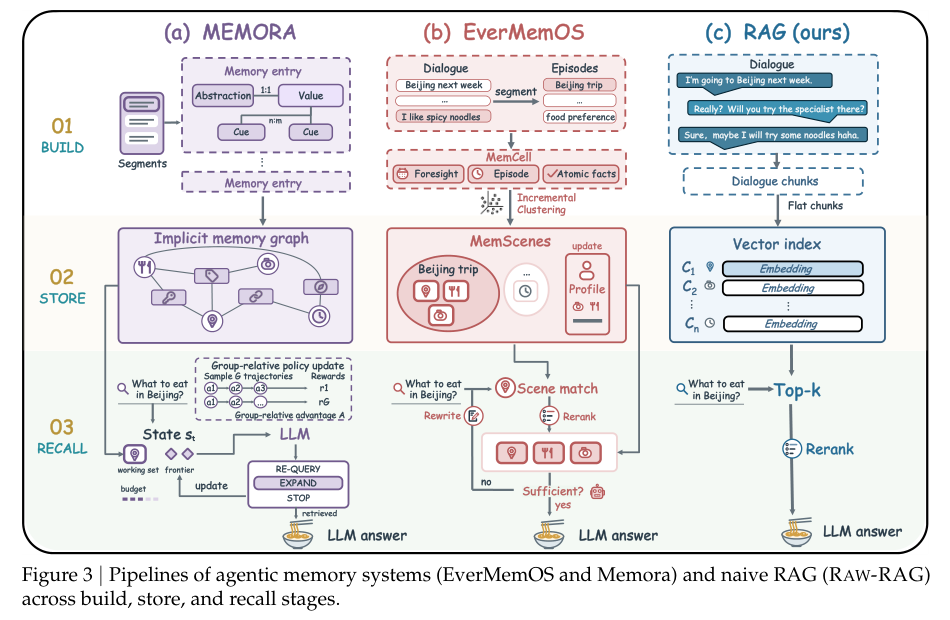
원 논문 Figure 3(논문 PDF 4쪽): EverMemOS와 Memora는 대화를 기억 단위로 가공하고 구조화해 저장합니다. 오른쪽 Raw-RAG는 대화 조각을 그대로 임베딩해 저장하고, 질문에 맞게 다시 순위를 매긴 조각으로 답합니다. 원문 PDF에서 보기.
3. 일곱 설정 중 여섯에서 가장 높았습니다
비교 대상은 EverMemOS, MemOS, Mem0, MemMachine, Memora 등 12개 메모리 시스템이고, 평가는 LoCoMo, LongMemEval, MEME, MemoryAgentBench 네 벤치마크와 읽기 모델 조합인 일곱 설정에서 했습니다. 기록 전체를 그대로 넣는 Full-context는 별도로 보고, 순위는 메모리 시스템끼리 매깁니다.
| 설정 | Raw-RAG | 가장 강한 비교 시스템 | 차이 |
|---|---|---|---|
| LoCoMo, GPT-4o-mini | 89.07 | MemMachine 88.12 | +0.95 |
| LoCoMo, GPT-4.1-mini | 93.70 | EverMemOS 93.05 | +0.65 |
| LongMemEval, GPT-4.1-mini | 87.53 | Memora 87.40 | +0.13 |
| MEME, GPT-4o-mini | 39.30 | MemMachine 37.06 | +2.24 |
| MEME, DeepSeek-V4-Flash | 43.19 | MemMachine 44.71 | −1.52 |
| MemoryAgentBench, GPT-4o-mini | 48.32 | Memora 43.84 | +4.48 |
| MemoryAgentBench, DeepSeek-V4-Flash | 53.41 | Memora 47.88 | +5.53 |
단위는 정확도(%)입니다. Raw-RAG는 여섯 설정에서 1위였지만 격차는 0.13–5.53점으로 크지 않습니다. 진 설정도 있습니다. DeepSeek-V4-Flash의 MEME에서는 MemMachine이 1.52점 앞섰고, Full-context는 63.17로 Raw-RAG보다 19.98점 높았습니다. 부록의 PersonaMem-v2에서는 일곱 시스템 중 3위였습니다. 전체 점수에서 이겨도 과제별로는 집계, 삭제, 연쇄 변경처럼 다른 시스템이 앞서는 항목이 있습니다.
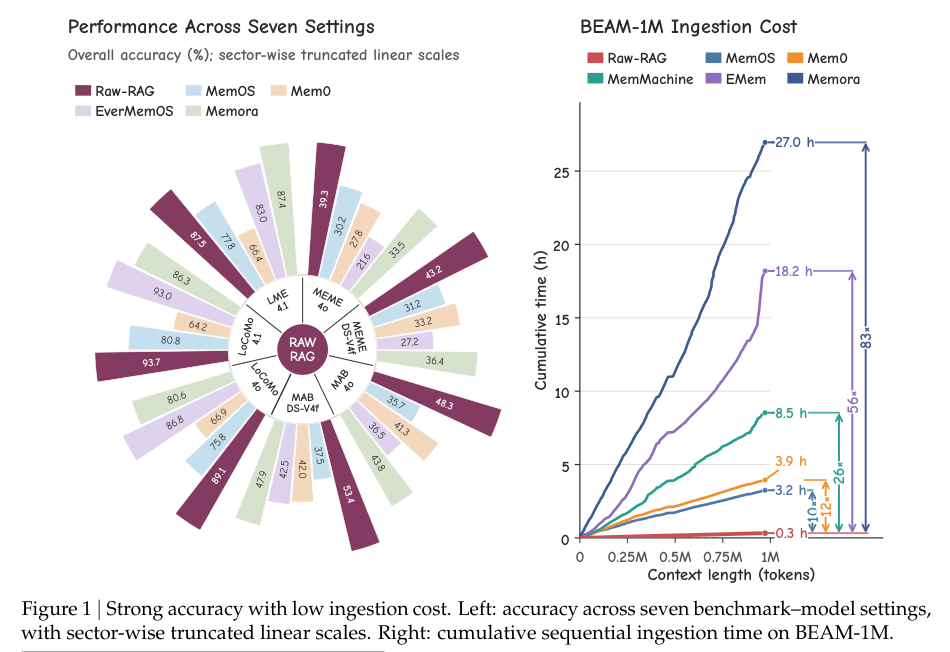
원 논문 Figure 1(논문 PDF 1쪽): 왼쪽은 일곱 설정의 정확도이며 부채꼴마다 눈금이 다릅니다. 오른쪽은 약 100만 토큰 대화(BEAM-1M)를 저장하는 데 걸린 누적 시간으로, Raw-RAG는 0.3시간이고 Memora는 27.0시간입니다. 원문 PDF에서 보기.
4. 무엇이 성능을 만들었나요
MemoryAgentBench에서 설계를 하나씩 바꿔 보면 reranker를 빼는 것이 가장 컸습니다(48.32에서 44.40, −3.92점). 창 크기를 128–1,024토큰으로 바꾸는 것은 유의한 차이가 없었고, 최종 개수를 1개나 120개로 극단적으로 바꾸면 크게 떨어졌습니다. 저자들은 재순위와 적당한 검색 깊이가 중요하며 정확한 기본값은 덜 중요하다고 해석합니다.
반대로 Raw-RAG 위에 메모리 관리를 더하면 모두 낮아졌습니다. 원문 대신 추출한 사실로 검색하면 28.70점(−19.62), 요약을 더하면 42.51점, 관련 조각을 그래프로 이으면 42.54점이었습니다. 이 세 변형은 LLM 토큰 2,160만–1억 930만 개와 2.9–8.8시간이 들었지만, Raw-RAG는 12분이었습니다. MEME 10개 에피소드에서 저장과 검색을 합친 시간도 Raw-RAG가 305.91초로 다음으로 빠른 시스템보다 5.1배, EverMemOS보다 30.4배 빨랐습니다. 다만 검색 시간만 보면 Mem0와 MemOS가 더 짧았습니다.
5. 차이는 '찾아오기'에서 더 크게 났습니다
저자들은 점수를 두 부분으로 나눕니다. **coverage(증거 확보율)**는 답하기에 충분한 증거를 찾아온 질문의 비율이고, **utilization(증거 활용률)**은 충분한 증거가 있을 때 맞힌 비율입니다. Raw-RAG의 coverage는 MemoryAgentBench 45.29%, MEME 76.35%로 두 벤치마크 모두 가장 높았습니다. 반면 utilization은 EMem(89.71%, 86.55%)보다 낮아 최고가 아니었습니다. 시스템 사이의 차이는 coverage에서 더 넓었고, 저자들은 증거에 접근하는 단계가 주요 병목이라고 정리합니다.
답 값만 찾아오는 것으로는 부족하다는 분석도 있습니다. MEME의 추적·연쇄 질문에서 Raw-RAG는 답 값을 90.53%, 그 값에 이르는 순서와 의존 관계까지 함께 56.44% 가져왔습니다. MemOS는 답 값을 88.26% 가져왔지만 관계까지 갖춘 비율은 21.21%였습니다.
6. 가공 단계에서 사라진 정보는 되찾기 어렵습니다
검색이 놓친 것인지, 저장할 때 이미 정보가 사라진 것인지 가르기 위해 저자들은 각 시스템의 저장소 전체를 열어 정답 위치 정보로 골라 주는 조건을 만들었습니다. 원문 증거를 같은 방식으로 골라 주면 61.60%입니다.
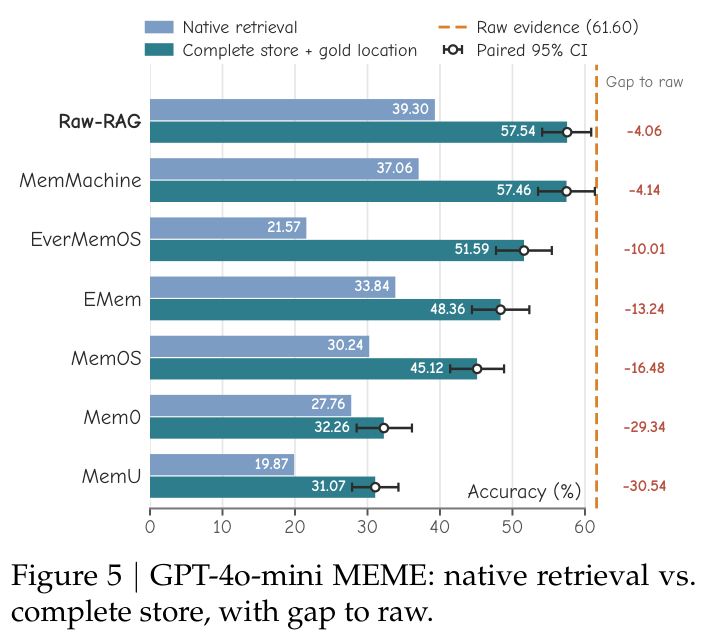
원 논문 Figure 5(논문 PDF 9쪽): GPT-4o-mini MEME에서 연한 막대는 각 시스템의 원래 검색, 진한 막대는 저장소 전체에서 정답 위치를 알고 고른 결과이며 점선은 원문 증거(61.60)입니다. 오른쪽 숫자가 원문과의 격차입니다. 원문 PDF에서 보기.
원문을 보존하는 Raw-RAG(57.54)와 MemMachine(57.46)은 원문 증거에 가장 가까웠고, 많이 가공한 저장소는 Mem0 32.26, MemU 31.07에 머물렀습니다. 증거 길이 상한을 없애도 일곱 저장소 모두 원문보다 7.58–29.38점 낮았습니다. 저자들은 이 결과가 저장 단계의 정보 보존이 중요하다는 것과 일치한다고 보면서도, 이 격차가 증거 조립 방식이나 위치 효과도 섞여 있어 정보 손실의 순수한 척도는 아니라고 밝힙니다.
7. 이전 비교에서 RAG가 약했던 이유
저자들은 RAG가 메모리 시스템에 졌다고 보고한 선행 평가 14건을 다시 살폈습니다. 일부는 4,096토큰처럼 큰 조각을 쓰거나, 1–3개만 가져오거나, 재순위 없이 임베딩 유사도만 썼습니다. 저자들은 이를 구성상의 병목으로 진단하지만, 이것이 점수 차이에 얼마나 기여했는지는 통제된 재실행이 있어야 알 수 있다고 덧붙입니다.
8. 저자가 밝힌 한계
- 근거는 공개 벤치마크의 오프라인 대화에 한정되며, 상호작용형·멀티모달·실제 운영 환경의 성능은 확인하지 않았습니다.
- 원문 기록을 그대로 두는 방식은 저장 공간과 개인정보 보호의 부담을 낳습니다. 원문 저장은 기록과 함께 계속 커집니다.
- 상태 변화를 풀어내는 일은 읽기 모델의 능력에 달려 있습니다. 같은 원문 증거에서도 읽기 모델에 따라 정확도가 50.50%에서 85.48%까지 달랐습니다.
- 실제 운영 시스템은 현재 상태를 다른 도구에 제공하거나 정보를 삭제해야 할 수 있어 정확도 밖의 목표가 생깁니다. 저자들은 정확도·지연·비용을 함께 보며 구조화되거나 압축된 메모리가 원문 검색보다 유리한 경우를 가려야 한다고 씁니다.
이 논문의 주장은 메모리 관리가 쓸모없다는 것이 아닙니다. 평가한 대화 과제에서는 잘 설계한 단순 RAG가 이미 강한 기준선이므로, 새 메모리 시스템은 이 기준선보다 무엇을 더 주는지 보여야 한다는 것입니다.
References
Bao, Z., Zhang, S., Zhang, H., Lou, S., Wen, M., & Luo, M. (2026). Is complex agentic memory always needed? Naive RAG is stronger than we thought (Version 1, arXiv:2610.30755) [Preprint]. arXiv. https://arxiv.org/abs/2610.30755v1