Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought
복잡한 에이전트형 메모리는 장기 대화 이해에 항상 필요한가? Raw-RAG 논문 정리
대화 원문을 잘라 찾고 다시 순위만 매기는 Raw-RAG가 12개 에이전트형 메모리 시스템과 비교해 일곱 설정 중 여섯에서 가장 높았습니다. 이긴 폭과 진 설정, 증거 확보와 활용의 차이, 가공 단계의 정보 손실을 조건과 함께 설명합니다.
Paper: Zhengye Bao; Shengtao Zhang; Haokai Zhang; Shiqi Lou; Muning Wen; Minnan Luo (2026). "Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought". arXiv preprint, arXiv:2610.30755v1, 2026-10-22. 원문 · PDF.
이 글은 arXiv:2610.30755v1 원문만을 기준으로 방법, 비교 대상, 벤치마크, 결과, 진단 분석, 부록의 통제 실험, 저자들이 밝힌 한계를 정리한다. 논문의 주장 범위는 "평가한 대화 과제에서 복잡한 메모리 관리가 필수인가"이며, 모든 메모리 응용에 대한 결론이 아니다. 본문의 '1위'는 모두 Full-context를 제외한 메모리 시스템 사이의 순위다.
요약
| 항목 | 논문이 보고한 내용 |
|---|---|
| 연구 질문 | 추출·변형·구조화·학습형 검색 같은 복잡한 연산이 장기 대화 이해에 항상 필요한가? |
| 방법 | Raw-RAG: 원문 기록을 256-token 창(32 겹침)으로 나눠 flat index에 넣고, dense retrieval 128개 후보를 cross-encoder로 재순위화해 상위 15개를 reader에 준다. LLM 추출·요약·그래프·변경은 쓰지 않는다. |
| 비교 | LoCoMo, LongMemEval, MEME, MemoryAgentBench에서 EverMemOS, MemOS, EMem, SimpleMem, MemU, MemMachine, Mem0, Memora, Nemori, MemoryOS, A-MEM, RecMem과 Full-context. |
| 주요 결과 | 7개 benchmark–model 설정 중 6개에서 Full-context를 제외한 메모리 시스템 중 1위. 가장 강한 비교 시스템과의 격차는 0.13–5.53점. |
| 지는 설정 | DeepSeek-V4-Flash MEME: MemMachine이 메모리 시스템 중 Raw-RAG보다 1.52점 높고, Full-context는 19.98점 높다. 부록 PersonaMem-v2에서는 7개 시스템 중 3위. |
| 진단 | Raw-RAG는 충분한 증거를 더 자주 공급(coverage 우위)하고, 충분한 증거가 주어진 뒤의 정답률(utilization)은 최고가 아니다. 변형된 저장소에 완전 접근해도 raw 증거와 격차가 남는다. |
| 저자들의 한계 | 증거는 공개 벤치마크의 오프라인 대화에 한정되어 interactive·multimodal·운영 환경 성능을 확립하지 않으며, raw-history 접근은 저장·프라이버시 우려도 낳는다. |
목차
- 문제 설정과 동기
- Raw-RAG 파이프라인
- 비교한 메모리 시스템
- 벤치마크와 평가 지표
- 주요 결과와 지는 설정
- 설계 ablation, 메모리 관리 추가, 효율
- 증거 coverage와 reader utilization
- 답 값과 관계·의존 경로
- 변형된 메모리의 oracle 격차
- 저자들이 밝힌 한계와 결론
1. 문제 설정과 동기
1.1 질문과 두 가지 반론
LLM은 여러 대화와 과제에 걸쳐 쌓인 기록을 참조해야 하고, 그 기록은 컨텍스트 창을 크게 넘을 수 있다. 이를 위해 추출, 요약, 변경(mutation), 통합, 군집화, 그래프 구성, 커뮤니티 탐색, 반복 검색, 학습형 검색 전략을 갖춘 에이전트형 메모리 시스템이 제안되어 왔다. 논문은 이 복잡성이 언제 필요한지 묻는 출발점으로 원문 기록 위의 RAG(Lewis et al., 2020)를 둔다.
논문은 raw-history 검색에 대한 두 반론을 제시한다. 첫째는 개념적 반론이다. RAG는 정적 코퍼스와 연결되지만 장기 상호작용에는 대체된 사실, 삭제, 연쇄적 상태 변화가 있다. 명시적으로 현재 상태를 유지하지 않고 기록 검색만으로 충분한가? 둘째는 경험적 반론이다. 이전 평가에서 RAG가 에이전트형 메모리에 뒤졌다는 결과가 있다.
1.2 예비 실험 1: Mem0의 변경 연산 감사
저자들은 Mem0를 LoCoMo 전체 대화와 LongMemEval 500개 예시에서 감사했다. 쓰기 결정 중 UPDATE와 DELETE의 합은 LoCoMo 33,902개 중 4.39%, LongMemEval 428,858개 중 2.46%다(Figure 2). 세부 값은 다음과 같다.
| 쓰기 결정 | LoCoMo (n=33,902) | LongMemEval (n=428,858) |
|---|---|---|
| ADD | 17.13% (5,806) | 24.51% (105,093) |
| NONE | 78.48% (26,607) | 73.04% (313,236) |
| UPDATE | 3.39% (1,148) | 2.30% (9,864) |
| DELETE | 1.01% (341) | 0.16% (665) |
많은 제안된 update는 중복이거나 형식이 잘못되었다. 저장된 텍스트가 실제로 바뀐 update나 삭제인 effective mutation은 LoCoMo 1.90%, LongMemEval 1.34%였다(모든 emitted decision 대비, decision 가중 평균). 대화별로는 LoCoMo 10개에서 제안 비율 중앙값 4.32%(범위 3.21–5.82), LongMemEval 500개에서 중앙값 2.41%(범위 0.59–4.42)로 보고된다.
1.3 예비 실험 2: UPDATE→ADD, DELETE→NONE
UPDATE를 append-only ADD로, DELETE를 NONE으로 바꾼 정책의 LoCoMo 정확도(범주 5 adversarial 제외)는 다음과 같다(Table 1).
| 범주 | 전체 변경 정책 | ADD/NONE만 | Δ |
|---|---|---|---|
| Multi-hop | 63.24 | 64.66 | +1.42 |
| Temporal | 49.74 | 53.06 | +3.32 |
| Open-domain | 53.47 | 60.42 | +6.94 |
| Single-hop | 77.05 | 78.28 | +1.23 |
| Overall | 67.36 | 69.42 | +2.06 |
논문은 이 구성에서 명시적 변경이 정확도 이득을 주지 않았다고 쓰며, 어떤 범주 점수도 낮아지지 않았다고 보고한다.
1.4 예비 실험 3: MEME phase-visible oracle
MEME(정확 회상, 집계, 추적, 삭제, 연쇄, 무효화)에서 reader가 질문 시점에 보이는 증거를 시간순으로 모두 받는 설정으로, 검색 오류를 제거하되 상태 변화는 reader가 풀어야 한다(Table 2, 정확도 %).
| Task | GPT-4o-mini | DeepSeek-V4-Flash | Qwen3.5-35B-A3B |
|---|---|---|---|
| ER | 98.00 | 99.00 | 97.00 |
| Agg | 47.00 | 63.00 | 56.00 |
| Tr | 81.00 | 92.00 | 89.00 |
| Del | 39.00 | 86.00 | 46.00 |
| Cas | 1.83 | 82.32 | 39.63 |
| Abs | 36.15 | 91.54 | 93.85 |
| Overall | 50.50 | 85.48 | 70.25 |
DeepSeek-V4-Flash는 연쇄 82.32%, 무효화 91.54%에 도달한다. 저자들은 reader 사이의 차이가 크지만 어려운 상태 전이도 충분한 raw 증거에서 해결될 수 있다고 해석한다.
1.5 이전 RAG 평가 검토와 기여
저자들은 14개 선행 연구를 검토해 일부 평가 baseline에서 거친 검색 단위, 제한된 검색 깊이, reranking 부재가 보인다고 정리한다(부록 E, 9.6절에서 상세). 이로써 보고된 격차가 에이전트형 메모리의 필요성인지 선택된 검색 baseline의 약점인지 열려 있다고 본다. 기여는 세 가지로 요약된다: 명시적 변경의 필요성에 의문을 제기, Raw-RAG를 강한 기준선으로 제시, 증거 접근과 관계 완전성을 병목으로 식별.
2. Raw-RAG 파이프라인
2.1 인덱싱
Raw-RAG는 LLM 기반 추출, 요약, 그래프 구성, 변경 없이 원문 기록을 색인한다(본문 §3, 부록 B.1).
- 기록
H=(m_1,\dots,m_T)의 각 메시지는 날짜, 화자, 내용으로 표현된다. 날짜가 없으면 unknown으로 표기하고, 이미지 캡션은 텍스트로 포함한다. - 대화를 메시지 타임스탬프와 함께 직렬화해 길이 256 token, stride
256-32=224인 창으로 나눈다(GPT-4 tokenizer 기준). - 각 창은 원래 메시지와 연결되어, reader에게 줄 증거를 만들 때 완전한 turn을 복원할 수 있다.
- 창은 임베딩되어 flat index에 들어가며, 원문 창 텍스트는 reader 증거로 유지된다. 인덱스는 대화 단위로 만들어진다.
2.2 질의 시점 검색
질문 q에 대해 임베딩 인코더 e가 후보 집합을, cross-encoder reranker r(Nogueira & Cho, 2019)이 reader 증거를 고른다(식 2, 3).
D_q = \mathrm{Top}_{128}\{\cos(e(q), e(c)) : c \in \mathrm{chunks}(H)\}S_q = \mathrm{Top}_{15}\{r(q,c) : c \in D_q\}검색 쿼리는 벤치마크가 준 원래 질문이며, 같은 질문 텍스트가 인코더와 reranker 모두에 쓰인다. 질문 날짜나 평가 phase가 있으면 증거 가시성을 결정한다. Qwen3 reranker는 "질문과 passage가 주어졌을 때 passage에 답에 관련된 정보가 있는지 판단하라"는 지시 템플릿에 질문과 후보를 넣어 yes/no로 판정한다.
2.3 증거 조립과 reader
선택된 15개 창은 질문과 함께 reader에게 전달되고, 시간 순서와 상태 변화의 해석은 reader가 수행한다. turn expansion이 켜진 경우 각 창은 겹치는 완전한 source turn으로 렌더링되며, 이는 reader가 보는 텍스트만 바꾸고 선택 점수는 바꾸지 않는다. 기본 설정에서는 선택된 창들에 반복된 turn도 포함된다(중복 제거는 별도 ablation). Top-15는 항목 수를 제한할 뿐이며 실제 토큰 길이는 헤더, 겹침, expansion에 따라 달라진다.
2.4 벤치마크별 적응
- MEME: 관련성으로 선택한 뒤 청크를 원래 순서(시간순)로 제시한다. 32k 토큰 distractor 조건을 쓰고, before/after 질문은 해당 phase의 증거만 쓴다.
- MemoryAgentBench: display-time turn expansion을 끈다. 두 FactConsolidation 소스에서는 각 사실을 하나의 메시지로 보고 청크당 완전한 메시지 하나, 겹침 없음으로 색인하며 일련번호 단서를 보존한다. 나머지 소스는 token-window 설정이다.
- 임베딩·reranker: LoCoMo·LongMemEval은 비교 설정에 맞춰 text-embedding-3-small+Cohere Rerank-v3.5 또는 Qwen3-Embedding-4B+Qwen3-Reranker-4B(Zhang et al., 2025)를 쓰고(부록 A), MemoryAgentBench 메모리 관리 ablation은 text-embedding-3-small과 동일 cross-encoder를 쓴다(부록 C.3).
2.5 길이 정책
주 조건에는 별도의 증거 토큰 상한이나 expansion 이후의 자동 head–tail clipping이 없다. 7개 주요 benchmark–model 조건에서 저장된 reader 증거는 조립된 검색 증거와 같고, 답 생성 오류 응답은 기록되지 않았다. 증거 길이(Table 20, o200k_base 기준)는 다음과 같다.
| Benchmark | N | 평균 | 중앙값 | P95 | 최대 | 5,000 초과 |
|---|---|---|---|---|---|---|
| LoCoMo | 1,540 | 4,778.8 | 4,778.0 | 4,966.1 | 5,177 | 41 |
| LongMemEval | 500 | 11,355.6 | 11,248.5 | 13,915.3 | 27,375 | 500 |
| MEME | 1,188 | 11,986.1 | 10,186.0 | 21,329.6 | 42,490 | 1,188 |
| MemoryAgentBench | 2,071 | 3,915.8 | 4,173.0 | 4,209.5 | 4,262 | 0 |
선택된 청크 본문의 평균 길이는 LoCoMo 3,734.9, LongMemEval 3,784.9, MEME 3,813.3, MemoryAgentBench 3,550.5 token이며, 표 20의 더 큰 평균은 expansion과 포맷팅 때문이다.
2.6 Figure 3: 파이프라인 비교
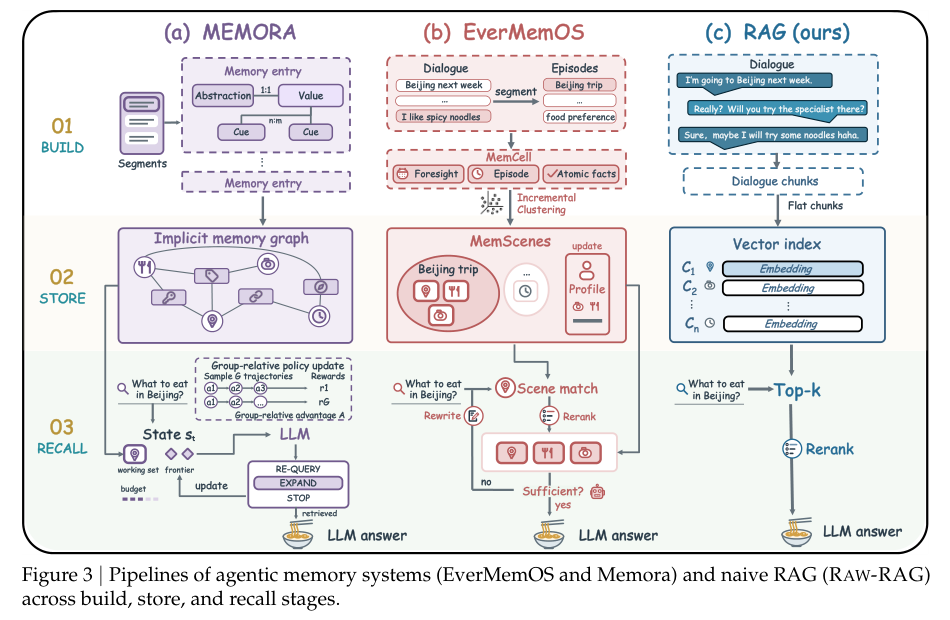
그림 1. EverMemOS, Memora 같은 에이전트형 메모리와 Raw-RAG를 build, store, recall 단계로 나란히 비교한 원논문 Figure 3. 출처: Bao et al. (2026), arXiv:2610.30755v1, Figure 3, PDF p.4. 연구·학습 목적 인용.
그림의 패널 (c)가 Raw-RAG로, 대화 청크를 임베딩해 vector index에 저장하고 질문에 대해 재순위화한 청크로 LLM이 답한다. 패널 (a), (b)는 MemCell·Episode·Foresight·MemScenes를 쓰는 EverMemOS와 abstraction·value·cue 구조의 Memora를 보여 준다.
3. 비교한 메모리 시스템
3.1 기준 범주
논문은 "agentic memory system"을 고정된 raw-history 검색 파이프라인을 넘어 에이전트적 콘텐츠 처리, 구조적 조직, 검색 제어를 갖춘 시스템의 포괄 용어로 쓴다(각주 1). 관련 연구는 경험 스트림을 요약·반성하는 방식, 계층 저장소와 읽기–쓰기 인터페이스, 사실 추출과 변경 또는 진화하는 그래프, 계층·순환 저장소의 통합, 사건 수준과 추상 표현의 선택적 구성으로 정리된다. 병행 연구 ReFind(Li et al., 2026)는 raw chat log를 보존하고 에이전트에게 반복 어휘 검색을 주는데, 본 논문은 고정된 dense retrieval+reranking으로 증거 접근만 분리해 평가한다고 서술한다.
3.2 구성 요약
부록 D.3이 정리한 주요 시스템의 구성이다.
| 시스템 | 메모리 구성 | 검색·읽기 설정 |
|---|---|---|
| EverMemOS (C. Hu et al., 2026) | 일관된 MemCell로 분할, episodic 표현·atomic fact 추출, 점진적 profile 추출 활성화 | 어휘+의미 검색, 질의 정제와 충분성 확인, 기본 10개 결과 |
| MemOS (Li et al., 2025) | 추출된 텍스트 메모리와 preference, fine-grained extraction | fine 검색 모드, 상위 20개, reranking, MMR 중복 제거. ICL 소스에서는 라벨 매핑 원문 청크 최대 5개 추가 |
| EMem / EMem-G (Zhou & Han, 2025) | elementary discourse unit(EDU) 추출. EMem-G는 그래프 검색(personalized PageRank) | 기본 QA budget 10, MEME·MemoryAgentBench는 20. ICL에는 원문 시연 청크 추가 |
| SimpleMem (Liu et al., 2026) | 40개 메시지 창(2개 겹침)을 구조화된 메모리 항목으로 변환 | 의미·키워드·구조 채널(25/5/5), 계획, 최대 2회 reflection, 최대 20개 항목 |
| MemU | profile, event, knowledge, behavior 항목 추출 | 의도 라우팅과 충분성 확인, 결과 상한 20(MemoryAgentBench 10) |
| MemMachine (Wang et al., 2026) | source에 근거한 episodic 메모리와 추출된 semantic 메모리 | 에피소드·요약·semantic 특징을 별도 섹션으로 제시, episodic·semantic 목록은 각각 상위 20개, 날짜 필터는 undated semantic 특징을 거르지 못함 |
| Mem0 (Chhikara et al., 2025) | 후보 사실 추출 후 ADD/UPDATE/DELETE/NONE 선택 | 화자별 관점, 검색 identity당 상위 20개, 시간 필터링 후 reader에 전달 |
| Memora (Xia et al., 2026) | 저장 값과 색인된 primary abstraction·cue anchor를 분리 | 최대 5단계 prompted-policy retriever, cue 색인·BM25 혼합·episodic 메모리, 출력 상위 20개 |
| Full-context | 변형·검색 없음 | 가시 이력을 시간순으로 직접 전달, 로컬 평가는 128,000 token 예산 안에서 앞뒤를 보존해 절단 |
Nemori(Nan et al., 2025), MemoryOS(Kang et al., 2025), A-MEM(Xu et al., 2025), RecMem(Dai et al., 2026)은 일부 설정에서 게시된 점수를 인용한다(부록 A; 3.3절). 다만 모든 시스템은 자체 구성의 메모리 구성·검색을 쓰고, 선택된 증거를 reader가 정해진 프롬프트 조건에서 답한다.
3.3 점수의 출처
부록 A는 "게시된 baseline 점수는 유지하고 Raw-RAG 결과는 본 연구에서 측정했다"고 명시한다. LoCoMo·LongMemEval에서는 해당 비교의 설정에 맞춰 Raw-RAG를 정렬해 평가한다(예: Cohere Rerank-v3.5, Qwen3 embedding/reranker). MEME과 MemoryAgentBench에서는 모든 시스템이 동일한 평가 절차를 따른다. 일부 시스템은 직접 평가한다(SimpleMem, MemMachine, GPT-4o-mini Memora는 LoCoMo 비교에서 본 연구에서 평가, GPT-4.1-mini Memora는 게시된 policy-retriever 값). 논문은 게시된 비교 점수가 각 연구의 환경에서 얻은 것이라고 밝힌다(부록 D.7).
4. 벤치마크와 평가 지표
4.1 네 벤치마크
| 벤치마크 | 규모 | 평가 대상 |
|---|---|---|
| LoCoMo (Maharana et al., 2024) | 10개 대화, 비적대 질문 1,540개(single-hop 841, multi-hop 282, temporal 321, open-domain 96) | 매우 긴 대화 기억. 범주 5 adversarial 제외 |
| LongMemEval (Wu et al., 2025) | 500개 예시 | 회상, 시간 추론, 선호, 갱신. single-session user/assistant/preference, multi-session, knowledge update, temporal reasoning |
| MEME (Jung et al., 2026) | 100개 episode, phase별 질문 1,188개(before 494, after 694) | 동적 메모리 갱신과 복잡한 의존 이해: ER, Agg, Tr, Del, Cas, Abs |
| MemoryAgentBench (Y. Hu et al., 2026) | 14개 소스, 질문 2,071개 | Accurate Retrieval, Test-Time Learning, Long-Range Understanding, Conflict Resolution |
MemoryAgentBench의 구성은 AR(LongMemEval 대화, EventQA, RULER QA 두 소스), TTL(Banking77, CLINC150, NLU, TREC-coarse, TREC-fine 분류와 ReDial 추천), LRU(DetectiveQA, InfBench 요약), CR(single-hop·multi-hop FactConsolidation, 큰 일련번호가 최신)이다. 부록에는 PersonaMem-v2(Jiang et al., 2025; 32k 이력, 5,000개 객관식, 9개 시나리오)와 BEAM(Tavakoli et al., 2026; 1,710개 메시지, 약 100만 token 대화의 수집 시간 측정)도 쓰인다.
4.2 점수 산정
- LoCoMo: 이진 정답 판정을 질문과 judge 반복에 걸쳐 평균한다. GPT-4o-mini judge를 답마다 세 번 호출한다(질문 가중 평균).
- LongMemEval: 질문 가중 정확도.
- MEME: 6개 task의 macro-average. 삭제·연쇄·무효화는 before 단계 gate를 포함한다.
- MemoryAgentBench: 네 capability macro의 평균. TTL은 5개 ICL 소스 macro와 ReDial을 평균한다.
- 표에서 굵게 표시한 열별 최대값은 Full-context를 제외한다. Full-context는 context 길이 제한 때문에 MemoryAgentBench에서 사용할 수 없다(표 4의 대시).
4.3 reader
본문 조합은 LoCoMo의 GPT-4o-mini와 GPT-4.1-mini, LongMemEval의 GPT-4.1-mini, MEME과 MemoryAgentBench의 GPT-4o-mini와 DeepSeek-V4-Flash다. 이 일곱 조합이 이후 "7개 benchmark–model 설정"이다. MEME phase-visible oracle(표 2)에는 Qwen3.5-35B-A3B도 사용된다.
4.4 통계 방법
ablation은 source 층화 paired bootstrap(20,000 resample)과 Holm 보정을 쓴다. Coverage·utilization의 전체 비교는 Cochran's Q(MemoryAgentBench coverage)와 중심화한 max-range bootstrap을 쓰고, pairwise는 exact McNemar와 two-sided bootstrap sign test(MEME은 episode-clustered)를 쓴다. 재표집 단위는 벤치마크 구조(질문 또는 episode)를 따르며, 한 답에 대한 반복 판정은 함께 묶인다.
5. 주요 결과와 지는 설정
5.1 LoCoMo와 LongMemEval (Table 3)
LoCoMo 전체 정확도(%)에서 상위 시스템은 다음과 같다.
| 시스템 | GPT-4o-mini | GPT-4.1-mini |
|---|---|---|
| Raw-RAG | 89.07 | 93.70 |
| MemMachine | 88.12 | 91.69 |
| EverMemOS | 86.76 | 93.05 |
| Memora | 80.61 | 86.30 |
| Full-context | 72.30 | 80.60 |
Raw-RAG의 앞섬은 GPT-4o-mini에서 MemMachine 대비 0.95점, GPT-4.1-mini에서 EverMemOS 대비 0.65점이다. 범주별로는 GPT-4o-mini에서 single-hop 94.57과 temporal 82.04가 열 최대이나 multi-hop은 EverMemOS(86.17 대 85.93), open-domain은 MemMachine(73.96 대 73.61)이 높다. GPT-4.1-mini에서는 single-hop 96.79, multi-hop 92.32, open-domain 80.21이 열 최대이고 temporal은 MemMachine(91.59 대 90.86)이 높다.
LongMemEval(GPT-4.1-mini) 전체는 Raw-RAG 87.53, Memora 87.40(0.13점 차), EverMemOS 83.00, EMem 83.00, Full-context 65.60이다. 범주별로는 Raw-RAG가 S-U 100.00, S-P 100.00(MemoryOS와 동률)에서 열 최대이나, Memora가 multi-session(78.20 대 77.69), KU(97.40 대 91.03), TR(89.50 대 81.45)에서 Raw-RAG를 넘는다(표 15).
5.2 MEME과 MemoryAgentBench (Table 4)
| 설정 | Raw-RAG | 최강 비교 메모리 시스템 | 차이 | Full-context |
|---|---|---|---|---|
| MEME, GPT-4o-mini | 39.30 | MemMachine 37.06 | +2.24 | 29.31 |
| MEME, DeepSeek-V4-Flash | 43.19 | MemMachine 44.71 | −1.52 | 63.17 |
| MemoryAgentBench, GPT-4o-mini | 48.32 | Memora 43.84 | +4.48 | 사용 불가 |
| MemoryAgentBench, DeepSeek-V4-Flash | 53.41 | Memora 47.88 | +5.53 | 사용 불가 |
따라서 Raw-RAG는 7개 설정 중 6개에서 Full-context를 제외한 메모리 시스템 중 1위이고, 리드는 LoCoMo 0.65–0.95, LongMemEval 0.13, GPT-4o-mini MEME 2.24, MemoryAgentBench 4.48–5.53점이다. 논문은 단순한 수집 절차에도 이들 과제에서 경쟁력이 있다고 요약한다.
5.3 지는 설정: DeepSeek-V4-Flash MEME
본문이 명시하는 유일한 비1위 설정이다. MemMachine이 메모리 시스템 중 1.52점(44.71 대 43.19) 앞서고, Full-context는 19.98점(63.17 대 43.19) 앞선다. 과제별로 DeepSeek 조건에서 Raw-RAG는 ER 100.00(MemMachine과 동률)과 Tr 87.00(EMem과 동률)이지만, 집계는 EMem 36.00 대 21.00, 삭제는 MemMachine 48.00 대 29.00, 연쇄는 Memora 9.15 대 3.66, 무효화는 Memora 20.00 대 18.46으로 다른 시스템이 높다.
GPT-4o-mini MEME에서도 Raw-RAG는 전체 1위지만 과제별로는 집계(EMem 36.00 대 19.00), 삭제(EMem 37.00 대 26.00), 연쇄(Mem0 7.32 대 4.27), 무효화(EMem 12.31 대 11.54)에서 다른 시스템이 높다. 연쇄 점수는 Full-context DeepSeek(48.17)을 제외하면 모든 시스템에서 10% 미만이다.
MemoryAgentBench에서도 capability별 최대는 나뉜다. GPT-4o-mini에서 AR은 Memora 68.78(Raw-RAG 67.85), TTL은 EMem 49.07(47.68), LRU는 MemOS 33.13(31.74)이 높고 CR만 Raw-RAG 46.00이 최대다. DeepSeek에서는 TTL은 EverMemOS 51.02, LRU는 MemMachine 44.09가 Raw-RAG(50.39, 33.48)보다 높다.
5.4 부록의 정렬된 설정 (Tables 10–18)
- LoCoMo, text-embedding-3-small + Cohere Rerank-v3.5: Raw-RAG 89.07(GPT-4o-mini)과 93.70(GPT-4.1-mini). 전체는 최대이며, 범주별로는 GPT-4o-mini open-domain(MemMachine 73.96 대 73.61)과 GPT-4.1-mini temporal(MemMachine 91.59 대 90.86)에서 MemMachine이 높다(표 10).
- LoCoMo, Qwen3 검색: Raw-RAG 89.13 / 94.55, EverMemOS 86.76 / 93.05, Zep(Rasmussen et al., 2025) 81.06 / 85.22(표 11). GPT-4o-mini temporal에서는 EverMemOS 81.93이 Raw-RAG 79.96보다 높다.
- LongMemEval Qwen3: Raw-RAG 89.93, EverMemOS 83.00, MemOS 77.80(표 16). 비-abstention 470문항: Raw-RAG textemb3 87.80, Qwen3 90.57, EMem 83.00, EMem-G 84.90(표 17; 두 Raw-RAG 설정의 전체 500문항 점수는 87.53, 89.93이며 30개 abstention 문항을 제거해 다시 계산).
- 짧은 답 평가(LoCoMo, 표 12–14): Raw-RAG(minimal)의 LLM-judge 정확도는 GPT-4o-mini 85.78, GPT-4.1-mini 90.87이고 F1은 52.58 / 49.57, BLEU-1은 44.50 / 41.35다. GPT-4.1-mini 조건의 F1(49.57)과 BLEU-1(41.35)은 표에 게시된 Nemori 값(53.40, 45.60)보다 낮다. 표의 RAG baseline(Mem0 논문 60.97, Nemori 논문 30.20과 32.90)은 각 원 논문의 구성이다. 논문은 Mem0 게시 범주 점수의 질문 가중 평균(62.14)이 게시된 전체 점수 66.88과 달라 둘을 재계산 없이 그대로 보존했다고 밝힌다.
- PersonaMem-v2 (표 18): Raw-RAG 49.62%(2,481/5,000)로 7개 시스템 중 3위, MemOS(50.72)와 EverMemOS(53.25) 뒤이며 어느 시나리오에서도 1위가 아니다. Raw-RAG는 persona profile을 쓰지 않고 EverMemOS는 profile이 활성화된 파이프라인을 쓴다. 저자들은 유의성이 검정되지 않았다고 쓴다.
6. 설계 ablation, 메모리 관리 추가, 효율
6.1 RQ1: 왜 이 설계인가 (Table 5, Figure 4, Table 19)
MemoryAgentBench(GPT-4o-mini)에서 reranking, 검색 깊이, 청크 크기를 따로 바꾼 결과다. Total은 4개 capability 평균이다.
| 설정 | AR | TTL | LRU | CR | Total | Δ [95% CI] |
|---|---|---|---|---|---|---|
| Raw-RAG 기본 | 67.85 | 47.68 | 31.74 | 46.00 | 48.32 | – |
| −reranker | 59.13 | 44.29 | 29.66 | 44.50 | 44.40 | −3.92 [−5.80, −2.06] |
| 청크 128/16 | 70.50 | 46.89 | 28.93 | 46.00 | 48.08 | −0.24 [−1.54, +1.05] |
| 청크 512/64 | 65.68 | 49.27 | 32.49 | 46.00 | 48.36 | +0.04 [−1.15, +1.25] |
| 청크 1024/128 | 66.28 | 48.08 | 31.79 | 46.00 | 48.04 | −0.28 [−1.76, +1.19] |
| + display-turn dedup | 68.27 | 37.69 | 31.75 | 46.00 | 45.93 | −2.39 [−3.53, −1.28] |
reranker 제거는 Total을 3.92점 낮추고(pHolm = 0.0012), 청크 128–1,024는 Total을 유의하게 바꾸지 않는다. 최종 k에 대한 결과(Table 19)는 다음과 같다.
최종 k |
1 | 5 | 10 | 15 | 30 | 60 | 120 |
|---|---|---|---|---|---|---|---|
| Total | 36.59 | 47.10 | 47.57 | 48.32 | 48.10 | 47.91 | 33.74 |
| Δ | −11.73 | −1.21 | −0.75 | – | −0.22 | −0.41 | −14.57 |
k=1 구간은 [−14.05, −9.43], k=120 구간은 [−16.83, −12.34]이고, 5·10·30·60은 기본값의 1.3점 이내다. top-120의 손실은 LRU와 CR에서 주로 나온다. 부록은 top-60이 LRU를 2.22점 올리고(Holm 보정 p = 0.025, 해당 과제 군 내) 하나의 전역 컨텍스트 크기가 모든 능력에 최적일 필요는 없다고 적는다. 저자들은 이 결과가 reranking과 적당한 검색 깊이를 지지하며 정확한 기본 청크 크기나 k를 요구하지는 않는다고 해석한다.
6.2 RQ2: 메모리 관리를 더하면 좋아지는가
기존 청킹·임베딩·reranker를 재사용하며 색인 표현이나 후보 집합만 바꾼 세 변형이다(부록 C.3, 추출·요약 호출은 gpt-4o-mini-2024-07-18, temperature 0).
- Atomic facts: 창마다 최대 6개 사실(사실당 28단어 이하, 근거 인용 12단어 이하)을 추출하고, 원문 창을 검색 색인에서 사실 항목으로 대체한다. 원문 창은 reader 증거로 제시되지 않는다.
- Raw summary: 창마다 5개 필드 요약(밀집 요약, 순서 있는 사건, 개체, 시간·일련번호 단서, 충돌·갱신)을 만들어 원문 창과 함께 색인한다. 요약은 원문을 대체하지 않고 보강한다.
- Graph-expanded raw: 노드는 원문 창이다. 새 창마다 앞선 창 최대 10개와 임베딩 유사도를 비교하고 LLM이 관련 있는 것만 연결한다. 질의 시 32개 seed 창과 모든 1-hop 이웃을 후보로 확장한 뒤 원문 창을 rerank해 상위 15개를 보여 준다.
| 변형 | AR | TTL | LRU | CR | Total | Δ [95% CI] |
|---|---|---|---|---|---|---|
| + Atomic facts | 57.25 | 15.37 | 21.17 | 21.00 | 28.70 | −19.62 [−21.99, −17.21] |
| + Raw summary | 67.53 | 45.89 | 29.62 | 27.00 | 42.51 | −5.81 [−7.70, −3.90] |
| + Graph-expanded | 65.42 | 46.49 | 31.74 | 26.50 | 42.54 | −5.78 [−7.50, −4.07] |
세 변형 모두 같은 14개 소스 Total에서 Raw-RAG(48.32)를 넘지 못한다. 저자들의 해석은 다음과 같다. Atomic fact는 TTL을 47.68에서 15.37로 낮추며 이는 사용 가능한 시연의 손실이나 훼손과 일치한다. Summary 보강은 AR을 대체로 유지하지만 CR에서 주로 잃고, graph 확장은 LRU에서 Raw-RAG와 같으나 전체가 5.78점 낮다.
부록 F는 TTL 하락의 해석에 단서를 단다. 분류 시연은 사실 내용, 입출력 쌍, 예시 경계, 표시 형식이 필요하고, 하락은 고정 항목 수에서 증거량의 감소, 시연 구조의 훼손, reader–형식 불일치를 사실 손실과 함께 반영할 수 있다. 이 결과는 "시험한 표현과 reader 조합이 TTL에서 성능이 낮다"는 것을 보인다고 서술한다.
6.3 5,000 토큰 증거 통제 (Tables 21–24)
교차 시스템 통제. 각 시스템의 검색된 증거를 고정하고 형식화된 reader 증거에 5,000-token 상한을 적용했다(완전한 항목의 접두부 유지, 첫 항목만 너무 길면 token 접두부 절단). 6개 시스템, 14개 소스, 시스템당 2,071개 질문이며 Mem0·MemOS는 이전의 hosted 설정이다. 84개 system–source 조건 중 44개는 clipping 후 답과 평가를 새로 만들었다.
| 시스템 | 기본 평균 길이 | 5k 평균 | 잘린 질문 | Overall (5k) | Native | Δ |
|---|---|---|---|---|---|---|
| Raw-RAG | 3,915.8 | 3,915.8 | 0 | 48.32 | 48.32 | 0.00 |
| Mem0 | 3,572.8 | 1,961.3 | 500 | 44.74 | 45.27 | −0.53 |
| EMem | 2,637.7 | 1,417.7 | 511 | 37.60 | 38.44 | −0.84 |
| EverMemOS | 15,394.8 | 4,160.6 | 2,011 | 33.73 | 36.49 | −2.76 |
| MemMachine | 26,296.9 | 4,479.2 | 2,030 | 31.64 | 35.53 | −3.89 |
| MemOS | – | – | – | 33.90 | 34.18 | −0.28 |
Raw-RAG는 가장 긴 입력이 4,262 token이라 clipping이 필요 없고 5k 상한에서도 48.32로, 이 통제에서 가장 강한 baseline(Mem0 44.74)을 앞선다. 다섯 baseline의 Overall은 모두 낮아졌으나 일부 소스는 개선된다. 저자들은 clipping이 유용한 항목을 지우거나 형식을 깨뜨릴 수 있고 모든 시스템이 원래 튜닝을 쓴다고 단서를 단다. 클리핑 로그는 변경된 system–question 컨텍스트 5,545개(첫 항목 절단 1,479개)를 기록한다.
Raw-RAG 단독 통제 (Table 23). 선택된 상위 15개 청크와 순서를 고정하고, 초과 질문에서는 먼저 turn expansion을 꺼서 원 창 텍스트를 보여 준다. 이것만으로 모든 초과 질문이 상한에 들어와 15개 청크가 모두 유지되었다.
| Benchmark | N | 변경된 컨텍스트 | 5k 평균 | Native | 5k | Δ |
|---|---|---|---|---|---|---|
| LoCoMo (GPT-4o-mini) | 1,540 | 41 | 4,753.5 | 89.07 | 89.42 | +0.35 |
| LongMemEval (GPT-4.1-mini) | 500 | 500 | 4,144.4 | 87.53 | 89.20 | +1.67 |
| MEME (GPT-4o-mini) | 1,188 | 1,188 | 4,173.1 | 39.30 | 38.21 | −1.09 |
모든 답과 평가를 재생성했으므로 점수 변화에는 reader·judge 변동이 포함되고, 유의성과 동등성은 검정되지 않았다. LoCoMo에서는 변경된 41개 컨텍스트의 기여가 +0.065점, 변경되지 않은 1,499개의 기여가 +0.281점이다. 저자들은 따라서 관측된 이득의 대부분이 증거가 바뀌지 않은 질문에서 나왔다고 쓴다. 5k 점수는 원래 baseline 점수 대비 LoCoMo 1.30점(MemMachine), LongMemEval 1.80점(Memora), MEME 1.15점(MemMachine) 앞서며, 범주별로는 LongMemEval multi-session과 MEME의 집계·삭제·연쇄에서 EMem 등에 뒤진다(표 24). 다른 baseline은 이 정책으로 재실행되지 않았고, 다른 시스템과의 비교는 원래 점수와 증거 예산을 그대로 쓴다.
6.4 RQ3: 효율 (Table 6, Table 32, Figure 1)
MemoryAgentBench의 비충돌 11개 소스에서 세 변형이 요구하는 비용(표 32)은 LLM token 21.6–109.3M, Add+Search 시간 2.9–8.8시간이고, Raw-RAG는 12분이다. 변형별로는 Atomic facts 40,248 호출, 46.3M token, 총 31,673.8초, Raw summary 32,144 호출, 21.6M token, 10,327.5초, Graph-expanded는 33,748 호출, 109.3M token이다.
MEME의 10개 episode, 110개 질문 구간에서 Add→ready와 Search 합계(답 생성·평가 제외, 외부 worker 하나)는 다음과 같다.
| 시스템 | Add→ready (s) | Search (s) | Total (s) |
|---|---|---|---|
| EverMemOS | 8217.69 | 1083.79 | 9301.48 |
| Mem0 | 4025.23 | 117.72 | 4142.95 |
| MemMachine | 3104.35 | 411.39 | 3515.74 |
| MemOS | 2591.59 | 177.97 | 2769.56 |
| EMem | 1082.37 | 479.59 | 1561.97 |
| Raw-RAG | 50.32 | 255.59 | 305.91 |
Raw-RAG는 다음으로 빠른 시스템보다 5.1배, EverMemOS보다 30.4배 빠르다. Search 단독 시간으로는 Mem0(117.72초)와 MemOS(177.97초)가 Raw-RAG(255.59초)보다 짧다. BEAM-1M(1,710개 메시지) 순차 수집에서 최종 누적 Add 시간은 Raw-RAG 0.33시간, MemOS 3.25시간(완료한 다음으로 빠른 실행), Memora 26.95시간이다. 이 구간에는 6개의 완료된 순차 실행이 포함되고 답 생성과 평가는 제외된다.
6.5 Figure 1
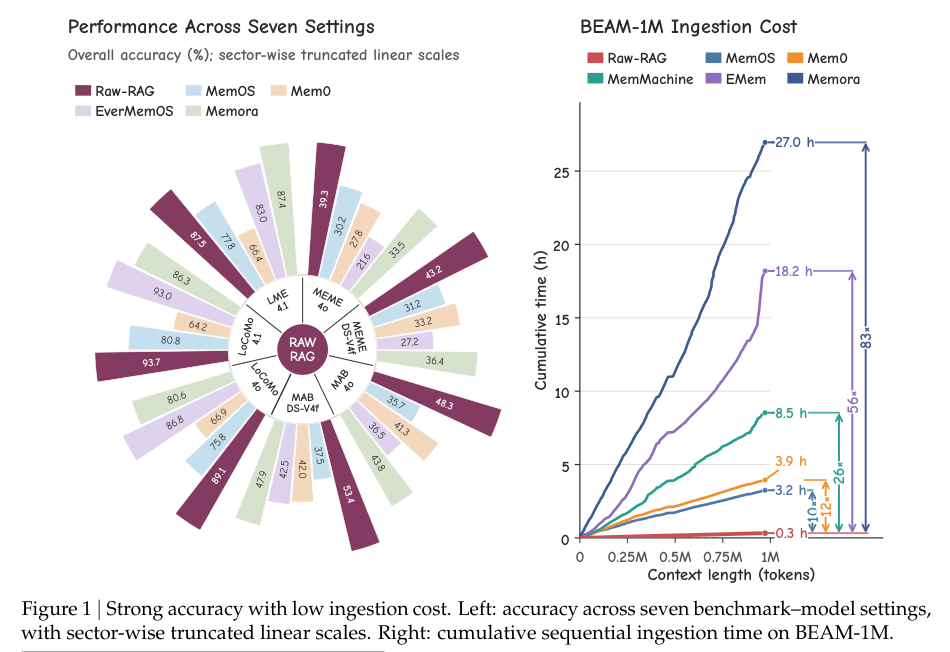
그림 2. 7개 benchmark–model 설정의 정확도(왼쪽, sector별로 절단된 선형 척도)와 BEAM-1M의 누적 순차 수집 시간(오른쪽)을 보여 주는 원논문 Figure 1. 출처: Bao et al. (2026), arXiv:2610.30755v1, Figure 1, PDF p.1. 연구·학습 목적 인용.
본문(§4.3)이 보고한 수집 시간은 Raw-RAG 0.33시간, MemOS 3.25시간, Memora 26.95시간이다. 그림에는 이 밖에 MemMachine, EMem, Mem0의 누적 곡선도 포함된다.
7. 증거 coverage와 reader utilization
7.1 정의
Raw-RAG가 더 나은 증거를 주는지, reader가 증거를 더 잘 쓰는지를 분리하기 위해 두 양을 정의한다(부록 C.1). 질문 i, 시스템 s에 대해 C_{is}\in{0,1}은 평가된 증거 충분성, Y_{is}\in[0,1]은 평가된 답 점수다.
\hat C_s = \frac{1}{N}\sum_i C_{is}, \qquad \hat U_s = \frac{\sum_i C_{is}Y_{is}}{\sum_i C_{is}}Coverage는 충분한 증거가 검색된 질문 비율이고, utilization은 충분한 증거가 있는 질문에서의 정답률이다. 충분한 집합이 비면 utilization은 정의되지 않으며, 곱 \hat C_s \hat U_s는 충분한 증거가 있는 질문이 기여한 점수다. 충분한 집합 밖의 정답은 충분성 라벨 오류, 부분 증거, 사전 지식, 추측일 수 있다. 판정은 MemoryAgentBench에서 LLM judge의 의미적 충분성이고, MEME에서는 과제별 결정론적 검사다(ER은 목표 값, Agg는 모든 집계 값, Tr은 시간순서, Del은 명시적 삭제 사건, Cas는 새 목표·의존 규칙·상위 트리거, Abs는 옛 목표·의존·무효화 트리거). 저자들은 시스템별 질문 집합이 달라 reader의 통제된 비교는 아니라고 단서를 단다.
7.2 결과 (Tables 7, 8, 26)
| 시스템 | MAB Coverage | MAB Utilization | MEME Coverage | MEME Utilization |
|---|---|---|---|---|
| Raw-RAG | 45.29 | 84.43 | 76.35 | 73.76 |
| Mem0 | 40.03 | 82.39 | 63.22 | 65.51 |
| EMem | 34.72 | 89.71 | 50.08 | 86.55 |
| MemOS | 34.48 | 85.85 | 62.12 | 66.67 |
| EverMemOS | 25.11 | 80.00 | 47.64 | 76.86 |
| MemMachine | 21.54 | 84.30 | 70.37 | 82.66 |
| MemU | 19.07 | 89.37 | 35.69 | 84.20 |
Raw-RAG는 두 벤치마크에서 모두 coverage가 가장 높지만(45.29%, 76.35%), utilization은 최고가 아니다. MemoryAgentBench에서 coverage는 19.07–45.29%에 걸치지만 utilization은 80.00–89.71%에 머문다. MEME에서는 coverage 범위가 40.66점, utilization 범위가 21.04점이다. 저자들은 시스템 간 차이가 충분한 증거 공급에서 더 크고, 충분한 증거가 주어진 뒤의 정답에서는 더 작다고 해석한다.
Raw-RAG의 coverage 구간은 MemoryAgentBench 938/2071, [43.65, 46.93]이고 MEME 907/1188, [74.32, 78.31]이다. Utilization은 MAB 792/938 [82.15, 86.66], MEME 669/907 [70.98, 76.44]다. 이에 비해 MEME 최고 utilization인 EMem은 515/595, 86.55 [83.89, 89.15]다.
7.3 불확실성 분석 (Tables 25, 27, 28)
네 가지 전체 검정이 모두 귀무가설을 기각한다.
| 벤치마크 | 지표 | 통계량/범위 | p | Holm 유의 쌍(21쌍 중) |
|---|---|---|---|---|
| MemoryAgentBench | Coverage | Cochran's Q(6) = 897.802 | 1.12×10⁻¹⁹⁰ | 20 |
| MemoryAgentBench | Utilization | 9.71 pp | 6.00×10⁻⁵ | 7 |
| MEME | Coverage | 40.66 pp | 2.00×10⁻⁵ | 19 |
| MEME | Utilization | 21.04 pp | 2.00×10⁻⁵ | 17 |
두 벤치마크 모두 coverage에서 유의한 쌍이 utilization보다 많고 관측 범위도 더 넓다. 저자들은 coverage가 더 넓은 시스템 간 병목이며 utilization에도 유의한 변동이 있다고 정리한다.
Finding 1(원문). Evidence access is a major bottleneck: Raw-RAG는 충분한 증거를 더 자주 공급해 조건부 reader utilization이 낮은 것을 상쇄한다.
8. 답 값과 관계·의존 경로
8.1 분석 설계
원문 기록은 답 값만이 아니라 그 값을 도출하는 순서와 의존성도 보존할 수 있다. MEME의 추적(tracking)과 연쇄(cascade) after-state 질문에서 LLM이 두 가지를 따로 판정한다(부록 G.10). Result coverage는 필요한 답 값이 검색된 컨텍스트에 있는지이고, path coverage는 그 값에 더해 시간순서 또는 연결된 의존 규칙과 상위 트리거까지 완전한 지지 경로가 있는지다. P(\text{path}\mid\text{result})는 결과가 커버된 질문 중 경로까지 완전한 비율이다.
8.2 결과 (Table 9)
| 시스템 | Result | Path | P(path ∣ result) |
|---|---|---|---|
| Raw-RAG | 90.53 | 56.44 | 62.34 |
| MemMachine | 84.85 | 48.11 | 56.70 |
| EverMemOS | 78.03 | 39.02 | 50.00 |
| EMem | 76.52 | 37.88 | 49.50 |
| Mem0 | 81.06 | 38.64 | 47.66 |
| MemOS | 88.26 | 21.21 | 24.03 |
| MemU | 59.09 | 5.68 | 9.62 |
Raw-RAG가 result, path, 조건부 경로 보존 모두 최고이며 MemMachine이 조건부 56.70%로 뒤따르고 MemU는 9.62%에 그친다. MemOS는 result 88.26%로 높지만 path는 21.21%다. 논문은 답 값을 가져오는 시스템도 지지 관계를 보존하는 정도는 크게 다르다고 쓴다.
8.3 Finding 2
Finding 2(원문). Raw-RAG는 답 값과 그 값을 도출하는 시간적·의존 관계를 함께 보존할 때 가장 유용하다. 논문은 기여 항목에서 '답 값 검색이 충분한 지지 경로를 보장하지 않는다'는 점을 증거 접근·관계 완전성 병목으로 정리한다(p.3).
9. 변형된 메모리의 oracle 격차
9.1 세 조건 (§5.3, 부록 C.5)
검색이 놓친 것인지, 수집 단계의 변형으로 정보가 이미 사라진 것인지를 구분하기 위해 MEME에서 세 조건을 비교한다.
- Native (N): 각 시스템의 일반 검색과 readout.
- Complete-store oracle (C): 내보낸 phase-visible 저장 표현 전체에서 gold 정보를 이용해 선택한다.
- Raw-evidence control (R): 같은 gold 정보로 원래 주석된 지지 세션을 고른다.
C와 R은 값을 노출하지 않는 task 정책(phase, task 유형, 대상 식별자, 전이 의미 제공)과 5,000-token 포장 예산을 공유한다. 선택기는 gold 값과 정답, 개체 이름에서 만든 정규화 구문이 객체에 부분 문자열로 나타나는 정도와 질문 단어 겹침으로 객체를 점수화하며(식 5), 검색 유사도 항은 쓰지 않는다. gold 값은 오프라인 선택기만 안내하고 reader 컨텍스트에는 선택된 메모리 텍스트와 정책만 들어간다.
s(m)=\sum_{h\in H(m)}\bigl(4+\min(4,|h|/3)\bigr)+\frac{2\,|\mathrm{words}(m)\cap Q|}{\max(1,|Q|)}"complete"는 지속된 reader-visible 표현을 열거한다는 뜻이며, 최종 저장소에서 내보낸 것을 출처 메타데이터로 거르므로 덮어쓰이거나 삭제된 객체는 쓸 수 없다(EMem은 실제 before/after 스냅샷 사용). 이 제약은 Mem0에서 특히 크다고 부록은 적는다.
9.2 결과 (Table 29, Figure 5)
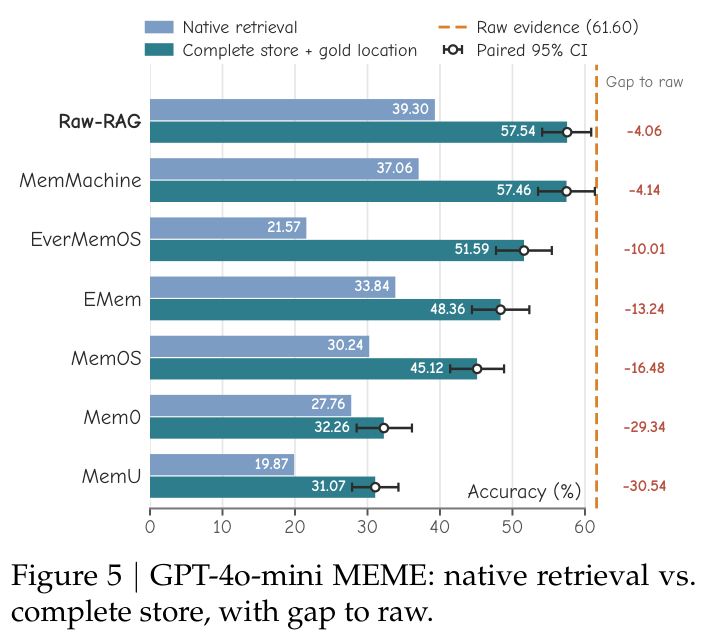
그림 3. GPT-4o-mini MEME에서 native 검색, complete-store 조건, raw evidence(61.60)와의 격차를 보여 주는 원논문 Figure 5. 출처: Bao et al. (2026), arXiv:2610.30755v1, Figure 5, PDF p.9. 연구·학습 목적 인용.
| 시스템 | N | C | R | C − N [95% CI] | R − C [95% CI] |
|---|---|---|---|---|---|
| Raw-RAG | 39.30 | 57.54 | 61.60 | +18.24 [14.78, 21.65] | +4.06 [0.74, 7.50] |
| MemMachine | 37.06 | 57.46 | 61.60 | +20.40 [17.30, 23.40] | +4.14 [0.23, 8.07] |
| EverMemOS | 21.57 | 51.59 | 61.60 | +30.02 [26.53, 33.47] | +10.01 [6.17, 13.87] |
| EMem | 33.84 | 48.36 | 61.60 | +14.52 [10.58, 18.42] | +13.24 [9.27, 17.19] |
| MemOS | 30.24 | 45.12 | 61.60 | +14.88 [11.04, 18.57] | +16.48 [12.76, 20.19] |
| Mem0 | 27.76 | 32.26 | 61.60 | +4.50 [1.75, 7.27] | +29.34 [25.47, 33.10] |
| MemU | 19.87 | 31.07 | 61.60 | +11.20 [8.48, 13.93] | +30.54 [27.33, 33.73] |
Complete-store oracle은 일곱 시스템 모두를 개선하지만 회복되는 정도는 저장 표현에 따라 다르다. 원문 대화 내용을 저장소에 유지하는 Raw-RAG와 MemMachine이 57.54%, 57.46%로 raw evidence(61.60%)에 가장 가깝고, 변형된 저장소는 격차가 크다(Mem0 −29.34, MemU −30.54). 논문은 이 결과가 수집 단계의 정보 보존이 이후 회복에서 하는 역할과 일치한다고 쓴다.
9.3 포장 상한 제거와 민감도 (Table 30)
5,000 token 포장 상한이 결과를 좌우하는지 보기 위해 상한을 제거했다(후보 집합, 선택기, 순서, task 정책, reader, 채점 고정).
| 조건 | 영향받은 질문 | 잘린 증거 비율 | C5k | C∞ | C∞ − C5k [95% CI] | R − C∞ [95% CI] |
|---|---|---|---|---|---|---|
| MemMachine | 1,172 | 83.39% | 57.46 | 54.02 | −3.44 [−6.49, −0.37] | +7.58 [3.03, 12.15] |
| Raw-RAG | 1,188 | 84.59% | 57.54 | 53.85 | −3.69 [−7.92, +0.55] | +7.76 [3.12, 12.46] |
| EverMemOS | 920 | 65.77% | 51.59 | 51.19 | −0.40 | +10.42 |
| MemOS | 408 | 12.79% | 45.12 | 44.58 | −0.53 | +17.02 |
| EMem | 171 | 26.33% | 48.36 | 48.19 | −0.17 | +13.41 |
| MemU | 604 | 63.07% | 31.07 | 32.55 | +1.49 | +29.05 |
| Mem0 | 62 | 1.45% | 32.26 | 32.22 | −0.04 | +29.38 |
상한을 제거하면 일곱 저장소 모두 raw evidence보다 7.58–29.38점 낮고 모든 paired 95% 구간이 0을 포함하지 않는다. 저자들은 남은 격차를 오로지 명목상의 포장 상한 탓으로 돌릴 수 없다고 쓴다. MemMachine의 평균 조립 증거는 4,982.8에서 29,459.7 token으로 늘며 컨텍스트 창 실패는 없었다. 상한 제거 후 MemMachine의 ER, Agg, Tr, Del, Cas, Abs는 95.00, 50.00, 55.00, 61.00, 46.95, 16.15%다.
9.4 두 raw-source oracle 설정 (Table 31)
GPT-4o-mini의 MEME oracle은 두 가지가 있고, 선택·컨텍스트 조립·reader 지시가 달라 점수 차이는 이들 변화가 합쳐진 것이다(부록 A.5.2).
| 설정 | ER | Agg | Tr | Del | Cas | Abs | Overall |
|---|---|---|---|---|---|---|---|
| Answer-location oracle | 98 | 47 | 81 | 39 | 1.83 | 36.15 | 50.50 |
| Gold-informed raw control | 94 | 52 | 69 | 92 | 34.15 | 28.46 | 61.60 |
전자는 질문·정답·개체 값을 쓰지 않고 질문 시점까지의 모든 주석된 지지 세션을 시간순으로 주고 상한이 없으며 Abs에만 값 없는 의존 유효성 지시를 쓴다. 후자는 gold 정보로 세션을 고르고 5,000 token으로 포장하며 모든 과제에 task 정책을 덧붙인다.
9.5 해석의 단서와 Finding 3
논문 본문은 complete-store와 raw evidence 사이의 격차(9.2–9.3절)가 수집 단계 정보 손실의 순수한 척도가 아니라고 명시한다. 같은 Raw-RAG조차 raw evidence에 못 미치며, 증거 조립과 lost in the middle(Liu et al., 2024) 같은 위치 효과도 기여할 수 있다. 부록 C.5는 raw–store 격차가 저장된 정보와 그것을 reader에게 제시하는 과정을 함께 반영해 수집 단계 정보 손실을 분리하지 못하며, native→complete 이득도 저장 증거 접근 확대와 task 정보·readout 정책 변화가 섞여 있고 native 검색이 놓친 관계가 저장소에 남아 있을 수 있다고 적는다. 또한 raw evidence도 100%에 못 미치고 과제별 순위가 달라지며, MEME Abs에서는 증거 부재 시의 'uncertain' 답이 정답 처리될 수 있어 정답이 곧 의존 관계의 성공적 재구성을 뜻하지는 않는다고 밝힌다. 부록은 추가로 다음을 보고한다.
- 내용 필터: 최종 결과는 Raw-RAG 9건, MemMachine 7건의 콘텐츠 필터 응답을 빈 오답으로 센다. 필터 질문과 gating용 쌍 12개를 모든 조건에서 제외하면(after-phase 687개) MemMachine은 57.46에서 54.85(−2.61 [−5.56, +0.36]), Raw-RAG는 57.54에서 54.68(−2.86 [−6.92, +1.28]), raw control은 61.53이며 일곱 개 cap 제거 구간이 모두 0을 포함한다. 따라서 MemMachine의 음의 구간은 provider 필터링에 민감하다고 저자들이 쓴다.
- 조건 정렬: Raw-RAG native는 판정 세 번 평균 39.30(첫 판정만 39.80)이다. EMem, EverMemOS, MemMachine native 답은 GPT-4o로 채점하며 Mem0는 로컬 시스템(27.76, 클라우드 29.12)을 쓴다.
- 부분집합: 읽기 증거가 바뀐 질문에서 MemU는 +2.70 [0.30, 5.23], MemMachine은 −3.46 [−6.49, −0.40]이다.
Finding 3(원문). 수집 단계의 정보 보존은 이후 회복에 중요하다. 수집 중 버려지거나 왜곡된 정보는 검색만으로 복구하기 어렵다.
9.6 이전 RAG 평가 검토 (부록 E, Table 34)
저자들은 선행 평가 14건(이 중 Memobase는 공개 RAG 구성만 검토)을 검토해, 청크가 너무 크거나 top-k가 너무 낮은 구성이 있다고 진단한다. 표의 "too large", "too low" 표기는 저자들의 진단이며 통제된 추정이 아니고, 연구 간 점수는 직접 비교할 수 없다고 명시한다.
| 연구 | 보고된 RAG 구성 | 저자들의 진단 |
|---|---|---|
| Mem0 | LoCoMo RAG(256/2) 60.97, k\in{1,2}, 임베딩 유사도만 |
top-k 낮음 |
| Memobase | 500-token 청크, k=1 |
top-k 낮음 |
| Nemori | 4096-token 청크, LoCoMo 30.20 / 32.90 | 청크 큼 |
| RecMem | 약 2048-token 청크, k=3/5 |
청크 큼, top-k 낮음 |
| Memora | 500-token 청크, k=3, 63.30 |
top-k 낮음 |
| BEAM/LIGHT | 사용자–어시스턴트 쌍 5개 | top-k 낮음 |
| xMemory, LoCoMo, LongMemEval, MemoryAgentBench | top-20 벡터 유사도 / DRAGON / 단위·키·예산 튜닝 / 512·4096 단위와 k∈{2,5,10} | cross-encoder reranking 부재 |
| PREMem, SeCom, SGMem | turn/round/session 단위 검색 | 짧은 turn은 인접 문맥과 분리되고 session은 무관한 내용을 묶음 |
| LightMem | NaiveRAG LongMemEval-S 61.00 | 청크 크기·최종 k·rerank 정책 미기재 |
저자들의 종합은 일부 선행 baseline에 구체적 구성 병목이 있으며, 에이전트형 메모리의 필요성을 세우려면 이런 기본 설계 제약을 다룬 Raw-RAG와의 비교가 필요하다는 것이다. 점수 격차에 대한 기여를 정량화하려면 통제된 재실행이 필요하다고 부록 E.3이 적는다.
10. 저자들이 밝힌 한계와 결론
10.1 본문 한계 (§6.1)
- 증거는 공개 벤치마크의 오프라인 대화에 한정되며, interactive·multimodal·더 넓은 운영 환경의 성능은 확립하지 않는다.
- raw-history 접근은 저장 및 프라이버시 우려도 낳는다.
- 향후에는 더 긴 이력과 더 다양한 모델에서, 명시적 프라이버시·삭제 제약을 반영해 평가해야 한다.
- 정확도, 지연, 계산 비용의 trade-off 속에서 구조화되거나 압축된 메모리가 raw 검색보다 유리한 경우를 가려야 한다.
- 상태 재구성은 reader 능력에 의존한다. 명시적 상태 유지가 약한 reader에게 이득이 되는지, 질의 간 반복 추론을 줄이는지는 미래 평가 과제다.
10.2 부록 F의 확장 논의
- 운영 메모리 관리: 평가 과제는 기록된 이력에서 답을 구하지만, 운영 시스템은 권위 있는 상태를 다른 도구에 노출하거나 갱신 후 동작을 촉발하거나 정보를 삭제해야 할 수 있어 정확도 밖의 목표가 생긴다.
- Reader 의존성: MEME phase-visible oracle(표 2)의 reader 간 큰 차이는 상태 재구성이 reader 능력에 의존함을 보여 주며, utilization 추정도 시스템이 충분한 증거를 준 질문 집합에 따라 달라진다. 검색은 의도한 reader로 평가해야 한다.
- 시연 구조: TTL의 하락(47.68→15.37)은 증거량, 시연 구조, reader–형식 불일치와 사실 손실이 섞여 있다.
- 확장성·일반화: raw 저장은 이력과 함께 커지고, 고정된 후보·reader 예산은 흩어지거나 유사도가 낮은 증거를 놓칠 수 있다. turn expansion과 겹치는 창은 반복 텍스트에 컨텍스트를 쓸 수 있다. 이력 길이별 검색 품질과 반복 질의 추론 비용은 측정이 남아 있다. hosted 모델과 서비스의 동작은 변할 수 있고 temperature 0에서도 출력과 반복 판정이 달라질 수 있다. 더 긴 interactive 워크로드, 저장 제한, multimodal 증거는 다른 trade-off를 선호할 수 있다.
10.3 평가 환경에 대해 부록이 적은 사항
모든 실험은 한 로컬 머신(Intel Core i9-13900HX, RTX 5070 Ti Laptop GPU, Windows 11)에서 조율되었고 LLM·임베딩·reranking은 API 엔드포인트를 썼다. 게시된 비교 점수는 각 연구의 환경에서 얻었다. 지연 비교는 각 시스템의 readiness 규칙과 내부 병렬성, 자원 가용성에 영향을 받는다. 일부 과거 의존성 버전은 기록되지 않았다.
10.4 결론
장기 대화 이해에 에이전트형 메모리 관리가 항상 필요한지 묻고, 논문은 원문 기록 위의 dense retrieval과 reranking인 Raw-RAG가 네 벤치마크, 7개 benchmark–model 설정 중 6개에서 Full-context를 제외한 메모리 시스템 중 1위라고 보고한다. 진단 분석은 증거 접근을 더 큰 관측 병목으로 지목한다: Raw-RAG는 충분한 증거를 더 자주 공급해 조건부 utilization의 열세를 상쇄하고, 유용한 증거에는 답 값뿐 아니라 지지 관계와 의존 경로가 포함되며, 변형된 저장소에 완전히 접근해도 raw 증거와 격차가 남는다. 저자들은 이 결과가 평가한 대화 과제에서 복잡한 에이전트형 메모리의 필요성에 의문을 제기한다고 결론짓고, 개선된 에이전트형 메모리는 잘 정의된 naive RAG baseline 대비 이득을 보이고 추가된 복잡성이 무엇을 기여하는지 밝혀야 한다고 적는다.
References
Bao, Z., Zhang, S., Zhang, H., Lou, S., Wen, M., & Luo, M. (2026). Is complex agentic memory always needed? Naive RAG is stronger than we thought (Version 1, arXiv:2610.30755) [Preprint]. arXiv. https://arxiv.org/abs/2610.30755v1
Chhikara, P., Khant, D., Aryan, S., Singh, T., & Yadav, D. (2025). Mem0: Building production-ready AI agents with scalable long-term memory (arXiv:2504.19413) [Preprint]. arXiv. https://arxiv.org/abs/2504.19413
Dai, Z., Deng, S., Guan, S., Tian, Y., Yao, X., Yan, X., & Cheng, J. (2026). RecMem: Recurrence-based memory consolidation for efficient and effective long-running LLM agents. Findings of the Association for Computational Linguistics: ACL 2026, 32353–32376. https://doi.org/10.18653/v1/2026.findings-acl.1619
Hu, C., Gao, X., Zhou, Z., Xu, D., Bai, Y., Li, X., Zhang, H., Li, T., Zhang, C., Bing, L., & Deng, Y. (2026). EverMemOS: A self-organizing memory operating system for structured long-horizon reasoning. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 45836–45853. https://doi.org/10.18653/v1/2026.acl-long.2125
Hu, Y., Wang, Y., & McAuley, J. (2026). Evaluating memory in LLM agents via incremental multi-turn interactions. International Conference on Learning Representations. https://openreview.net/forum?id=DT7JyQC3MR
Jiang, B., Yuan, Y., Shen, M., Hao, Z., Xu, Z., Chen, Z., Liu, Z., Vijjini, A. R., He, J., Yu, H., Poovendran, R., Wornell, G., Ungar, L., Roth, D., Chen, S., & Taylor, C. J. (2025). PersonaMem-v2: Towards personalized intelligence via learning implicit user personas and agentic memory (arXiv:2512.06688) [Preprint]. arXiv. https://arxiv.org/abs/2512.06688
Jung, S., Rubinstein, A., Uselis, A., Yun, S., & Oh, S. J. (2026). MEME: Multi-entity & evolving memory evaluation (arXiv:2605.12477) [Preprint]. arXiv. https://arxiv.org/abs/2605.12477
Kang, J., Ji, M., Zhao, Z., & Bai, T. (2025). Memory OS of AI agent. Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, 25961–25970. https://doi.org/10.18653/v1/2025.emnlp-main.1318
Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. Advances in Neural Information Processing Systems, 33.
Li, R., Zhang, L., Xu, B., Du, M., Fu, Z., & Chen, W. (2026). When your agent opens the chat app: Agent-controlled search over raw chat logs rivals structured memory (arXiv:2608.12888) [Preprint]. arXiv. https://arxiv.org/abs/2608.12888
Li, Z., Song, S., Wang, H., Niu, S., Chen, D., Yang, J., Xi, C., Lai, H., Zhao, J., Wang, Y., Ren, J., Lin, Z., Huo, J., Chen, T., Chen, K., Li, K., Yin, Z., Yu, Q., Tang, B., … Xiong, F. (2025). MemOS: An operating system for memory-augmented generation (MAG) in large language models (arXiv:2505.22101) [Preprint]. arXiv. https://arxiv.org/abs/2505.22101
Liu, J., Su, Y., Xia, P., Han, S., Zheng, Z., Xie, C., Ding, M., & Yao, H. (2026). SimpleMem: Efficient lifelong memory for LLM agents (arXiv:2601.02553) [Preprint]. arXiv. https://arxiv.org/abs/2601.02553
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the middle: How language models use long contexts. Transactions of the Association for Computational Linguistics, 12, 157–173.
Maharana, A., Lee, D.-H., Tulyakov, S., Bansal, M., Barbieri, F., & Fang, Y. (2024). Evaluating very long-term conversational memory of LLM agents. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 13851–13870. https://doi.org/10.18653/v1/2024.acl-long.747
Nan, J., Ma, W., Wu, W., & Chen, Y. (2025). Nemori: Self-organizing agent memory inspired by cognitive science (arXiv:2508.03341v1) [Preprint]. arXiv. https://arxiv.org/abs/2508.03341v1
Nogueira, R., & Cho, K. (2019). Passage re-ranking with BERT (arXiv:1901.04085) [Preprint]. arXiv. https://arxiv.org/abs/1901.04085
Rasmussen, P., Paliychuk, P., Beauvais, T., Ryan, J., & Chalef, D. (2025). Zep: A temporal knowledge graph architecture for agent memory (arXiv:2501.13956) [Preprint]. arXiv. https://arxiv.org/abs/2501.13956
Tavakoli, M., Salemi, A., Ye, C., Abdalla, M., Zamani, H., & Mitchell, J. R. (2026). Beyond a million tokens: Benchmarking and enhancing long-term memory in LLMs. International Conference on Learning Representations.
Wang, S., Yu, E., Love, O., Zhang, T., Wong, T., Scargall, S., & Fan, C. (2026). MemMachine: A ground-truth-preserving memory system for personalized AI agents (arXiv:2604.04853) [Preprint]. arXiv. https://arxiv.org/abs/2604.04853
Wu, D., Wang, H., Yu, W., Zhang, Y., Chang, K.-W., & Yu, D. (2025). LongMemEval: Benchmarking chat assistants on long-term interactive memory. International Conference on Learning Representations.
Xia, M., Zhang, X., Dixit, S., Harimurugan, P., Wang, R., Rühle, V., Sim, R., Bansal, C., & Rajmohan, S. (2026). Memora: A harmonic memory representation balancing abstraction and specificity (arXiv:2602.03315) [Preprint]. arXiv. https://arxiv.org/abs/2602.03315
Xu, W., Liang, Z., Mei, K., Gao, H., Tan, J., & Zhang, Y. (2025). A-Mem: Agentic memory for LLM agents. Advances in Neural Information Processing Systems.
Zhang, Y., Li, M., Long, D., Zhang, X., Lin, H., Yang, B., Xie, P., Yang, A., Liu, D., Lin, J., Huang, F., & Zhou, J. (2025). Qwen3 Embedding: Advancing text embedding and reranking through foundation models (arXiv:2506.05176) [Preprint]. arXiv. https://arxiv.org/abs/2506.05176
Zhou, S., & Han, J. (2025). A simple yet strong baseline for long-term conversational memory of LLM agents (arXiv:2511.17208) [Preprint]. arXiv. https://arxiv.org/abs/2511.17208
Keywords: Raw-RAG, agentic memory, naive RAG, long-term conversation, coverage, utilization, complete-store oracle Author: PaperWiki Last Updated: 2026-10-31