RankEvolve: A Reliable Multi-Agent Auto-Research Harness for Evolving Ranking Models
RankEvolve 쉬운 읽기
장기 ML 연구 루프에서는 데이터 누출이나 끊어진 gradient 하나가 학습과 지표를 함께 무효로 만듭니다. RankEvolve가 실행 절차를 런타임으로 통제하고 서로 다른 coding agent 제품의 교차 검토로 실행 정확도를 높인 방법과 그 조건을 설명합니다.
Paper: Zheng Chen; Linfeng Liu; Hong Li; Hong Yan (2026). "RankEvolve: A Reliable Multi-Agent Auto-Research Harness for Evolving Ranking Models". arXiv preprint, arXiv:2609.39551v1, 2026-09-30. 원문 · PDF.
판본: arXiv:2609.39551v1, 2026-09-30, 29쪽 읽기 버전: 2026-10-31
1. 오래 도는 연구 루프는 작은 실수에 약합니다
**auto-research agent(자동 연구 에이전트)**는 모델 개선안을 제안하고, 코드를 고치고, 학습과 평가를 반복합니다. 이 반복이 길어지면 한 번의 실수가 크게 번집니다. 평가 데이터가 학습에 새어 들어가는 leakage(누출), 빠진 정규화, 끊어진 gradient, 연결되지 않은 train/eval 설정은 오류 없이 실행되지만 몇 시간의 GPU와 지표를 함께 무효로 만듭니다. 그 결과가 다음 가설과 순위표에 쌓이면 연구 경로 자체가 틀어집니다.
Meta의 저자들은 이 문제를 **execution accuracy(실행 정확도)**의 문제로 봅니다. RankEvolve는 공개 추천 모델 HSTU(Zhai et al., 2024)를 여러 차례 개선하는 시스템이며, 두 규율로 정확도를 지키려 합니다. 하나는 연구 절차를 런타임이 통제하는 것이고, 다른 하나는 서로 다른 coding agent 제품이 서로의 작업을 교차 검토하는 것입니다.
2. 절차는 문서로 선언하고 런타임이 지킵니다
첫 번째 규율은 **EOP(Executable Operating Protocol, 실행 가능한 운영 절차)**입니다. 자연어 절차 문서에 단계(phase), 사람 승인 지점(gate), 분기(branch), 반복(loop)을 표시하면 런타임이 이를 상태 기계로 바꿉니다. 저자들의 표현대로 모델은 각 단계를 수행하지만 과정은 프레임워크가 통제합니다.
배포한 절차는 코드 조사 → 데이터 조사 → 연구·제안 → 구현·실험·분석 → 요약·진화 순서입니다. 조사와 제안 뒤에는 사용자 확인을 거치고, 계속하기로 하면 연구·제안 단계로 돌아가 다음 반복을 시작합니다. 런타임은 앞 단계가 끝나기 전 다음 단계를 열지 않고, 승인 전에는 멈추며, 허용 목록 밖의 도구와 예산 초과를 막습니다. 작업 경계마다 상태를 저장해 마지막 저장 지점에서 다시 시작할 수도 있습니다.
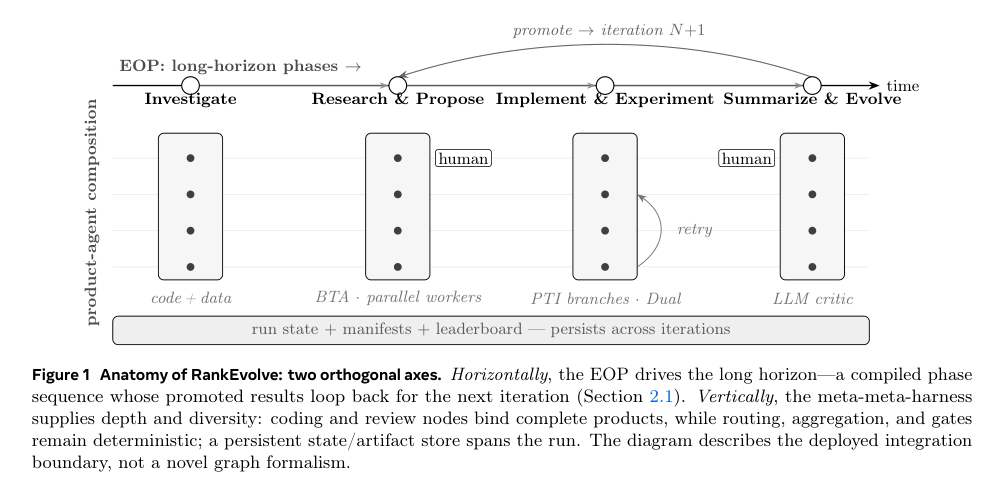
원 논문 Figure 1(논문 PDF 3쪽): 가로축은 EOP가 이끄는 장기 단계이고, 세로축은 각 단계 안에서 완제품 coding agent를 조합하는 작업 노드입니다. 아래 띠는 반복을 넘어 유지되는 실행 상태·기록·순위표입니다. 원문 PDF에서 보기.
EOP가 보장하는 것은 허용된 단계 전이입니다. 승인 기록이 남아도 코드의 gradient가 맞게 연결되었다는 뜻은 아니므로, 코드의 과학적 정확성은 아래 6절의 숨긴 채점기로 따로 잽니다. 전체 절차를 한 번에 넣은 10회 예비 실행에서는 10회 모두 선택한 제안의 일부만 실행했고 4회는 확인 단계를 건너뛰었습니다. 다만 이 예비 실행에는 비교군이 없어 저자들은 동기 자료로만 씁니다.
3. 모델 호출이 아니라 완제품 agent를 노드로 씁니다
두 번째 규율은 meta-meta-harness입니다. Claude Code나 Codex 같은 제품은 이미 모델 위에 계획기, 문맥 관리, 도구, 실행 환경을 갖춘 하나의 harness입니다. RankEvolve는 이 제품을 다시 모델 호출로 쪼개지 않고, 제품 전체를 작업 그래프의 black-box 노드로 연결합니다. 어댑터는 과제, 저장소 스냅숏, 허용 도구, 예산을 넘기고 patch, 종료 상태, 실행 기록, 사용량을 받습니다.
자주 쓰는 패턴은 **Dual(제안 → 검토 → 수정)**입니다. 검토자가 승인하거나 문제의 심각도가 기준 이하가 되거나 정해진 횟수에 도달하면 멈춥니다. 큰 일을 나눠 병렬로 처리하고 합치는 패턴과, 계획이 승인될 때만 구현하는 패턴도 있습니다. 경로 선택, 결과 병합, gate는 결정적 함수일 수 있으므로 모든 노드가 agent는 아닙니다.
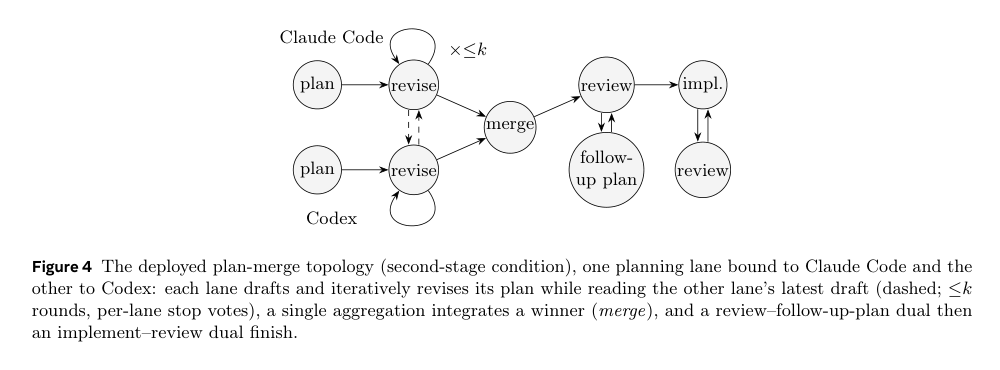
원 논문 Figure 4(논문 PDF 9쪽): Claude Code와 Codex가 각자 계획을 쓰고 상대의 최신 초안을 읽으며 고친 뒤 하나로 병합합니다. 이어 검토–후속 계획, 구현–검토 순서로 끝납니다. 이 구조는 사람이 설계했고 7절의 2단계 비교에 쓰였습니다. 원문 PDF에서 보기.
4. 실패도 다음 반복의 기록으로 남깁니다
**knowledge layer(지식 계층)**는 제안마다 patch, 설정, 지표, 비용, 승격 결정을 남깁니다. 성과가 없거나 거절되었거나 누출이 발견된 실행도 순위표의 한 행으로 남습니다. 배운 내용은 실험 폴더 옆의 로컬 노트, 여러 실험을 묶는 전역 위키, 모델·특징·결함을 잇는 개체 그래프에 저장됩니다. 다음 단계가 시작되면 관련 기록만 골라 읽고, 서로 모순되는 기록은 조건을 붙인 결론으로 정리하거나 사람에게 넘깁니다.
이 계층은 HSTU 배포에서 실제로 쓰였지만, 기억을 켜고 끈 비교 실험은 없습니다. 그래서 개선 결과를 지식 계층 하나의 효과로 나누어 말할 수 없습니다.
5. HSTU에서 12번 반복한 결과
평가는 MovieLens-20M(Harper & Konstan, 2015)의 NDCG@10입니다. 사용자마다 마지막 항목을 숨기고 전체 영화 후보에서 순위를 매깁니다. 논문이 인용한 공개 기준값은 LARGE 0.2098, BASE 0.1895입니다. RankEvolve의 최고 checkpoint는 LARGE 0.2192(+4.48%), BASE 0.1948(+2.80%)이었습니다.
LARGE에서는 입력 압축과 사용자 조건화를 조합해 0.2140, 여러 토큰으로 점수를 매기는 head를 더해 0.2161을 얻었습니다. 최고값 0.2192는 0.2140 조합에 장르 정보를 입력 특징으로 더해 미세조정한 결과입니다. 저자들은 이 요소들이 이미 알려진 아이디어의 조합이며 새 추천 기법이 아니라고 밝힙니다. 수치는 한 번의 실행에서 고른 최고 checkpoint이지 여러 seed의 평균이 아니며, 사람 운영자가 승인과 방향 제시에 참여했습니다.
실패도 함께 보고합니다. 선호 학습 DPO는 기준 0.2191을 0.1405로 낮췄고(−35.9%), IPO와 SimPO도 순위 품질을 낮췄습니다. 세 방법 모두 선호 정확도는 거의 1.0이었습니다. 저자들은 '거절' 항목이 정답과 장르를 공유(Jaccard 약 0.236)해 실제로 관련 있는 후보를 깎았다고 분석합니다. 장르 특징의 첫 구현은 학습 손실이 0으로 무너지는 누출을 만들었고 agent가 이를 고쳤습니다. 시퀀스 길이를 500에서 700으로 늘리면 실행 시간이 35% 늘고 NDCG@10은 떨어졌습니다.
6. 숨긴 채점기로 코드 정확도를 잽니다
저자들은 HSTU 배포에서 겪은 사고를 바탕으로 ExecML 벤치마크를 만들었습니다. HSTU와 LitGPT 저장소마다 구현 48개와 수리 48개, 모두 96개의 비공개 과제가 있고, 예산을 정하는 개발용 과제 32개가 따로 있습니다. 과제는 데이터 누출, 텐서 경로, gradient 흐름, train/eval 모드, 지표 의미, 설정 연결의 여섯 사고 유형에서 나왔습니다.
patch는 기존 회귀 테스트, 과제별 동작 검사, 과학적 안전 조건, 평가기 무결성 검사를 모두 통과해야 합격입니다. 숨긴 테스트와 정답 patch는 agent의 실행 환경에서 제거했습니다. 합격 비율이 **EA(execution accuracy)**이고, 실행은 되지만 결론을 무효로 만드는 결함이 남은 비율이 **CDR(silent critical-defect rate)**입니다. Claude Code는 Claude Opus 4.8, Codex는 GPT-5.6으로 실행했습니다. 비교 조건은 관측 가능한 토큰, 도구 행동, 시간, 비용 예산을 맞췄지만 제공자 내부의 연산량까지 맞춘 것은 아닙니다.
7. 서로 다른 제품의 교차 검토가 가장 높았습니다
| 조건 | HSTU EA | HSTU CDR | LitGPT EA |
|---|---|---|---|
| Claude Code 한 번 실행(예산 미맞춤 참고) | 22.9 | 35.4 | 20.8 |
| Claude Code 한 세션에 전체 예산 | 33.3 | 27.1 | 29.2 |
| Claude Code 여러 후보 중 선택 | 43.8 | 18.8 | 39.6 |
| CC→CC→CC | 45.8 | 16.7 | 43.8 |
| CC→Codex→CC | 62.5 | 10.4 | 56.2 |
| Codex→CC→Codex | 56.2 | 12.5 | 50.0 |
단위는 96개 과제 중 비율(%)입니다. 화살표는 구현 → 검토 → 수리를 맡은 제품입니다. 같은 예산에서 Claude Code가 구현하고 Codex가 검토한 조합은 가장 강한 단일 제품 조합 CC→CC→CC보다 HSTU에서 16.7퍼센트포인트 높았습니다(95% CI [6.6, 26.7]). 결과가 갈린 20개 과제 중 18개를 살렸고 2개를 망쳤습니다. 사전에 정한 LitGPT 비교에서도 12.5퍼센트포인트 높았습니다(95% CI [3.0, 22.0]).
Figure 4의 plan-merge는 HSTU 70.8%로 가장 높았지만, 과제당 약 2.40달러와 250번의 도구 행동을 쓴 예산 제한 없는 2단계 조건입니다. 같은 예산으로 제한하면 62.5%로 교차 검토 조합과 같았습니다.
저자들은 오류의 상관을 이유로 제시합니다. 같은 제품끼리의 실패 상관은 0.58, Claude Code와 Codex는 0.21이었고, 검토로 살린 비율에서 망친 비율을 뺀 실현 이득은 각각 −0.01과 0.061이었습니다. 저자들은 이를 인과 증명이 아닌 예측 근거로 제한합니다. 같은 런타임에서 현재 단계 지시만 준 경우는 전체 절차를 준 경우보다 후반 단계 EA가 10.4퍼센트포인트 높고(52.1 대 41.7), CDR은 6.2퍼센트포인트 낮았으며, 비용은 1.28달러에서 0.71달러로 줄었습니다.
8. 저자가 밝힌 한계
- 근거는 HSTU와 LitGPT 두 저장소이고 둘 다 Python/PyTorch입니다.
- 공개 저장소가 평가 제품의 사전학습에 포함되었을 수 있습니다. 비공개 과제와 숨긴 테스트는 이 위험을 줄이지만 없애지는 못합니다.
- 숨긴 채점기도 모든 의미 오류를 잡는다고 보장하지 않습니다.
- 제품 내부를 볼 수 없어 제공자 쪽 연산량은 맞추지 못했습니다.
- 지식 계층의 독립 효과는 측정하지 않았고, HSTU의 다른 데이터셋 결과는 칸마다 한 번의 실행입니다.
- HSTU 배포에는 사람 운영자가 있었고 ExecML에는 없었으므로 두 결과를 같은 조건으로 묶지 않습니다.
RankEvolve의 주장은 런타임 통제가 코드의 정확성을 자동으로 보장한다는 것이 아닙니다. 정해 둔 관측 예산과 숨긴 채점기 아래에서, 서로 다른 coding agent 제품의 검토–수리 조합이 한 제품을 더 오래 돌리는 것보다 높은 실행 정확도를 보였다는 것입니다.
References
Chen, Z., Liu, L., Li, H., & Yan, H. (2026). RankEvolve: A reliable multi-agent auto-research harness for evolving ranking models (Version 1, arXiv:2609.39551) [Preprint]. arXiv. https://arxiv.org/abs/2609.39551v1
Harper, F. M., & Konstan, J. A. (2015). The MovieLens datasets: History and context. ACM Transactions on Interactive Intelligent Systems, 5(4), 1–19. https://doi.org/10.1145/2827872
Zhai, J., Liao, L., Liu, X., Wang, Y., Li, R., Cao, X., Gao, L., Gong, Z., Gu, F., He, J., Lu, Y., & Shi, Y. (2024). Actions speak louder than words: Trillion-parameter sequential transducers for generative recommendations. Proceedings of the 41st International Conference on Machine Learning. https://proceedings.mlr.press/v235/zhai24a.html