Kronecker Delta Rule for Long Context Linear Attention
KronLSTM을 쉽게 읽기
KronLSTM은 검색단서와 저장정보 쌍의 연관을 고치는 Kronecker Delta Rule을 게이트형 기억에 적용합니다. 두 delta rule의 차이, 이론의 가정, 8k·32k 학습과 장문맥 회수 결과, H100 학습 처리량을 구분해 설명합니다.
Paper: Anamaria-Roberta Hartl; Levente Zólyomi; Michael List; Günter Klambauer; Sebastian Böck; Sepp Hochreiter (2026). "Kronecker Delta Rule for Long Context Linear Attention". arXiv preprint, arXiv:2610.26834v1. arXiv · PDF. 판본: 2026-10-19, 53쪽.
이 글은 긴 문장을 작은 기억에 보관하는 KronLSTM을 수식 없이 읽는 안내서입니다. 먼저 용어를 약속합니다. key는 검색단서, value는 저장정보, query는 질문입니다. matrix(행렬)는 숫자를 칸마다 담은 숫자표입니다. 모델은 검색단서와 질문으로 숫자표를 읽고, 저장정보와 함께 숫자표를 고칩니다.
1. 긴 문장에서 무엇을 기억하나
Softmax attention은 지금 token이 앞의 모든 token을 직접 비교합니다. 문장이 길어지면 비교량과 추론 중 보관할 KV cache가 함께 커집니다. 선형 attention은 과거를 고정 크기 숫자표에 압축합니다. 숫자표에 검색단서와 저장정보의 관계를 써 두고, 질문이 오면 관련 정보를 읽는 방식입니다. 대신 서로 비슷한 단서가 같은 칸을 건드려 기억이 섞일 수 있습니다.
Hebbian 방식은 새 검색단서와 저장정보의 조합을 계속 더합니다. DeltaNet은 “이 검색단서를 넣으면 이 저장정보가 나와야 한다”는 벡터 목표를 세우고, 현재 답과 정답의 차이를 줄입니다. KronLSTM은 다른 질문을 합니다. “이 검색단서와 저장정보가 함께 나타났다는 관계의 세기가 얼마인가?”를 하나의 숫자로 저장합니다. 그래서 한 쌍을 고칠 때 그 쌍과 겹치는 정도가 낮은 다른 쌍의 점수는 덜 흔들리도록 만듭니다.
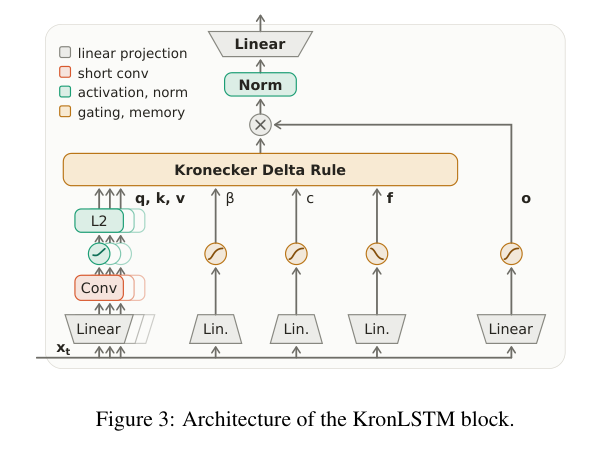
그림 1. 논문 Figure 3, PDF 6쪽. 검색단서·질문·저장정보와 세 게이트가 숫자표 기억을 거쳐 출력으로 이어지는 구조입니다.
2. 두 delta rule과 실제 게이트
DeltaNet은 검색단서 하나에 저장정보 벡터 전체를 연결합니다. 따라서 같은 검색단서가 조금만 겹쳐도 여러 저장정보 좌표가 함께 바뀔 수 있습니다. KronLSTM의 Kronecker Delta Rule은 검색단서와 저장정보를 한 묶음으로 보고, 그 묶음의 스칼라 연관 점수만 고칩니다. 검색단서가 겹치거나 저장정보가 겹치는 정도가 둘 다 있어야 다른 묶음의 점수가 크게 영향을 받습니다.
KronLSTM 블록에는 세 조절기가 있습니다. key-wise forget gate는 검색단서의 방향별로 오래된 내용을 줄입니다. beta gate는 기존 관계를 얼마나 지울지 정합니다. write gate는 새 관계를 얼마나 강하게 쓸지 정합니다. 질문·검색단서·저장정보는 선형 변환, 짧은 causal convolution, SiLU, L2 정규화를 거칩니다. 숫자표를 질문으로 읽은 뒤에는 출력 gate와 head별 RMSNorm을 거칩니다. mLSTM처럼 별도 normalizer state나 stabilizer state를 두지는 않습니다.
논문은 긴 token별 반복을 고정 길이 chunk의 계산으로도 바꿉니다. chunk 안에서는 검색단서끼리의 관계표와 저장정보끼리의 관계표를 만든 뒤 작은 삼각형 문제를 풉니다. 거대한 Kronecker 숫자 벡터를 실제로 만들지 않고 두 관계표의 결합만 사용해, chunk 사이에서만 숫자표 기억을 넘깁니다.
3. 이론은 어디까지 말하나
수렴 증명은 실제 언어 입력 전체가 아니라, 입력 쌍이 서로 독립적으로 나오고 beta가 매번 같은 단순한 상황을 다룹니다. 모든 검색단서·저장정보 방향이 충분히 관측되고, beta와 입력 크기가 안정 범위에 있어야 합니다. 그러면 기억의 평균은 주어진 스칼라 관계를 가장 잘 맞추는 숫자표로 가까워집니다.
논문은 같은 무작위 입력을 두 개의 기억에 똑같이 적용해 둘의 차이가 줄어드는지 봅니다. 이 차이가 계속 줄면 기억의 분포도 하나의 장기 분포로 모입니다. 이것이 Wasserstein-2 수축이라는 말의 쉬운 뜻입니다. 매번 같은 하나의 숫자표에 멈춘다는 뜻은 아닙니다. 서로 맞지 않는 관계가 계속 들어오면 그 장기 분포 주변에서 흔들립니다.
기억의 크기를 잴 때 쓰는 Frobenius norm은 숫자표 모든 칸의 제곱을 더해 제곱근을 취한 값입니다. 초기 숫자표가 모두 0이고 추가적인 안정 조건을 만족하면, 이 크기의 제곱을 평균한 값이 모든 시점에서 일정한 상한을 갖습니다. 개별 실행의 기억 크기가 언제나 같은 값 아래라는 뜻은 아닙니다. 상한은 저장하려는 관계의 세기와 입력 방향이 얼마나 고르게 관측되는지에 따라 달라집니다.
따라서 이 정리를 실제 1.5B 언어 모델 전체의 안정성 보증으로 읽으면 안 됩니다. 실제 모델에서는 beta, forget, write, 검색단서와 저장정보가 입력에 따라 달라집니다. 이론은 단순한 고정-beta 기억에서 무엇을 기대할 수 있는지 보여 주고, 실제 게이트 블록의 모든 학습 동작을 증명한 것은 아닙니다.
4. 학습과 평가 조건
주요 모델은 1.5B parameters, 24 layers, hidden dimension 2048, 16 heads입니다. FineWeb-Edu 100B tokens를 Llama 2 tokenizer로 읽어 8,192-token sequence로 학습했습니다. 순수 선형 모델과 2,048-token sliding-window attention을 linear layer 5개 대 1개 비율로 섞은 hybrid를 비교했습니다. AdamW와 bf16 mixed precision을 사용했고, 학습 장비는 16 nodes의 GH200입니다.
8k로 학습한 모델은 4k·8k·16k에서 평가했습니다. 16k는 학습 길이를 넘어선 평가입니다. 별도 32k 실험은 8k 학습이 75B tokens에 도달한 뒤 갈라서 32,768-token sequence로 25B tokens를 더 학습한 continued pretraining입니다. 긴 문서 mixture를 쓰고 optimizer state와 schedule도 다시 시작했으므로 단순히 평가 길이만 늘린 실험이 아닙니다. state tracking은 beta를 0보다 크고 2보다 작은 범위로 넓혀 parity, S3 permutation, modulo arithmetic을 평가합니다.
5. 결과를 읽는 법
언어 모델링에서 **perplexity(PPL)**는 다음 token을 얼마나 불확실하게 예측하는지 나타내는 값입니다. 낮을수록 모델이 다음 token을 더 자신 있게 맞힌다는 뜻입니다. 8k 표에서 순수 linear KronLSTM은 Avg-6 59.72, PPL 11.72로 KDA의 58.12, 12.67보다 좋았습니다. hybrid KronLSTM도 Avg-6 59.56, PPL 11.18을 기록했습니다. 다만 모든 개별 과목을 항상 이긴다는 뜻은 아닙니다.
real-world recall은 2k context에서 여섯 종류의 문서 질문을 얼마나 다시 찾는지 보는 평가입니다. 평균은 순수 linear 30.31, hybrid 37.40이었습니다. hybrid에서 가장 가까운 Mamba-3 평균은 36.96이므로 차이는 0.44점입니다. 이 수치는 언어 모델링 점수와 다른 기억 회수 시험입니다.
NIAH는 Needle in a Haystack, 즉 긴 잡음 문장 더미 속에 숨긴 정보를 나중에 찾아내게 하는 시험입니다. 단일 정보뿐 아니라 여러 검색단서·질문·저장정보를 다루는 변형도 있습니다. 8k로 학습한 순수 linear KronLSTM의 S2는 4k·8k·16k에서 98.2·60.4·16.0%였습니다. 문맥이 길어질수록 이 점수는 낮아집니다. 별도의 S1 과제에서 나타난 약점에 대해 저자들은 반복 잡음과 같은 검색단서가 오차를 누적시킬 가능성을 설명합니다. 32k continued pretraining의 KronLSTM Avg-6은 linear 60.19, hybrid 60.10이고, 2,048-token recall 평균은 각각 31.08, 36.23이었습니다. 8k 표와 학습 branch가 다르므로 두 표를 단순한 전후 비교로만 읽으면 안 됩니다.
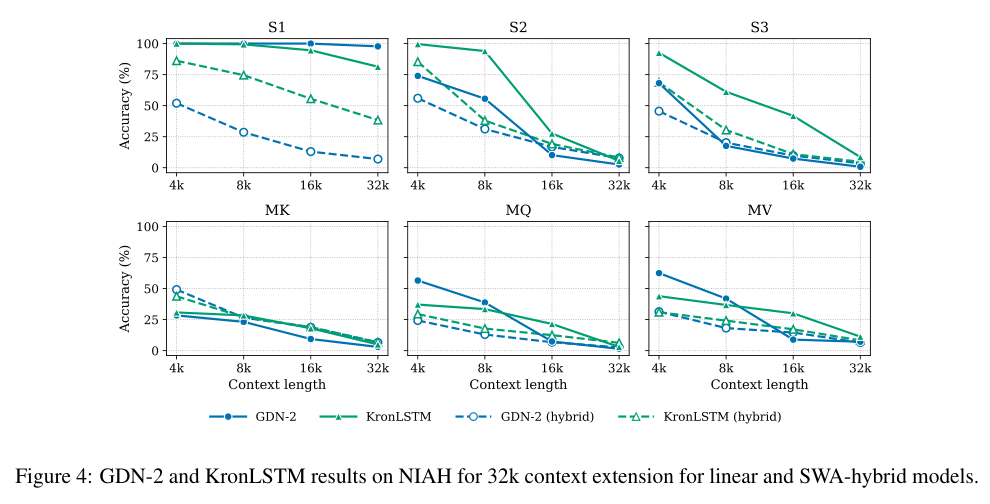
그림 2. 논문 Figure 4, PDF 10쪽. 8k 모델을 32k로 계속 학습한 뒤의 NIAH 비교입니다.
6. 상태 추적과 학습 처리량
state tracking에서는 KronLSTM이 parity와 S3 permutation에서 GDN과 비슷하고, modulo arithmetic에서는 Mamba-3가 앞섭니다. 처리량 그림은 H100 80GB 한 장에서 한 step의 16,384 tokens를 학습한 값입니다. KronLSTM은 36.8–44.5K tokens/s로 GDN-2보다 11–18% 높지만 GDN이 가장 빠릅니다. 이는 inference latency나 KV-cache 크기를 잰 결과가 아닙니다.
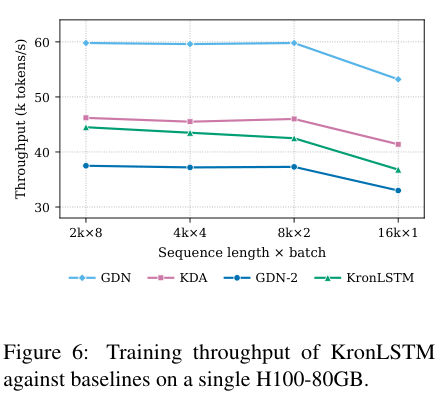
그림 3. 논문 Figure 6, PDF 10쪽. sequence length와 batch를 바꾼 end-to-end training throughput입니다.
7. 한계와 읽는 범위
KronLSTM의 핵심은 검색단서·저장정보 쌍의 스칼라 관계를 그 쌍의 방향으로 고치는 것입니다. 따라서 DeltaNet처럼 검색단서에서 저장정보 벡터 전체를 회수하는 규칙과 목적이 다릅니다. 논문은 고정 beta 이론, 실제 게이트 블록, chunk 계산, 8k·32k 학습, recall·NIAH·state tracking·throughput을 함께 보여 줍니다. 앞으로 더 큰 규모와 full softmax attention을 섞은 hybrid가 과제입니다. 현재 hybrid는 2,048-token sliding-window attention을 5 대 1로 섞은 별도 설정이며, 각 결과는 자신의 학습·평가 조건 안에서 읽어야 합니다.
References
Hartl, A.-R., Zólyomi, L., List, M., Klambauer, G., Böck, S., & Hochreiter, S. (2026). Kronecker Delta Rule for long context linear attention (arXiv:2610.26834v1). arXiv. https://arxiv.org/abs/2610.26834v1