Unifying Goal-Conditioned RL and Unsupervised Skill Learning via Control-Maximization
Control-Maximization: GCRL과 비지도 스킬 학습을 잇는 제어 민감도 이론
같은 목표 도달도 반복 방문, 정확한 시각, 기한 내 첫 도착에 따라 최적 행동이 달라집니다. Control-Maximization의 세 보상 기준, 목표 민감도, 스킬 학습과의 정보이론적 연결을 정리의 조건과 함께 설명합니다.
Paper: Alireza Modirshanechi; Benjamin Eysenbach; Peter Dayan; Eric Schulz (2026). "Unifying Goal-Conditioned RL and Unsupervised Skill Learning via Control-Maximization". arXiv preprint, arXiv:2605.06145v2, 2026-10-22. 원문 · PDF.
1. 논문이 묻는 문제
목표 조건부 강화학습(GCRL)은 “어디로 가라”는 목표를 받은 에이전트가 그 목표를 달성하도록 학습하는 방법입니다. 비지도 스킬 학습 중 하나인 상호정보량 스킬 학습(MISL)은 스킬 번호에 따라 행동 결과가 달라지도록 만듭니다. 상호정보량은 한 변수를 관찰했을 때 다른 변수를 얼마나 잘 알아낼 수 있는지를 재는 정보량입니다. 그래서 MISL의 스킬들은 서로 구별되는 행동을 보입니다.
행동이 다양하다는 사실만으로 목표를 잘 달성한다고 단정할 수는 없습니다. 이 논문은 목표를 “얼마나 자주 방문하는가”, “정확한 시각에 있는가”, “정해진 시간 안에 한 번 도착하는가”로 나누어 봅니다. 이 세 기준은 모두 목표 도달이라고 부를 수 있지만, 서로 다른 최적 행동을 만듭니다. 논문은 이를 control maximization, 즉 명령한 목표나 스킬 선택이 미래 결과를 얼마나 바꿀 수 있는지 최대로 하는 문제로 설명합니다.
v2는 2026년 10월 22일 판본인 44쪽 이론 논문입니다.
2. 목표·스킬·행동 결과를 구별하기
논문은 목표와 상태가 같은 경우를 다룹니다. 목표를 받은 정책은 현재 상태와 시간, 목표를 보고 행동을 고릅니다.
스킬은 여러 단계의 행동을 묶은 하나의 정책입니다. MISL에서는 유한한 스킬 번호를 먼저 고른 뒤 그 번호에 조건화된 정책을 실행합니다. 관찰자는 실행 결과를 보고 어떤 스킬이 선택되었는지 추정합니다. 이때 결과는 마지막 상태일 수도 있고, 할인된 방문 분포일 수도 있으며, 전체 궤적일 수도 있습니다. 궤적은 중간에 거친 상태와 행동을 모두 기록한 경로를 뜻합니다.
논문의 기본 가정은 상태·행동·스킬 공간이 모두 유한하고, 목표가 상태 전체이며, 시험할 목표와 MISL의 스킬을 균등하게 뽑고, 목표에서 스킬로 가는 대응이 결정론적이라는 것입니다. 결정론적이라는 말은 같은 목표가 항상 같은 스킬 번호로 바뀐다는 뜻입니다. 분석은 주어진 대응과 정책을 다루며, 대응을 학습하는 방법이나 유한한 데이터에서 생기는 추정 오차는 정리하지 않습니다.
3. 세 가지 목표 보상
첫째는 persistent goal, 줄여서 Pe입니다. 목표에 도착할 때마다 보상을 받고 이후에도 목표를 계속 방문하는지를 봅니다. 할인율이 클수록 먼 미래의 방문도 중요합니다. 따라서 목표에 빨리 한 번 도착하는 것뿐 아니라 목표에 머물거나 다시 돌아가는 행동이 유리합니다.
둘째는 exact timing, ET입니다. 미리 정한 K번째 시각에 목표에 있어야 보상을 받습니다. 일찍 목표에 도착했더라도 그 뒤 떠나면 실패입니다. 약속 시각에 정확히 도착해야 하는 상황을 나타냅니다.
셋째는 opportunity window, OW입니다. K시각 안에 목표에 처음 도착하면 보상받고, 할인으로 빠른 도착을 더 높게 칩니다. 목표에 도착하는 순간 이후의 보상은 이어서 세지 않습니다. 마감 전에 한 번 제출하면 되는 상황에 가깝습니다.
이 차이는 단순한 표현 차이가 아닙니다. Pe는 할인된 방문 점유를, ET는 특정 시각의 상태를, OW는 첫 도착 시각을 최적화합니다. 따라서 MISL에서도 어떤 결과를 다양하게 만들 것인지가 달라져야 합니다.
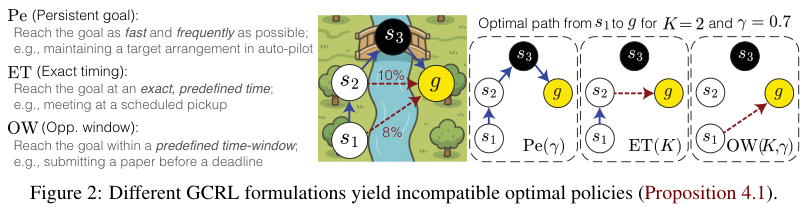
그림 1. arXiv:2605.06145v2 Fig. 2, PDF p. 5. 8%와 10%의 강 건너기 확률에서 persistent goal·exact timing·opportunity window가 다른 경로를 택하는 도식입니다.
4. 같은 환경에서도 최적 행동이 달라지는가
논문의 Proposition 4.1은 모든 환경이 아니라, 서로 다른 최적 정책을 만드는 환경과 시간 길이, 할인율이 존재한다고 말합니다. 원문의 강 예에서 시작점의 즉시 jump 성공률은 8%이고, 다리를 건넌 뒤 다음 상태에서 jump하면 성공률은 10%입니다. K는 2, 할인율은 0.7입니다.
Pe는 다리를 건너 목표에 도착한 뒤의 반복 방문까지 고려하므로 다리를 선택합니다. ET는 두 번째 시각만 보므로 다리를 건넌 다음 jump합니다. OW는 다리를 건넌 뒤의 성공률에 시간 할인까지 붙여 7%로 보게 되므로, 8%인 즉시 jump를 선택합니다. Pe와 ET는 첫 행동에서 다리를 공유하지만 전체 정책은 같지 않습니다.
반대로 조건이 맞으면 세 기준이 만나기도 합니다. 한 단계만 보면 Pe, ET, OW가 같은 문제입니다. ET의 시한을 에이전트가 모르고 기하분포로 평균하면 Pe와 같은 값이 됩니다. 기회 창이 무한하고 정책이 정적이면 OW와 Pe가 같은 최적 정책을 공유합니다. 전이가 결정론적이면 유한한 창에서도 최단 경로 정책이 둘 모두에 최적입니다. 모든 상태에 기다리기 행동이 있고 OW의 할인율이 1이면, 목표에 도착한 뒤 기다리는 정책이 ET와도 맞습니다. 각 결론은 해당 시간 범위, 결정론, 정책 형태라는 조건 안에서만 성립합니다.
5. 목표 민감도와 GCRL 성능
논문은 목표 민감도라는 양을 정의합니다. 목표 민감도는 올바른 목표를 명령했을 때의 성능과, 다른 목표를 명령했을 때 같은 목표를 우연히 달성한 성능의 평균 차이입니다. 값이 크면 명령이 실제 행동 결과를 크게 바꾼다는 뜻입니다. 환경이 목표에 도달할 방법을 거의 제공하지 않으면 민감도의 최대값도 작고, 방법이 있어도 정책이 목표를 무시하면 실제 민감도가 작습니다.
정책이 일관적이라는 조건은 모든 상태와 목표 쌍에서 올바른 목표를 명령한 값이 다른 목표를 명령한 값보다 낮지 않다는 뜻입니다. Pe와 ET에서는 평균 GCRL 반환이 목표 민감도에 상태 수의 역수를 더한 값과 정확히 일치합니다. 따라서 두 기준에서는 민감도를 최대로 하는 정책과 반환을 최대로 하는 정책이 같은 최적 정책입니다.
OW와 음이 아닌 보상을 쓰는 일반 formulation에서는 반환이 목표 민감도의 일정 배수 이상이라는 하한만 항상 성립합니다. OW에서는 민감도를 최대로 하는 정책이 언제나 최적 반환을 주지는 않지만, 민감도의 환경 상한이 클수록 그 정책의 regret, 즉 최적 반환과의 차이에 대한 상한은 작아집니다. 이 결과는 학습 오차나 표본 오차를 포함한 실험 보장이 아니라 이상적인 정책 공간의 정리입니다.
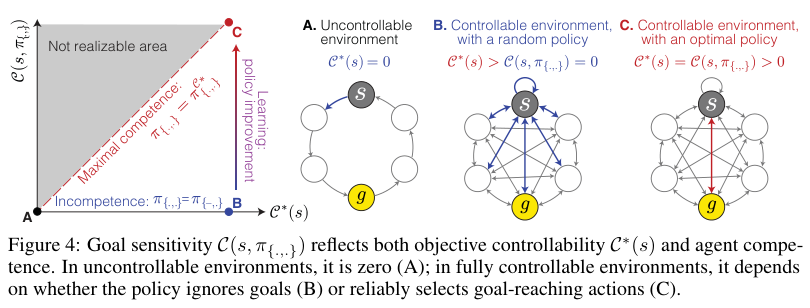
그림 2. arXiv:2605.06145v2 Fig. 4, PDF p. 7. 통제 불가능한 환경, 목표를 무시하는 정책, 목표를 잘 따르는 정책을 구분한 원문 도식입니다.
6. MISL과 맞는 행동 결과
목표를 균등하게 고른 뒤 정책을 실행하고 결과를 관찰하면 목표와 결과 사이의 상호정보량을 계산할 수 있습니다. Pe에는 기하분포 시각의 상태, 즉 할인된 상태 점유가 맞습니다. ET에는 K번째 terminal state가 맞습니다. 이 두 경우 논문은 목표 민감도가 상호정보량의 하한을 주고, 정책이 일관적이면 reverse-Fano 상한도 줍니다. Fano 부등식은 분류 오류가 작을 때 관측 결과가 원래 목표에 관한 정보를 많이 담는다는 정보이론적 부등식입니다.
OW에는 하나의 마지막 상태보다 각 목표에 언제 처음 도착했는지를 모은 discounted first-visit vector가 맞습니다. 이 벡터의 각 항은 K 안에 해당 목표를 처음 만났는지와 얼마나 빨리 만났는지를 담습니다. 논문의 일반 정리는 이 벡터와 목표 사이의 상호정보량이 목표 민감도를 제곱한 값의 두 배 이상이라는 하한입니다. 반대로 정보량이 크면 OW 반환도 크다고 거꾸로 말하려면, 올바른 목표 정책이 무작위 목표 혼합보다 모든 문턱값에서 우세하고, 가능한 값의 확률에 양의 하한이 있으며, 벡터의 다른 항들이 만드는 간섭이 제한된다는 세 추가 가정이 필요합니다. 그때에만 상수와 간섭항을 포함한 상한이 나옵니다.
전체 궤적을 다양하게 만드는 MISL은 terminal state를 다양하게 만든다는 보장이 없습니다. 결정론적 환경에서 여러 스킬이 서로 다른 중간 경로를 지나 같은 마지막 상태에 도달하면, 궤적은 스킬을 구별하지만 terminal state는 아무 정보도 주지 않습니다. 그러므로 downstream 보상이 마지막 상태만 관찰한다면 전체 궤적 MI를 그 보상의 근거로 바로 사용할 수 없습니다.
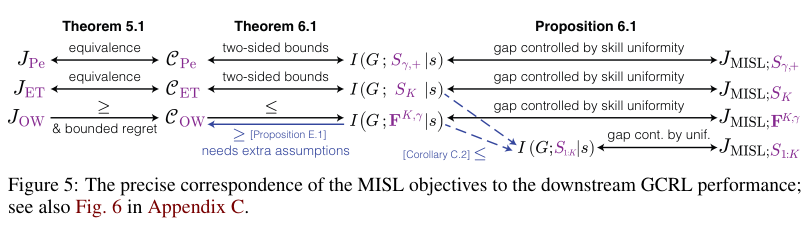
그림 3. arXiv:2605.06145v2 Fig. 5, PDF p. 8. Theorem 5.1·6.1과 Proposition 6.1의 대응을 요약한 원문 도식이며 OW의 역방향에는 추가 가정이 표시되어 있습니다.
7. 스킬 분포, 한계와 결론
균등한 목표가 균등한 스킬을 만든다는 보장은 없습니다. 목표 여러 개가 같은 스킬로 매핑되면 실제 시험에서 자주 선택되는 스킬과 드물게 선택되는 스킬이 생깁니다. 논문은 실제 스킬 분포와 균등 분포 사이의 total variation, 즉 두 분포의 차이를 재는 거리를 사용해 MISL 상호정보량이 목표-행동 상호정보량보다 얼마나 클 수 있는지 제한합니다. 반대 방향까지 포함하는 절댓값 차이의 보장은 아닙니다. 목표가 스킬들에 같은 크기로 나뉘면 두 정보량은 같습니다.
부록은 비균등 목표 분포도 일부 다룹니다. 이때 Pe와 ET의 정확한 항등식은 목표 확률의 최솟값과 최댓값을 포함하는 부등식으로 약해지고, OW의 하한도 가장 드문 목표의 확률에 의존합니다. 상태가 연속적이거나 목표가 위치처럼 상태 일부만 지정하거나 목표-스킬 대응이 확률적이면 별도 가정과 새로운 변수가 필요합니다. 특히 OW의 MI 역방향은 일반 정리가 아닙니다.
따라서 이 논문의 결론은 “더 다양한 스킬이면 언제나 더 좋은 GCRL”이 아닙니다. 시험 보상이 반복 방문을 보는지, 정확한 시각을 보는지, 첫 도착을 보는지 먼저 정하고 그 결과를 반영하는 MISL 변수를 선택해야 합니다. Pe에는 discounted occupancy, ET에는 terminal state, OW에는 discounted first-visit vector가 대응합니다. 이 correspondence는 유한 공간과 명시된 사상·분포 가정 아래의 이론입니다.
References
Modirshanechi, A., Eysenbach, B., Dayan, P., & Schulz, E. (2026). Unifying goal-conditioned RL and unsupervised skill learning via control-maximization (arXiv:2605.06145v2). arXiv. https://arxiv.org/abs/2605.06145v2