Unifying Goal-Conditioned RL and Unsupervised Skill Learning via Control-Maximization
Control-Maximization: GCRL과 비지도 스킬 학습을 잇는 제어 민감도 이론
같은 목표 도달도 반복 방문, 정확한 시각, 기한 내 첫 도착에 따라 최적 행동이 달라집니다. Control-Maximization의 세 보상 기준, 목표 민감도, 스킬 학습과의 정보이론적 연결을 정리의 조건과 함께 설명합니다.
Paper: Alireza Modirshanechi; Benjamin Eysenbach; Peter Dayan; Eric Schulz (2026). "Unifying Goal-Conditioned RL and Unsupervised Skill Learning via Control-Maximization". arXiv preprint, arXiv:2605.06145v2, 2026-10-22. 원문 · PDF.
1. 연구 질문과 이론의 범위
Goal-conditioned reinforcement learning(GCRL)은 명령받은 목표에 따라 행동하는 정책을 학습한다. Unsupervised skill discovery에서 mutual-information skill learning(MISL)은 스킬 인덱스와 그 행동 결과 사이의 상호정보량(mutual information, MI)을 높여 서로 구별되는 정책을 찾는다. 두 접근은 실제로 함께 쓰이지만, “목표를 잘 달성한다”와 “행동이 다양하다”가 언제 같은 방향을 가리키는지는 결과 변수를 어떻게 정하느냐에 달려 있다.
Modirshanechi, Eysenbach, Dayan, Schulz의 arXiv v2(2026-10-22)는 이 문제를 control maximization, 즉 명령이나 스킬 선택이 미래 결과를 얼마나 바꿀 수 있는지 최대로 하는 문제로 통합한다. 세 GCRL 보상인 persistent goal(Pe), exact timing(ET), opportunity window(OW)가 같은 환경에서도 서로 다른 최적 정책을 가질 수 있음을 보이고, 각 보상에 대응하는 목표-행동 MI와 MISL MI의 경계를 정리한다. 이 글은 v2 PDF 44쪽의 본문과 부록을 기준으로 하며, 정리·명제·toy 반례만 다루는 이론 논문이라는 범위를 유지한다. 학습된 정책의 실험 성능이나 벤치마크 우위를 보고하는 논문은 아니다.
2. 표기와 공통 가정
상태 공간을 유한 집합 \mathcal S, 그 크기를 N_s=|\mathcal S|>1이라 한다. 상태 s의 행동 집합 \mathcal A(s)와 전이확률 p(s'\mid s,a)가 주어진다. 시간 t에 목표 g를 받은 비정상(non-stationary) 정책은 \pi_{g,t}(a\mid s)로 쓰며, 초기 상태가 s일 때 목표별 반환은
J(s,g,\pi)=\mathbb E\left[\sum_{t=1}^{\infty}R_t(S_t;g)\prod_{k=0}^{t-1}\gamma_k(S_k;g)\mid S_0=s\right],\qquad \gamma_0=1이다. 여기서 R_t는 목표 의존 보상, \gamma_t는 할인 인자다. 본문 Sections 4–6의 standing assumption은 상태·행동·스킬 공간이 유한하고, 목표와 상태가 같으며(G=\mathcal S), test-time 목표가 균등하고, MISL 스킬 사전확률도 균등하며, 목표-스킬 사상 f:G\to Z가 결정론적이라는 것이다. 스킬 공간은 유한하고 N_z=|\mathcal Z|>1이다.
균등 목표의 test-time 반환과 목표 민감도는 같은 초기 상태에서 계산한다. MISL의 스킬 조건부 정책을 \pi^{\mathrm{skill}}_{z,t}라 하면 downstream 정책은
\pi_{g,t}(a\mid s)=\pi^{\mathrm{skill}}_{f(g),t}(a\mid s)이다. 이 식은 주어진 f를 분석할 뿐, 사상을 학습하는 알고리즘이나 finite-sample 추정 오차를 가정하지 않는다. MISL 목적은 균등한 Z와 궤적에서 정한 행동 변수 S'의 MI, 즉 I(Z;S'\mid S_0=s)이다. S'는 terminal state S_K, geometric 시점의 상태 S_{\gamma,+}, 또는 전체 궤적일 수 있다. OW의 matching 변수는 뒤에서 정의할 discounted first-visit vector다.
3. 세 GCRL formulation과 최적 정책의 비등가성
세 formulation은 sparse goal reward를 같은 식에 넣되 보상 시점과 목표에 도달한 뒤의 discount를 다르게 한다.
3.1 Persistent goal, Pe(\gamma)
Pe는 \gamma\in[0,1)에서 목표를 반복 방문할 때마다 1-\gamma를 주고 계속 할인한다.
R_t(s;g)=(1-\gamma)\mathbf 1_{s=g},\qquad \gamma_t(s;g)=\gamma.따라서 반환은 기하분포 K\sim\mathrm{Geom}(1-\gamma)로 뽑은 시점의 상태가 목표일 확률이다.
J_{\mathrm{Pe}}(s,g,\pi,\gamma)=\Pr_\pi(S_{\gamma,+}=g\mid S_0=s).\gamma가 1에 가까워지면 stationary policy의 장기 목표 점유(target occupancy)와 연결된다. 이 formulation은 빠른 첫 도달보다 목표에 계속 머무르거나 재방문하는 행동도 평가한다.
3.2 Exact timing, ET(K)
ET는 K\in\mathbb N번째 상태가 정확히 목표여야 한다.
R_t(s;g)=\mathbf 1_{s=g}\mathbf 1_{t=K},\qquad \gamma_t(s;g)=1,J_{\mathrm{ET}}(s,g,\pi,K)=\Pr_\pi(S_K=g\mid S_0=s).일찍 목표에 도착한 뒤 떠나면 K에서 목표가 아니므로 실패할 수 있다. 목표는 알지만 실제 K의 실현값을 관측하지 않는 agent가 K\sim\mathrm{Geom}(1-\gamma)에 대해 평균을 취하면 그 평균 ET 반환은 Pe 반환과 같아진다. K를 보고 정책을 바꾸는 경우에는 같은 정책 문제라고 할 수 없다.
3.3 Opportunity window, OW(K,\gamma)
OW는 K 이내의 첫 목표 도달을 보상하되 \gamma\in[0,1]로 빠른 도달을 선호한다.
R_t(s;g)=\mathbf 1_{s=g}\mathbf 1_{t\le K},\qquad \gamma_t(s;g)=\gamma\mathbf 1_{s\ne g}.T_g=\min{t\ge1:S_t=g}를 첫 도달 시각이라고 하면 목표에 도착한 순간 이후 discount가 0이 되므로 반환은
J_{\mathrm{OW}}(s,g,\pi,K,\gamma)=\mathbb E_\pi\left[\gamma^{T_g-1}\mathbf 1_{T_g\le K}\mid S_0=s\right]이다. 즉 반복 방문을 누적하는 Pe와 달리 첫 도달만 센다. \gamma=1이면 창 안의 첫 도달은 같은 가중치를 받고, \gamma=0이면 첫 시점 도달만 남는다.
3.4 존재 명제와 강 반례
Proposition 4.1의 양화사는 “모든 환경에서 다르다”가 아니라, 서로 다른 최적 정책을 유도하는 환경, K, \gamma가 존재한다는 것이다. 부록의 강 환경에서 \epsilon_1<\epsilon_2, K=2이고
\max\{\sqrt{\epsilon_1},\epsilon_2\}<\gamma<\frac{\epsilon_1}{\epsilon_2}<1이면 세 목적이 다른 선택을 한다. Fig. 2의 toy 값은 \epsilon_1=0.08, \epsilon_2=0.10, \gamma=0.7, K=2다. 실제로 \sqrt{0.08}\approx0.2828<0.7<0.8이다. 시작점 s_1에서 즉시 jump는 성공확률 8%, bridge를 타고 s_2에서 jump하면 10%다. Pe는 bridge로 목표까지 가는 discounted occupancy가 0.7^2=0.49라서 bridge를 선호한다. ET(2)는 두 번째 시각의 10%가 8%보다 커 bridge 뒤 jump를 택한다. OW(2, 0.7)는 bridge 뒤 두 번째 시각의 값이 0.7\times0.10=0.07이므로 즉시 8% jump를 택한다. Pe와 ET가 첫 행동에서 bridge를 공유해도 전체 최적 정책은 다르다.
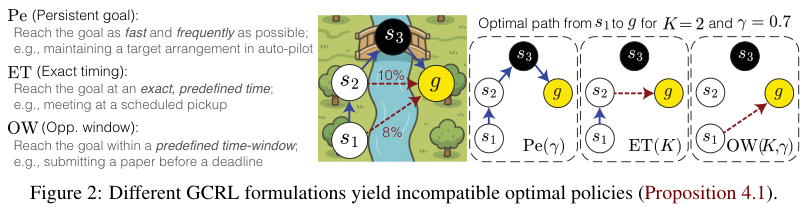
그림 1. Modirshanechi et al. (2026), arXiv:2605.06145v2, Fig. 2, PDF p. 5. 8%·10% toy 전이와 세 보상의 서로 다른 선택을 보여 주는 원문 도판이다.
3.5 최적 정책이 일치하는 조건
비등가성이 모든 경우의 불일치를 뜻하지는 않는다. Pe(0), ET(1), OW(1,\gamma), OW(K,0)는 모두 한 단계 목표 추구 문제다. ET의 K가 관측되지 않고 geometric하게 평균되면 Pe와 formulation 자체가 같다. K\to\infty이고 stationary policy를 비교하면 OW와 Pe가 같은 최적 정책을 공유한다. 결정론적 전이와 \gamma\in(0,1)에서는 결정론적 shortest-path policy가 유한 K에서도 Pe와 OW 모두에 최적이다. 이는 두 목적의 모든 최적 정책 집합이 같다는 주장은 아니다. 모든 상태에 대기 행동이 있고 \gamma=1이면, OW(K,1)의 첫 도달 정책을 목표에서 기다리도록 바꾼 정책이 ET(K)와 공통 최적 정책이 된다. 각 결론은 해당 조건과 정책 클래스 안에서만 성립한다.
4. Goal sensitivity와 GCRL 반환
정책이 consistent하다는 것은 모든 초기 상태 s, 목표 g, 다른 명령 g'에 대해 올바른 명령의 값이 다른 명령의 값보다 작지 않다는 뜻이다.
J(s,g,\pi_{g,\cdot})\ge J(s,g,\pi_{g',\cdot})\qquad\text{for every }s,g,g'.Goal sensitivity는 명령을 맞게 주었을 때 무작위 다른 명령보다 얻는 평균 이득이다.
C(s,\pi)=\frac{1}{N_s^2}\sum_{g,g'\in\mathcal S}\left[J(s,g,\pi_{g,\cdot})-J(s,g,\pi_{g',\cdot})\right].환경과 허용된 정책 공간이 제공하는 최대값을 C^(s)=\max_\pi C(s,\pi)로 둔다. consistent policy에서는 0\le C(s,\pi)\le C^(s)다. C는 정책의 목표 지향성과 환경의 objective controllability를 함께 반영하며, C^*는 실제 학습 정책이 달성했다는 뜻이 아닌 환경 쪽 상한이다.
Theorem 5.1의 첫 결과는 Pe와 ET에서 off-command branch의 평균이 정확히 1/N_s가 되어
J(s,\pi)=\frac{1}{N_s}+C(s,\pi)가 된다는 항등식이다. 따라서 같은 formulation과 같은 초기 상태에서 평균 반환을 최대화하는 정책과 sensitivity를 최대화하는 정책의 최적 집합이 같다. 이 등식을 Pe와 ET 사이의 수치 동일성으로 읽어서는 안 된다. 각 formulation의 J와 C가 서로 다른 행동 변수를 사용하기 때문이다.
OW와 모든 non-negative reward, bounded return formulation에서는 임의의 정책에 대해
J(s,\pi)\ge\frac{N_s}{N_s-1}C(s,\pi)가 성립한다. equality는 모든 g\ne g'에 대해 off-command 값 J(s,g,\pi_{g',\cdot})가 0일 때다. OW에서는 sensitivity maximizer가 항상 value maximizer라는 보장이 없다. 그런 환경과 K,\gamma가 존재하지만, OW의 최적 반환 J^(s)과 sensitivity maximizer \pi_{C^} 사이에는
0\le J^*(s)-J(s,\pi_{C^*})\le1-\frac{N_s}{N_s-1}C^*(s)라는 regret envelope가 있다. 이는 이상적인 policy optimizer를 전제로 한 환경 수준의 bound이며, 표본 오차·최적화 오차·map 추정 오차를 포함하지 않는다.
결정론적 환경에서 ET의 최대 sensitivity와 Klyubin empowerment도 연결된다. Klyubin empowerment를 길이 K 행동열과 S_K 사이 MI의 최대값으로 정의하면
\mathrm{Emp}_{\mathrm{Kly}}(s;K)=\log\left(1+N_sC^*_{\mathrm{ET}}(s,K)\right)이다. 이 등식은 결정론적 전이와 행동열 최적화라는 조건 밖에서 Pe, OW 또는 stochastic 환경으로 자동 확장되지 않는다.
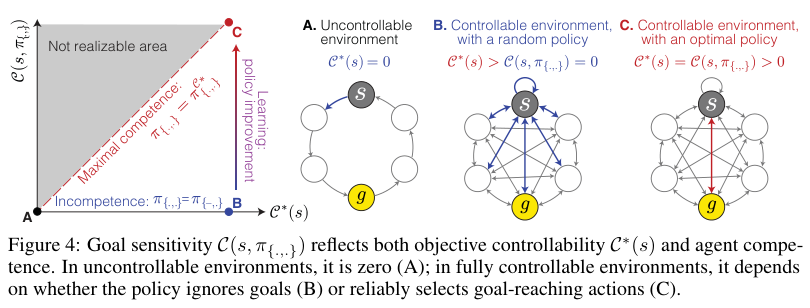
그림 2. Modirshanechi et al. (2026), arXiv:2605.06145v2, Fig. 4, PDF p. 7. 제어 불가능한 환경, 목표를 무시하는 정책, 목표를 안정적으로 추구하는 정책의 sensitivity 차이를 나타낸다.
5. formulation별 행동 변수와 MI bound
목표 G를 균등하게 뽑고 그 목표 branch를 실행한 결과 S'를 관찰하면 goal-behavior MI I_\pi(G;S'\mid S_0=s)를 얻는다. 이는 skill-behavior MI와 같은 모양이지만, 어떤 결과 변수를 관찰하는지가 formulation에 맞아야 한다.
| GCRL formulation | matching 행동 변수 | Theorem 6.1의 방향 |
|---|---|---|
Pe(\gamma) |
geometric state S_{\gamma,+} |
lower bound; consistent policy에서 upper bound도 성립 |
ET(K) |
terminal state S_K |
lower bound; consistent policy에서 upper bound도 성립 |
OW(K,\gamma) |
discounted first-visit vector F_{K,\gamma} |
일반적으로 lower bound만 성립 |
5.1 Pe·ET의 Fano lower와 reverse-Fano upper
h를 binary entropy라 하고
\Phi_N^{\downarrow}(x)=\log N-h(x)-(1-x)\log(N-1)로 두면, consistency를 가정하지 않는 lower bound는
I_\pi(G;S_{\gamma,+}\mid S_0=s)\ge\Phi_{N_s}^{\downarrow}\left(\frac{1}{N_s}+C_{\mathrm{Pe}}(s,\pi,\gamma)\right),I_\pi(G;S_K\mid S_0=s)\ge\Phi_{N_s}^{\downarrow}\left(\frac{1}{N_s}+C_{\mathrm{ET}}(s,\pi,K)\right)이다. 증명은 결과 상태를 그대로 goal 추정값으로 쓰는 decoder의 오류를 Fano inequality에 넣는다. 여기서 lower bound는 해당 sensitivity에서 적어도 이만큼 MI가 남는다는 뜻이다.
consistent policy를 추가하면 identity decoder가 Bayes-optimal decoder와 같은 오류를 가지므로 reverse-Fano upper envelope가 가능하다. 원문은 x\in[1/N,1]에 대해 floor m=\lfloor x^{-1}\rfloor, source convention \lceil x^{-1}\rceil=m+1을 사용해
\Phi_N^{\uparrow}(x)=\log N-(\lceil x^{-1}\rceil x-1)\lfloor x^{-1}\rfloor\log\lfloor x^{-1}\rfloor-(1-\lfloor x^{-1}\rfloor x)\lceil x^{-1}\rceil\log\lceil x^{-1}\rceil로 정의한다. 따라서 Pe와 ET에서는 같은 formulation의 C와 matching MI 사이에 양방향 envelope가 있다. source의 floor/ceiling convention을 일반적인 정수 ceiling으로 바꾸면 안 되며, 로그 밑도 한 비교 안에서 일관돼야 한다.
5.2 OW의 first-visit MI와 방향
OW에 맞는 변수는 하나의 terminal state가 아니라 모든 목표의 첫 도달 결과를 모은 벡터다.
F_{K,\gamma}=(F_g^{K,\gamma})_{g\in\mathcal S},\qquad F_g^{K,\gamma}=\gamma^{T_g-1}\mathbf 1_{T_g\le K}.Theorem 6.1은 임의의 정책에 대해 consistency 없이
I_\pi(G;F_{K,\gamma}\mid S_0=s)\ge 2C_{\mathrm{OW}}(s,\pi,K,\gamma)^2를 준다. 증명은 각 first-visit 분포와 목표-independent mixture 사이의 total variation을 sensitivity로 제한하고, Pinsker inequality와 Jensen inequality를 적용한다. 이 식은 큰 OW sensitivity가 큰 first-visit MI를 강제한다. 반대 방향, 즉 큰 MI가 큰 OW control을 강제한다는 결론은 일반적으로 나오지 않는다.
Appendix E의 Proposition E.1은 그 역방향의 한 예다. K>1, \gamma\in(0,1)에서 (1) 올바른 goal branch가 random mixture보다 모든 threshold에서 first-order stochastically dominate하는 stochastic consistency, (2) mixture의 marginal F_g가 취하는 모든 support 값의 확률이 최소 \eta_{K,\gamma}>0이라는 probable support, (3) 전체 벡터 KL이 marginal KL 평균보다 \epsilon_{K,\gamma}만큼만 큰 bounded interference를 가정한다. 그러면
I_\pi(G;F_{K,\gamma}\mid S_0=s)\le\frac{4}{\eta_{K,\gamma}\delta_{K,\gamma}^2}C_{\mathrm{OW}}(s,\pi,K,\gamma)+\epsilon_{K,\gamma},\delta_{K,\gamma}=\min\{\gamma^{K-1},\gamma^{K-2}(1-\gamma)\}이다. \eta나 \delta가 작거나 interference가 크면 계수가 느슨해진다. 따라서 이는 OW의 일반적 양방향 정리가 아니라 명시된 세 추가 가정 아래의 bound다.
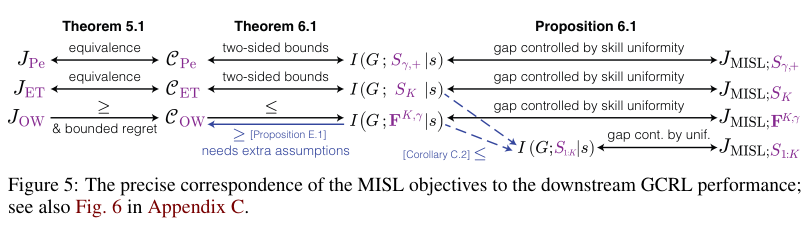
그림 3. Modirshanechi et al. (2026), arXiv:2605.06145v2, Fig. 5, PDF p. 8. Theorem 5.1·6.1과 Proposition 6.1의 연결을 보여 주며 OW 역방향 화살표에는 Appendix E 가정이 붙는다.
6. goal-to-skill map, prior mismatch와 비균등 목표
결정론적 map f가 있어도 균등 goal이 균등 skill을 유도하는 것은 아니다. 실제 downstream skill 분포는
p_f(z)=\frac{1}{N_s}\sum_{g\in\mathcal S}\mathbf 1_{z=f(g)}이다. 먼저 goal을 뽑고 Z=f(G)로 정한 생성 과정에서는
I_\pi(G;S'\mid S_0=s)=I_{Z\sim p_f}^{\pi^{\mathrm{skill}}}(Z;S'\mid S_0=s)가 성립한다. MISL은 균등 skill prior를 쓰므로 두 MI가 자동으로 같지는 않다. S'가 최대 N_{s'}>1개의 값을 취하고 N_z\le N_{s'}라 하자. \delta=|p_f-\mathrm{Unif}(\mathcal Z)|_{\mathrm{TV}}이면 Proposition 6.1은
J_{\mathrm{MISL}}(s,\pi^{\mathrm{skill}};S')-I_\pi(G;S'\mid S_0=s)\le h(\delta)+\delta\log\left[N_{s'}^2(N_{s'}-1)\right]을 준다. 이는 MISL MI에서 goal-behavior MI를 뺀 값에 대한 한쪽 방향의 상한이지 절댓값 차이의 상한은 아니다. 균등 goal과 같은 크기의 preimage를 가진 map이면 \delta=0이고 두 MI가 같은 prior를 사용하므로 gap도 0이다. 스킬이 많다는 사실만으로 test-time에 자주 선택된다는 뜻은 아니다.
Appendix F는 고정된 skill policy에 대해 각 초기 상태 s_0와 goal에서 반환을 최대화하는 skill을 고르는 map f(s_0,g)를 허용하면 consistency를 만들 수 있음을 보인다. 이 map은 Eq. (5)의 단순한 f(g)와 달리 초기 상태에 의존하므로, Proposition 6.1의 uniformity gap도 상태별 \delta_s로 읽어야 한다.
Appendix G는 G=\mathcal S는 유지하면서 균등하지 않은 goal prior p_{\mathrm{goal}}를 허용한다. 이때 sensitivity를 두 독립 goal의 해당 prior 평균으로 다시 정의하고, p_{\min}=\min_g p_{\mathrm{goal}}(g), p_{\max}=\max_g p_{\mathrm{goal}}(g)라 하면 Pe·ET에 대해
p_{\min}+C(s,\pi)\le J(s,\pi)\le p_{\max}+C(s,\pi),OW와 non-negative reward에 대해
J(s,\pi)\ge\frac{1}{1-p_{\min}}C(s,\pi)가 된다. Pe·ET의 MI lower bound는 \log N_s 대신 목표 entropy H[p_{\mathrm{goal}}]를 사용하고, upper bound는 prior 가중치를 포함하는 강한 consistency를 요구한다. Proposition G.1의 MISL–goal MI gap 식은 p_f의 total variation으로 같은 형태를 유지한다.
또한 결과 변수를 맞추지 않으면 data-processing inequality가 보장하는 것은 terminal MI가 trajectory MI보다 작거나 같다는 방향뿐이다.
I(G;S_K\mid s)\le I(G;S_{1:K}\mid s)\le I(G;\tau_K\mid s).결정론적 환경에서 여러 skill이 서로 다른 중간 경로를 지나도 모두 같은 S_K에 도착하면 trajectory MI는 H(Z)일 수 있지만 terminal MI는 0이다. 따라서 trajectory diversity는 ET의 terminal goal control을 자동으로 보장하지 않는다.
7. 가정, 증거 범위와 결론
이론의 기본 무대는 유한 상태·행동·스킬 공간, 상태와 goal의 동일성, 균등 목표 prior, 균등 MISL skill prior, 결정론적 goal-to-skill map이다. 연속 상태에서는 differential entropy와 density support를 새로 제어해야 한다. 목표가 위치처럼 상태의 일부만 지정한다면 일반 map \phi:S\to G와 goal-relevant variable을 사용해야 하며, G=S 결과를 그대로 옮길 수 없다. stochastic map은 skill 선택 entropy 항이 추가된다. 비균등 목표에 대한 Appendix G는 일부 bound를 확장하지만 모든 partial-goal·continuous 경우를 다루지는 않는다.
Pe와 ET에서는 matching 결과 변수에 대해 Fano lower와 consistency 조건부 reverse-Fano upper가 함께 있고, OW에서는 discounted first-visit vector에 대한 lower bound가 일반적으로 유일한 방향이다. OW의 inverse bound는 stochastic consistency, probable support, bounded interference를 모두 요구한다. 이 구분은 MI를 높이면 어떤 GCRL이든 좋아진다는 주장과 다르다. 실제로 어떤 행동 결과를 downstream reward가 관찰하는지가 먼저 고정돼야 한다.
v2는 정리와 증명, 세 formulation의 toy 반례와 도식으로 이론을 제시하며 learned policy, pretraining schedule, benchmark return, 통계적 실험을 제시하지 않는다. Fig. 2의 8%·10%와 수식의 상수는 정리의 예시 파라미터이지 학습 결과가 아니다. 논문의 결론은 모든 GCRL과 MISL을 하나의 동일한 objective로 만드는 것이 아니라, Pe에는 discounted occupancy, ET에는 terminal state, OW에는 discounted first-visit vector처럼 control을 측정할 결과 변수를 formulation에 맞춰야 한다는 correspondence다.
References
Eysenbach, B., Gupta, A., Ibarz, J., & Levine, S. (2019). Diversity is all you need: Learning skills without a reward function. International Conference on Learning Representations. https://openreview.net/forum?id=H1g6osRcF7
Eysenbach, B., Salakhutdinov, R., & Levine, S. (2021). C-learning: Learning to achieve goals via recursive classification. International Conference on Learning Representations. https://openreview.net/forum?id=5r3g2mWIMrQ
Klyubin, A. S., Polani, D., & Nehaniv, C. L. (2005). Empowerment: A universal agent-centric measure of control. 2005 IEEE Congress on Evolutionary Computation, 1, 128–135. https://doi.org/10.1109/CEC.2005.1554676
Laskin, M., Liu, H., Peng, X. B., Yarats, D., Rajeswaran, A., & Abbeel, P. (2022). CIC: Contrastive intrinsic control for unsupervised skill discovery. arXiv preprint arXiv:2202.00161. https://arxiv.org/abs/2202.00161
Modirshanechi, A., Eysenbach, B., Dayan, P., & Schulz, E. (2026). Unifying goal-conditioned RL and unsupervised skill learning via control-maximization (arXiv:2605.06145v2). arXiv. https://arxiv.org/abs/2605.06145v2
Park, S., Rybkin, O., & Levine, S. (2024). METRA: Scalable unsupervised RL with metric-aware abstraction. International Conference on Learning Representations. https://openreview.net/forum?id=uYlfxB6E5i
Sharma, A., Gu, S., Levine, S., Kumar, V., & Hausman, K. (2020). Dynamics-aware unsupervised discovery of skills. International Conference on Learning Representations. https://openreview.net/forum?id=HJg7G2Ntwr
Keywords: goal-conditioned reinforcement learning, mutual-information skill learning, control maximization, goal sensitivity, opportunity window, empowerment Author: PaperWiki Last Updated: 2026-10-25