Harness2: Recursive Agent Harnessing for an Open World
Harness2 쉬운 읽기
모델 가중치는 고정한 채 현재 과제의 실행 구성을 고치고, 그 경험을 다음 과제의 개선에 재사용하는 Harness²를 설명합니다. 행동 대조와 사후 평가, 두 수준의 반복 개선, 성능과 추가 비용을 구분합니다.
Paper: Ruiyao Xu; Yanfei Chen; Zhongying CuiZhu; Bhavana Dalvi Mishra; Yifei Ming; Han Yu; Rujun Han; Chen-Yu Lee; Tomas Pfister (2026). "Harness2: Recursive Agent Harnessing for an Open World". arXiv preprint, arXiv:2610.14224v1. HTML · PDF.
판본: arXiv:2610.14224v1, 2026-10-09, 37쪽 읽기 버전: 2026-10-24
1. 모델이 아니라 주변 실행을 고칩니다
이 논문은 모델 가중치를 다시 학습하지 않고 에이전트의 실행 환경을 고칩니다. 이 글에서는 task를 과제, harness를 실행 구성이라고 부릅니다. 실행 구성은 지시, 기억, 도구 사용, 위임을 정한 파일과 프로그램의 묶음입니다. reference는 기준 실행, probe는 후보를 시험하는 실행, compose는 시험 결과를 바탕으로 변경을 선별·결합하는 단계입니다. recursion은 이 과정을 반복하는 개선입니다. 논문 용어인 benchmark는 평가 묶음, library는 과제 사이에 남겨 두는 재사용 보관함, selector는 실행 결과를 고르는 선택기입니다.
논문은 두 반복 개선을 구분합니다. task-level recursion은 현재 과제의 실행 구성을 고칩니다. harnessing-level recursion은 그 경험을 다음 과제의 개선 절차가 읽게 합니다. 앞의 반복은 결과물을, 뒤의 반복은 고치는 방법을 바꿉니다. 여기서 실행 구성과 재사용 보관함은 같은 것이 아닙니다.
2. 정답 대신 행동의 차이를 관찰합니다
미리 알 수 없는 업무 환경에서는 다음 과제를 모르고 온라인 편집 세션에도 정답 라벨이나 신뢰할 검증기가 없습니다. Harness2는 기준 실행 뒤 invariant(여러 업무에 공통인 문제) 후보와 domain(현재 업무에 특화된 문제) 후보를 만듭니다.
후보를 같은 조건에서 실행해 궤적(행동 기록)과 결과물의 차이를 비교합니다. 이 **behavioral contrast(행동 대조)**는 수정 뒤 행동과 회귀를 보여 주지만 외부 정답을 증명하지 않습니다. WorkBuddy-Bench, JobBench, LAB의 점수는 과제 뒤 검증기나 모델 채점기가 계산한 사후 평가값입니다. 따라서 시험 실행의 행동 대조와 benchmark의 정답성 점수는 서로 다른 질문에 답하며, 전자의 개선이 후자의 상승을 자동으로 뜻하지 않습니다.
3. 제안(Propose)–시험(Probe)–선별 결합(Compose)으로 한 과제를 고칩니다
실행 기록은 궤적과 결과물의 쌍입니다. Propose(제안)가 기준 실행을 바탕으로 공통 문제와 업무별 문제 후보를 만들고, Probe(시험)가 후보를 같은 조건에서 실행합니다. Compose(선별 결합)는 시험 증거를 읽고 변경을 골라 합친 뒤 새 실행 구성을 실행합니다. k>1이면 selector가 결과물 하나를 채택하지만 새로 합성하지는 않습니다.
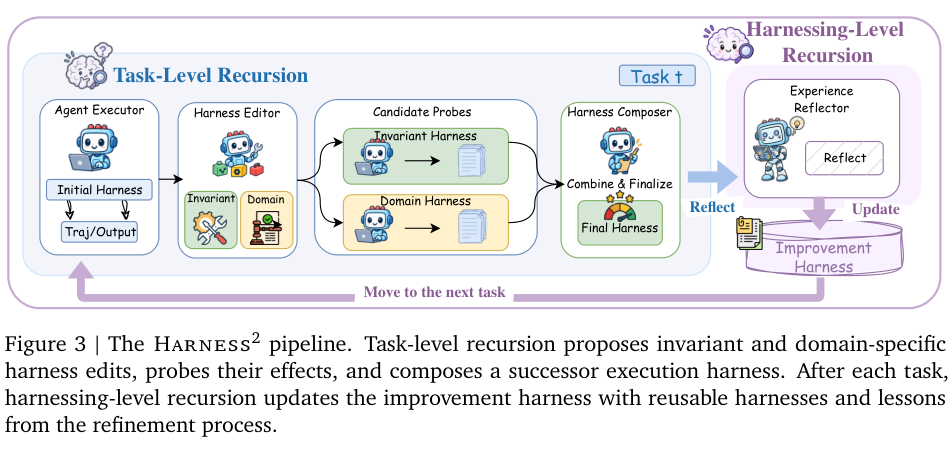
원 논문 Figure 3(논문 PDF 5쪽): 과제 수준 반복 개선이 invariant·domain 후보의 실행 구성 변경을 제안하고 시험한 뒤 새 구성을 선별·결합하며, 과제가 끝나면 재사용할 구성과 교훈을 개선 절차에 저장하는 흐름이다. 원문 PDF에서 보기.
병렬 반복 개선(parallel recursion)은 후보와 선별·결합을 여러 개 만들어 비교하고, 순차 반복 개선(sequential recursion)은 한 단계의 실행 구성과 기록을 다음 단계로 넘깁니다. 병렬 k=5는 다섯 세대가 아니라 한 번에 비교하는 후보 수입니다.
4. 여덟 파일 표면과 실행 조건을 사용합니다
편집 표면은 system prompt(시스템 지시), guardrails(안전 규칙), memory(기억), tool guidance(도구 안내), skills(전문 절차), subagents(하위 작업자), scripts(스크립트), middleware plugin(도구 연결부)의 여덟 가지입니다. 앞의 네 가지는 매번 읽고, skill은 호출할 때 읽으며, subagent·script·plugin은 각각 별도 문맥·bash·도구 순환부에서 실행합니다. 수정 대상은 prompt만이 아니라 실행 파일 트리입니다.
검사기는 trigger 없는 skill, 컴파일되지 않는 script, 빠진 helper를 검사합니다. 실패하면 한 번 재시도하고 다시 실패하면 시작 tree를 사용합니다. 편집자와 선택기는 Claude Opus 4.8이고 실행기는 Gemini 3.5 Flash 또는 GLM-5입니다. 채점 결과, 채점 기준, 점수는 편집자 작업 공간에 들어가지 않습니다.
5. 세 benchmark에서 같은 조건으로 비교합니다
WorkBuddy-Bench는 Code 80, Web 70, Office 50개 중 test 40/35/25개를 사용하고 여러 검사를 합친 통과 비율을 냅니다. JobBench는 65개 중 고정된 31/34 분할의 test 34개를 사용하고 Claude Opus 4.8의 가중 총점/최대값을 보고합니다. LAB는 1,251개 법률 과제, 24개 업무 분야, 네 작업 유형 중 따로 보류한 100개 test를 사용하고, Claude Sonnet 4.6이 실행 검사 없이 기준별 Partial(기준 통과율)을 채점합니다.
수치는 과제 순서를 섞은 세 독립 흐름의 평균과 표준편차입니다. Harness2는 k=1, + Recursion은 병렬 k=5의 추가 변화입니다. Gemini 3.5 Flash/OpenCode에서 WorkBuddy 77.5, JobBench 36.0, LAB 81.9를 얻고, GLM-5/OpenCode에서는 75.7, 24.2, 71.4를 얻습니다. base 대비 최대 변화는 11.5점, 4.5점, 11.8퍼센트포인트입니다.
6. 더 탐색하고 경험을 재사용 보관함으로 넘깁니다
Figure 5에서 k를 1에서 5로 늘리면 병렬 방식의 점수가 WB-code 76.5→80.8, WB-office 79.5→83.4가 됩니다. 최종 결과물 전 실행과 개선에 쓴 모든 토큰을 계산 비용으로 세며, Gemini 3.5 Flash/OpenCode의 base 대비 향상은 JobBench 4.5→7.5점, WorkBuddy-Bench 5.1→8.4점입니다. #Steps는 실행기 차례 수라 전체 토큰과 다릅니다. 병렬 실행은 여러 후보를 동시에 비교할 수 있지만 후보를 만드는 추론과 토큰 사용 자체를 줄이지는 않습니다.
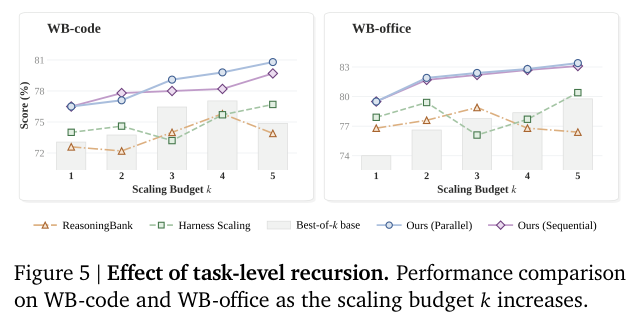
원 논문 Figure 5(논문 PDF 9쪽): 규모 예산 k가 커질 때 WB-code와 WB-office의 과제 수준 반복 개선 성능을 비교한 그림이다. 원문 PDF에서 보기.
과제가 끝나면 reflector는 증거가 있는 lesson(교훈)과 채택 실행 구성을 업무별 재사용 보관함에 저장합니다. 다음 과제는 이전 실행 구성을 그대로 이어받지 않고 공통 초기 구성에서 출발하며, 제안 단계가 보관함에서 관련 교훈과 파일을 골라 읽습니다. Figure 7에서 기준 실행·시험 실행·개선 보관함 없이 직접 고치면 Code 73.4→63.2, Web 69.9→65.0이 됩니다. k=5 보관함은 다음 한 단계 개선에서 Code·Web·Office에 +0.9, +4.4, +5.1점을 지원합니다. JobBench 보관함을 WorkBuddy에 옮긴 결과도 +0.6, +0.5, +2.9점입니다.
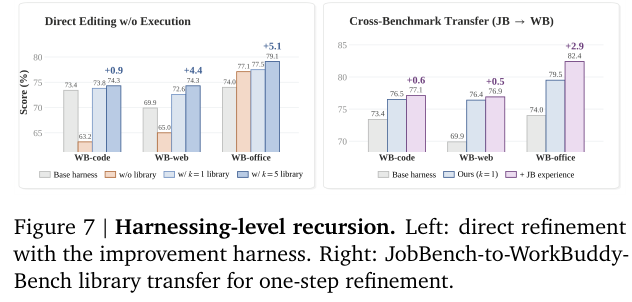
원 논문 Figure 7(논문 PDF 11쪽): 왼쪽은 개선 절차로 직접 고친 결과, 오른쪽은 JobBench library를 WorkBuddy-Bench의 한 단계 개선으로 옮긴 결과를 보여 준다. 원문 PDF에서 보기.
재사용 보관함·범위 설정·선별 결합을 제거한 k=1의 WorkBuddy/JobBench 점수는 full 77.5/36.0, 보관함 제외 74.4/34.2, 범위 설정 제외 74.6/32.3, 선별 결합 제외 75.9/34.1입니다. skills 제거 평균은 75.5, scripts 제거 평균은 77.1입니다. 이 비교는 구성 요소를 하나씩 뺀 결과이지 새로 최적화한 결과가 아닙니다.
7. 실패 사례와 저자가 밝힌 한계
논문은 후보 선택, 공유된 잘못된 전제, 실행·평가 변동이 성능 하락을 만든다고 설명합니다. 예를 들어 WB-code에서 선택기가 약한 후보를 골라 점수가 96에서 55로 내려갔고, WB-web에서는 필요한 검사 범위를 충족하지 못한 후보를 골라 100에서 70으로 내려갔습니다. 이 값은 온라인 편집기에 공개되지 않은 회고 평가입니다.
저자는 Propose·Probe·Compose의 추가 실행과 편집자 차례가 추론 비용을 늘린다고 합니다. 병렬 방식은 자원이 있으면 지연을 줄이지만 계산을 없애지 않습니다. 또한 행동 대조와 모델 판단은 실행 변동과 공유 모델 편향에 민감해 정답성이나 다른 과제로의 전이를 보장하지 않습니다. 각 과제의 실행 구성은 공통 초기 구성 H0에서 다시 시작하지만, 개선 보관함은 과제 사이에 남아 다음 개선에서 선택적으로 읽힙니다.
이 논문은 가중치를 고정한 모델 주변의 실행 구성과 그 구성을 고치는 절차를 함께 갱신합니다. 행동 대조와 benchmark 점수, 두 반복은 서로 다른 신호와 시간 범위입니다.
References
Xu, R., Chen, Y., CuiZhu, Z., Mishra, B. D., Ming, Y., Yu, H., Han, R., Lee, C.-Y., & Pfister, T. (2026). Harness2: Recursive agent harnessing for an open world [Preprint]. arXiv. https://arxiv.org/abs/2610.14224v1