Kimi Linear: An Expressive, Efficient Attention Architecture
어텐션 층 넷 중 셋을 선형으로 바꾼 Kimi Linear
Kimi Linear는 채널별 망각 게이트를 쓰는 Kimi Delta Attention(KDA)과 MLA를 3:1로 섞은 하이브리드(총 48B, 활성 3B)다. 같은 1.4T 토큰 레시피로 MLA·GDN-H와 비교한 단문맥·장문맥·RL 결과와 디코딩·프리필 속도를 측정 조건과 함께 설명한다.
Paper: Kimi Team; Yu Zhang; Zongyu Lin; Xingcheng Yao; Jiaxi Hu; Fanqing Meng; Chengyin Liu; Xin Men; Songlin Yang; Zhiyuan Li; Wentao Li; Enzhe Lu; Weizhou Liu; Yanru Chen; Weixin Xu; Longhui Yu; Yejie Wang; Yu Fan; Longguang Zhong; Enming Yuan; Dehao Zhang; Yizhi Zhang; T. Y. Liu; Haiming Wang; Shengjun Fang; Weiran He; Shaowei Liu; Yiwei Li; Jianlin Su; Jiezhong Qiu; Bo Pang; Junjie Yan; Zhejun Jiang; Weixiao Huang; Bohong Yin; Jiacheng You; Chu Wei; Zhengtao Wang; Chao Hong; Yutian Chen; Guanduo Chen; Yucheng Wang; Huabin Zheng; Feng Wang; Yibo Liu; Mengnan Dong; Zheng Zhang; Siyuan Pan; Wenhao Wu; Yuhao Wu; Longyu Guan; Jiawen Tao; Guohong Fu; Xinran Xu; Yuzhi Wang; Guokun Lai; Yuxin Wu; Xinyu Zhou; Zhilin Yang; Yulun Du (2025). "Kimi Linear: An Expressive, Efficient Attention Architecture". arXiv preprint, arXiv:2510.26692v2, 2025년 11월 1일(최초 공개 2025년 10월 30일), 28쪽. PDF · arXiv
언어 모델이 긴 글을 다룰 때는 앞서 읽은 내용을 저장하는 KV 캐시가 계속 커지고, 글자 하나를 생성하는 시간도 늘어납니다. Kimi Linear는 이 비용을 줄이기 위해 대부분의 층을 고정 크기의 기억을 쓰는 선형 어텐션으로 바꾸고, 일부 층에만 전체 어텐션을 남긴 모델입니다. 논문은 같은 데이터와 같은 학습 방식으로 만든 기준 모델과 품질·속도를 비교합니다.
1. 선형 어텐션은 고정된 크기의 기억을 씁니다
일반적인 어텐션은 새 토큰을 만들 때마다 이전 토큰 전부를 다시 봅니다. 선형 어텐션은 지금까지의 정보를 일정한 크기의 상태(state)에 요약해 두고, 새 토큰이 들어올 때마다 이 상태를 갱신합니다. 그래서 문맥이 길어져도 저장 공간이 늘지 않습니다. 대신 상태의 크기가 정해져 있어, 긴 문맥에서 필요한 정보를 정확히 꺼내기가 어렵습니다.
Gated DeltaNet(GDN)은 이 상태를 갱신할 때 두 가지를 씁니다. 망각 게이트는 오래된 정보를 얼마나 줄일지 정하고, 델타 규칙은 같은 key 자리에 이미 저장된 값을 고쳐 씁니다. GDN의 망각 게이트는 상태 전체에 같은 값을 곱하는 스칼라입니다.
2. KDA는 기억의 칸마다 다른 속도로 잊게 합니다
논문이 제안한 Kimi Delta Attention(KDA)은 망각 게이트를 key 차원마다 따로 둡니다. 상태의 각 행이 서로 다른 속도로 정보를 잊을 수 있으므로, 중요한 정보는 오래 남기고 불필요한 정보는 빨리 지우는 조절이 더 세밀해집니다. 모든 차원의 게이트 값이 같으면 KDA는 GDN과 같아집니다.
학습 속도를 위해 저자들은 긴 시퀀스를 묶음(청크)으로 나눠 행렬곱으로 계산하는 전용 커널을 만들었습니다. 일반적인 대각+저랭크(DPLR) 형태보다 계산할 행렬이 적은 제약형 구조를 써서, 배치 1·16 head 조건의 커널 실행 시간 비교에서 거의 2배 빠르다고 보고합니다.
3. KDA 셋에 전체 어텐션 하나를 섞습니다
Kimi Linear는 KDA 층 세 개마다 전체 어텐션인 MLA 층 하나를 둡니다. MLA는 key와 value를 압축된 잠재 벡터로 저장하는 어텐션입니다. 층 구성 뒤에는 256개 전문가(expert) 중 8개만 쓰는 MoE 층이 붙으며, 모델 전체는 48B, 한 토큰에 실제로 쓰는 파라미터는 3B입니다. MLA 층에는 위치 정보를 넣지 않고(NoPE), 위치는 KDA 층이 담당하게 합니다.
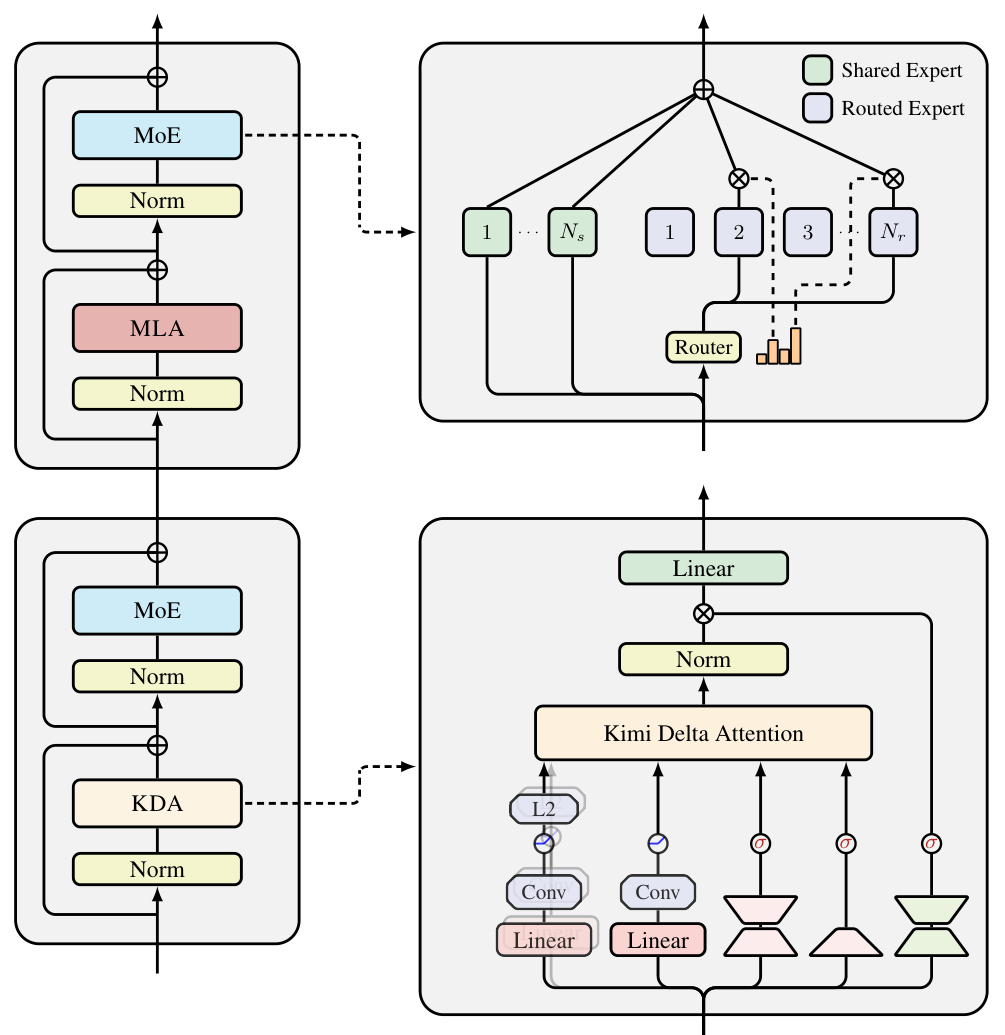
그림 1. Kimi Team (2025), Figure 3, arXiv v2 PDF p.6. KDA 층과 MLA 층, 그 뒤의 MoE 층 구성입니다.
3:1 비율은 작은 모델의 비교(Table 1)에서 정했습니다. 검증 퍼플렉서티(PPL, 낮을수록 좋음)가 3:1에서 5.65로 가장 낮았고, 1:1은 5.66, 7:1은 5.70, 순수 MLA는 5.77이었습니다. 전체 층의 4분의 1만 KV 캐시를 가지므로, 같은 층 수의 완전 MLA보다 캐시가 최대 75% 줄어듭니다.
4. 같은 1.4T 토큰으로 기준 모델과 비교합니다
비교에 쓴 세 모델은 MLA만 쓴 모델, GDN 하이브리드(GDN-H), Kimi Linear입니다. 세 모델은 같은 크기, 같은 1.4T 토큰 데이터, 같은 학습률과 배치, 같은 후학습 방법을 사용합니다. 다섯 크기로 측정한 스케일링 법칙에서는 같은 손실에 도달할 때 MLA보다 약 1.16배 계산 효율이 좋다고 보고합니다. 이때 MLA만 크기별 하이퍼파라미터를 탐색했고 Kimi Linear는 그 설정을 그대로 썼습니다.
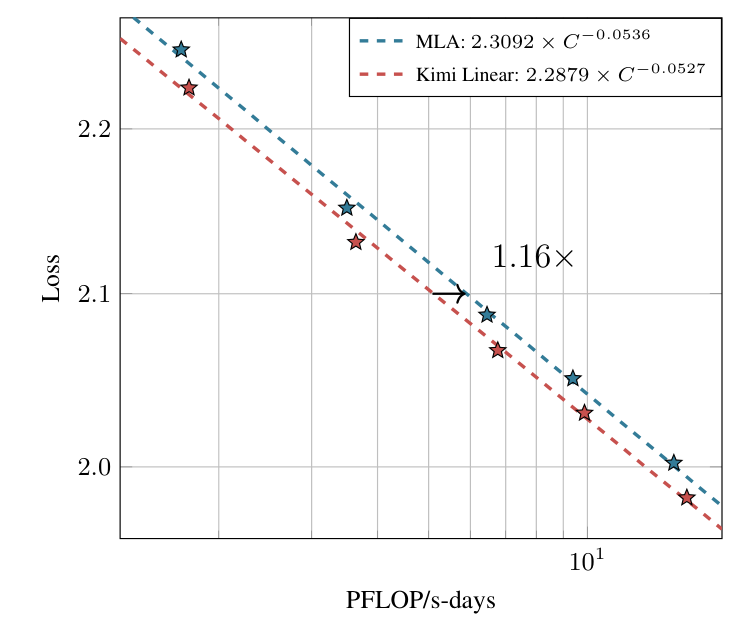
그림 2. Kimi Team (2025), Figure 5, arXiv v2 PDF p.9. 다섯 크기의 손실과 두 구조의 적합 곡선입니다.
사전학습 모델 비교(Table 3)에서 Kimi Linear는 14개 지표 중 12개에서 가장 높았습니다. MMLU-Pro는 MLA 47.2, GDN-H 47.9, Kimi Linear 51.0이었습니다. MATH는 MLA와 같았고 EvalPlus는 GDN-H가 가장 높았습니다. 후학습 비교(Table 4)에서는 12개 중 9개에서 가장 높았으며, GPQA-Diamond는 MLA 57.1, GDN-H 58.6, Kimi Linear 62.1이었습니다. LiveBench와 MATH500은 GDN-H, EvalPlus는 MLA가 높았습니다.
5. 긴 문맥과 강화학습에서도 비교합니다
128k 길이의 장문맥 평가(Table 5)에서 8개 지표 평균은 Kimi Linear 54.5, MLA 52.2, GDN-H 51.2입니다. RULER는 84.3으로 MLA 81.3보다 높았고, MRCR·RepoQA·LCA Lib에서도 앞섰습니다. LongBench V2, Frames, LCA Commit에서는 MLA가 더 높았습니다. MLA 층에 위치 부호화를 넣은 변형은 평균 51.8로, NoPE를 쓴 원래 모델(54.5)보다 낮았습니다.
수학 문제로 강화학습을 진행한 곡선(Figure 6)에서는 같은 알고리즘과 설정으로 학습했을 때 Kimi Linear의 훈련 정확도가 더 빨리 오르고, MATH500과 AIME 2025 시험 정확도도 더 높게 유지되었습니다.
6. 속도 수치는 측정 조건을 함께 봐야 합니다
TPOT은 출력 토큰 하나를 만드는 시간입니다. 배치 크기 1에서 1M 토큰 길이일 때 Kimi Linear의 디코딩은 MLA보다 2.2배, 프리필(입력을 처음 읽는 단계)은 2.9배 빨랐습니다. 4k–16k 같은 짧은 길이의 프리필은 MLA와 비슷했고, 128k 이상에서 차이가 커졌습니다.
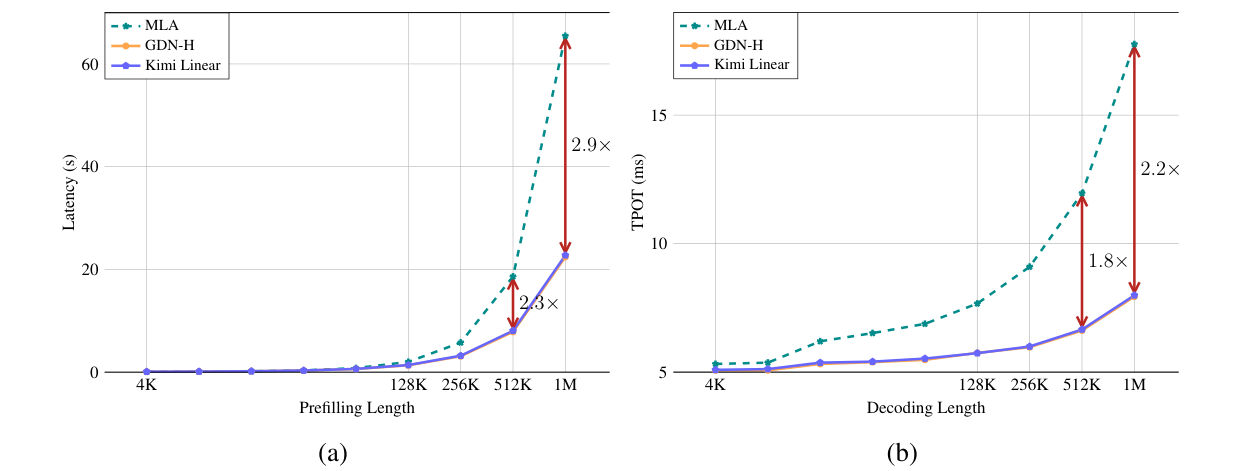
그림 3. Kimi Team (2025), Figure 7, arXiv v2 PDF p.13. 배치 크기 1에서 측정한 프리필 시간과 디코딩 TPOT입니다.
Figure 1의 6.3배(1.84ms 대 11.48ms)는 다른 조건입니다. 캐시가 작아 더 큰 배치를 처리할 수 있게 된 상황의 1M 길이 TPOT입니다. 그래서 배치 1에서 측정한 2.2배와 같은 비교가 아닙니다.
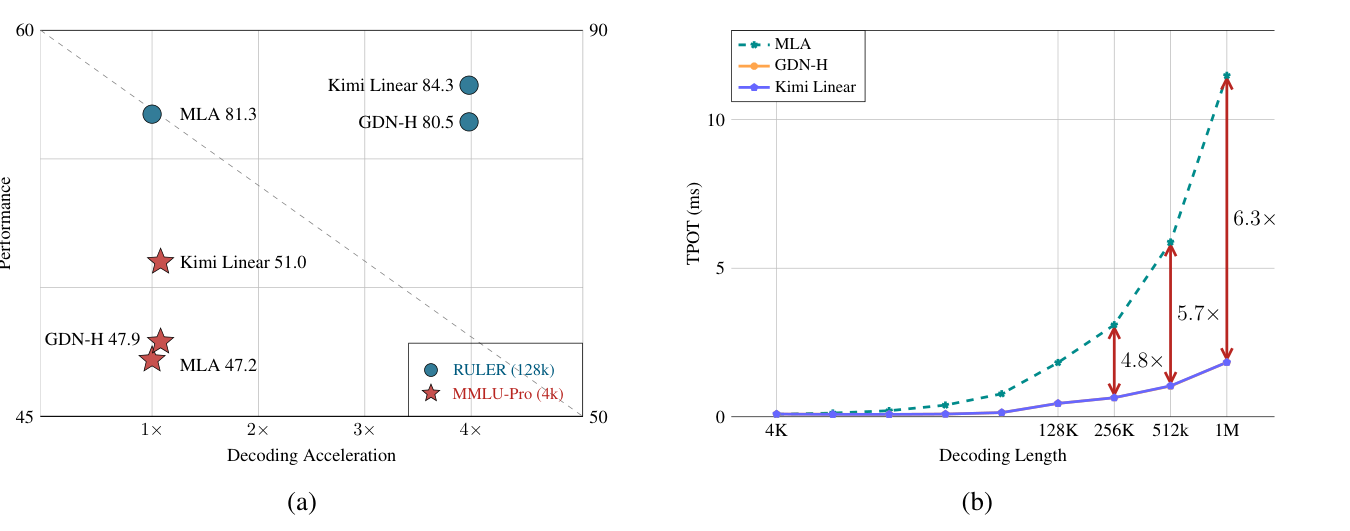
그림 4. Kimi Team (2025), Figure 1, arXiv v2 PDF p.1. 성능 대 가속과, 더 큰 배치를 허용하는 조건의 디코딩 길이별 TPOT입니다.
7. 공개 모델과 저자들이 밝힌 한계
저자들은 5.7T 토큰으로 더 학습한 모델을 공개하고, 같은 활성 3B이지만 총 16B인 Moonlight와 비교해 거의 모든 벤치마크에서 높다고 보고합니다. 이 모델은 1M 문맥 RULER에서 94.8을 기록했습니다. 총 파라미터가 48B 대 16B로 다르므로, 이 비교는 MLA·GDN-H와 같은 레시피로 학습한 1.4T 비교와 별개입니다.
저자들은 순수 선형 구조는 상태 용량이 유한해 긴 문맥 회수가 어렵다고 설명하고 이를 하이브리드로 보완합니다. 스케일링 법칙에서 Kimi Linear가 MLA 설정을 그대로 썼다는 점, NoPE의 이점은 가설이라는 점, Mamba2의 합성 과제 결과는 해당 설정에 한정된다는 점을 함께 밝힙니다. 선형 어텐션과 희소(sparse) 어텐션의 결합은 향후 과제로 남겼습니다.
References
Kimi Team, Zhang, Y., Lin, Z., Yao, X., Hu, J., Meng, F., Liu, C., Men, X., Yang, S., Li, Z., Li, W., Lu, E., Liu, W., Chen, Y., Xu, W., Yu, L., Wang, Y., Fan, Y., Zhong, L., . . . Du, Y. (2025). Kimi Linear: An expressive, efficient attention architecture [Preprint]. arXiv. https://arxiv.org/abs/2510.26692v2