Kimi Linear: An Expressive, Efficient Attention Architecture
어텐션 층 넷 중 셋을 선형으로 바꾼 하이브리드: Kimi Linear
Kimi Linear는 채널별 망각 게이트를 쓰는 Kimi Delta Attention(KDA)과 MLA를 3:1로 섞은 하이브리드(총 48B, 활성 3B)다. 같은 1.4T 토큰 레시피로 MLA·GDN-H와 비교한 단문맥·장문맥·RL 결과와 디코딩·프리필 속도를 측정 조건과 함께 설명한다.
Paper: Kimi Team; Yu Zhang; Zongyu Lin; Xingcheng Yao; Jiaxi Hu; Fanqing Meng; Chengyin Liu; Xin Men; Songlin Yang; Zhiyuan Li; Wentao Li; Enzhe Lu; Weizhou Liu; Yanru Chen; Weixin Xu; Longhui Yu; Yejie Wang; Yu Fan; Longguang Zhong; Enming Yuan; Dehao Zhang; Yizhi Zhang; T. Y. Liu; Haiming Wang; Shengjun Fang; Weiran He; Shaowei Liu; Yiwei Li; Jianlin Su; Jiezhong Qiu; Bo Pang; Junjie Yan; Zhejun Jiang; Weixiao Huang; Bohong Yin; Jiacheng You; Chu Wei; Zhengtao Wang; Chao Hong; Yutian Chen; Guanduo Chen; Yucheng Wang; Huabin Zheng; Feng Wang; Yibo Liu; Mengnan Dong; Zheng Zhang; Siyuan Pan; Wenhao Wu; Yuhao Wu; Longyu Guan; Jiawen Tao; Guohong Fu; Xinran Xu; Yuzhi Wang; Guokun Lai; Yuxin Wu; Xinyu Zhou; Zhilin Yang; Yulun Du (2025). "Kimi Linear: An Expressive, Efficient Attention Architecture". arXiv preprint, arXiv:2510.26692v2, 2025년 11월 1일(최초 공개 2025년 10월 30일), 28쪽. PDF · arXiv
Softmax 어텐션은 문맥이 길어질수록 KV 캐시와 디코딩 시간이 함께 늘어난다. 선형 어텐션은 고정 크기의 상태를 갱신하므로 이 비용이 일정하지만, 상태 용량이 유한해 긴 문맥의 정보를 회수하기 어렵다. 이 논문은 Gated DeltaNet(GDN)의 스칼라 망각 게이트를 채널별 게이트로 바꾼 Kimi Delta Attention(KDA)을 제안하고, KDA 3개 층마다 MLA 1개 층을 두는 하이브리드를 총 48B·활성 3B의 MoE 모델로 학습한다.
저자들은 같은 1.4T 토큰과 같은 학습 레시피로 학습한 풀 MLA와 GDN 하이브리드(GDN-H)를 기준선으로 두고 단문맥, 장문맥, 강화학습(RL) 결과를 비교한다. 효율 수치는 측정 조건이 서로 달라, 아래에서는 75%, 6.3×, 2.2×, 2.9× 같은 값을 각각의 조건과 함께 적는다.
요약
| 항목 | 논문의 설계와 결과 |
|---|---|
| KDA | GDN의 스칼라 게이트 α_t를 대각 행렬 Diag(α_t)로 일반화한 델타 규칙 모듈이다. |
| 커널 | 일반 Diagonal-Plus-Low-Rank(DPLR) 전이를 KDA 형태로 제약해 청크 계산을 줄인다. |
| 구조 | KDA:MLA를 3:1로 층 단위 혼합하고 MLA 층에는 위치 부호화를 쓰지 않는다(NoPE). 256개 expert 중 8개 활성 MoE다. |
| 스케일링 | 다섯 크기의 적합 곡선에서 MLA 대비 약 1.16× 계산 효율을 보고한다. |
| 단문맥·장문맥 | 1.4T 비교에서 Table 3의 14개 중 12개, Table 4의 12개 중 9개 지표에서 가장 높고, Table 5 평균 54.5(MLA 52.2)로 가장 높다. |
| 효율 | 3:1 비율로 KV 캐시를 최대 75% 줄이고, 배치 1에서 1M 길이 프리필 2.9×·디코딩 2.2×를 보고한다. |
목차
- KDA: 채널별 게이트를 쓰는 델타 규칙
- 청크 병렬 알고리즘과 제약형 DPLR
- 3:1 하이브리드, NoPE와 구성요소 비교
- 합성 과제와 스케일링 법칙
- 1.4T 비교의 학습 조건과 단문맥 결과
- 장문맥 Table 5와 RL 곡선
- 효율 측정, 5.7T 공개 모델과 저자 한계
1. KDA: 채널별 게이트를 쓰는 델타 규칙
GDN은 상태 S_{t-1} 전체에 스칼라 망각률 α_t를 곱한 뒤 델타 규칙으로 갱신한다(p.3).
S_t=\alpha_t\left(I-\beta_t k_t k_t^{\top}\right)S_{t-1}+\beta_t k_t v_t^{\top},\qquad \alpha_t\in[0,1].여기서 k_t, v_t는 key와 value, β_t는 쓰기 강도다. 델타 규칙의 (I − β_t k_t k_tᵀ) 항은 같은 key 방향에 이미 저장된 값을 일부 지우고 새 값을 쓰게 한다. KDA는 망각률을 key 차원마다 따로 두어, 상태의 행마다 다른 속도로 정보를 잊게 한다. 논문의 Eq. (1)은 다음과 같다(p.4).
\begin{aligned}
S_t&=\left(I-\beta_t k_t k_t^{\top}\right)\mathrm{Diag}(\alpha_t)\,S_{t-1}+\beta_t k_t v_t^{\top}\in\mathbb{R}^{d_k\times d_v},\\
o_t&=S_t^{\top}q_t\in\mathbb{R}^{d_v}.
\end{aligned}α_t가 모든 성분이 같은 스칼라이면 Diag(α_t)가 α_t I가 되어 GDN과 같아진다. 저자들은 KDA를 GLA와 비슷한 채널별 게이트에 델타 규칙을 더한 형태로 설명한다(p.2). 출력에는 저랭크 시그모이드 게이트와 head별 RMSNorm을 둔다(Eq. 10, p.6).
o_t=W_o\left(\mathrm{Sigmoid}\!\left(W_g^{\uparrow}W_g^{\downarrow}x_t\right)\odot\mathrm{RMSNorm}\!\left(\mathrm{KDA}(q_t,k_t,v_t,\alpha_t,\beta_t)\right)\right).| 모델 | 망각 게이트 | 델타 규칙 | 논문 안의 실험 |
|---|---|---|---|
| GDN | 데이터 의존 스칼라(head 단위) | 있음 | 하이브리드 GDN-H로 Table 3–5, 단독 GDN으로 Fig. 4 |
| KDA | 채널별 Diag(α_t) | 있음 | 제안 모듈 |
| GLA | 채널별 Diag(α_t) | 없음 | 수식 비교(Table 6·7) |
| Mamba2 | 데이터 의존 스칼라 | 없음 | 합성 과제 Fig. 4 |
| RWKV-7 | 대각 감쇠와 저랭크 보정 | 델타형 보정 | 수식 비교(Table 6·7) |
2. 청크 병렬 알고리즘과 제약형 DPLR
학습에서는 긴 시퀀스를 청크로 나누고, 청크 안의 rank-1 갱신을 WY 표현과 UT 변환으로 묶어 밀집 행렬곱으로 계산한다(Eq. 2–9, p.4–5). 저자들은 KDA를 일반 DPLR 전이 D − a_t b_tᵀ의 제약형으로 본다(§6.2, p.14).
D=\mathrm{Diag}(\alpha_t),\qquad a_t=\beta_t k_t,\qquad b_t=k_t\odot\alpha_t.a와 b가 모두 k에서 나오므로, 청크 안에서 계산할 2차 행렬이 일반 DPLR의 네 개(A_qk, A_qb, A_ab, A_ak)에서 두 개(A_qk, A_kk)로 줄고 행렬곱 세 개가 빠진다(p.5, p.15). Fig. 2는 배치 1, 16 head에서 입력 길이 2K–64K의 커널 시간을 비교하며, 저자들은 KDA 커널이 일반 DPLR보다 거의 2배 빠르다고 보고한다. 이 비교는 커널 실행 시간이다.
저자들은 KDA의 특수화된 DPLR 변형이 일반 DPLR보다 계산을 줄이면서 고전 델타 규칙과 더 일관된다고 설명한다(p.1–2). Table 7 각주는 GDN과 KDA의 갱신을, 스칼라 또는 채널별 게이트로 감쇠한 상태 S̃에 대한 SGD로 볼 수 있다고 쓴다(p.16). 훈련 FLOPs 식은 다음과 같다(Eq. 13).
\mathrm{FLOPs}_{\mathrm{KDA}}=6Td_h^2+3TCd_h+TC^2,T는 시퀀스 길이, d_h는 head 차원, C는 청크 크기다.
3. 3:1 하이브리드, NoPE와 구성요소 비교
각 블록은 토큰 혼합 층 하나와 MoE 채널 혼합 층 하나로 이루어지고, 토큰 혼합 층은 KDA 3개마다 MLA 1개를 둔다(Fig. 3, p.6). 뼈대는 Moonlight를 따르며 256개 expert 중 공유 expert 1개를 포함한 8개를 활성화하고(sparsity 32), 첫 층은 dense다(p.9).
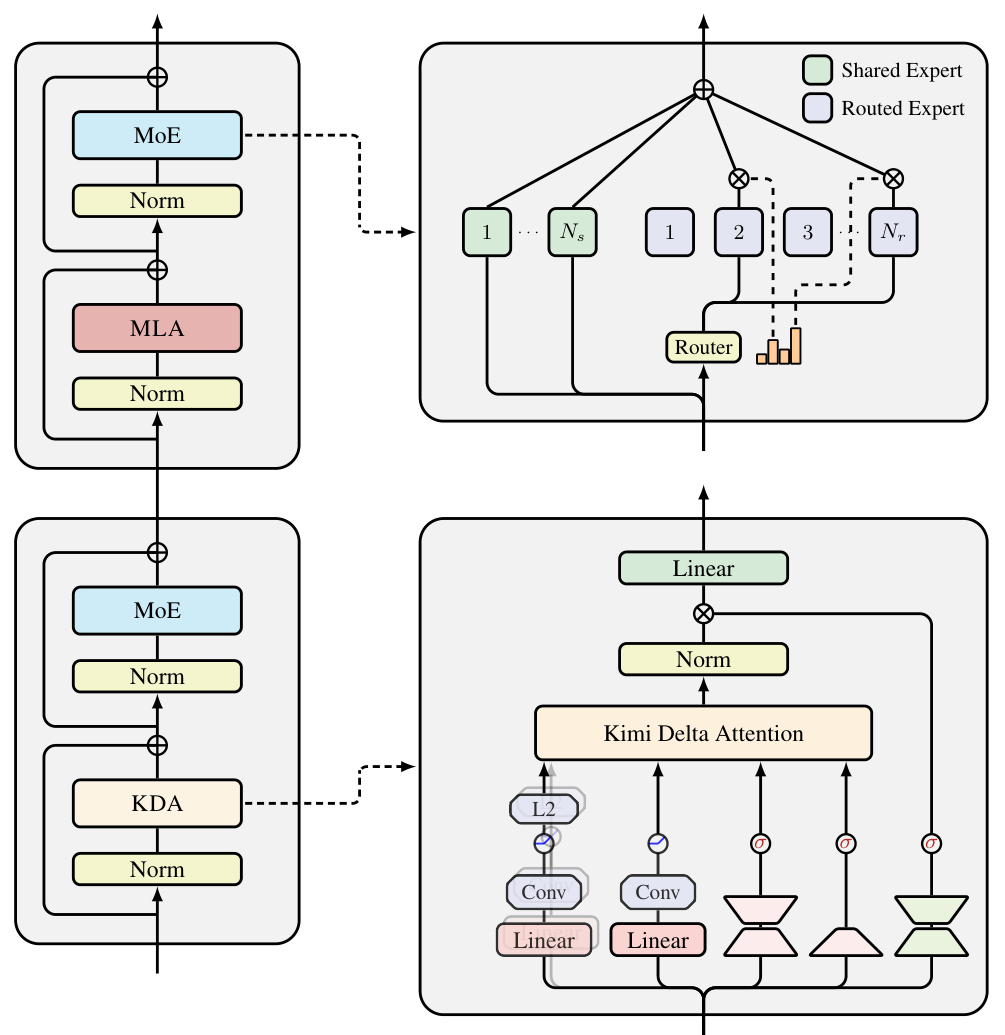
그림 1. Kimi Team (2025), Figure 3, arXiv v2 PDF p.6. KDA 층과 MLA 층 뒤에 공유·라우팅 expert로 구성된 MoE 층이 온다. 오른쪽 아래는 KDA 모듈의 입력 투영, 짧은 합성곱, 게이트와 출력 정규화다.
MLA 층에는 위치 부호화를 쓰지 않는다(NoPE). 저자들은 위치 정보를 KDA 층이 맡게 하면 층 간 위치 편향이 균형을 이뤄 긴 문맥에 유리하다고 가설로 제시한다(p.6, p.8). 3:1이 정확히 반복되면 전체 층의 4분의 1만 KV 캐시를 가지므로, 같은 층 수의 완전 MLA보다 캐시가 최대 75% 줄어든다. 기준은 K/V를 latent로 압축하는 MLA다.
Table 1은 16 head·16 layer의 첫 스케일링 모델에서 하이브리드 비율과 구성요소를 비교한다(p.8).
| 변형 | 훈련 PPL | 검증 PPL |
|---|---|---|
| 3:1 (기본) | 9.23 | 5.65 |
| 0:1 (순수 MLA) | 9.45 | 5.77 |
| 1:1 | 9.29 | 5.66 |
| 7:1 | 9.23 | 5.70 |
| 15:1 | 9.34 | 5.82 |
| 출력 게이트 없음 | 9.25 | 5.67 |
| swish 출력 게이트 | 9.43 | 5.81 |
| 합성곱 없음 | 9.29 | 5.70 |
표 1. Kimi Team (2025), Table 1, p.8. PPL은 낮을수록 좋다.
3:1은 검증 PPL이 가장 낮고, 훈련 PPL은 7:1과 같다. 저자들은 3:1을 품질과 처리량의 균형점으로 선택하고 다른 혼합 전략은 §7.2에서 논의한다. 시그모이드 출력 게이트와 합성곱 층을 빼거나 바꾸면 검증 PPL이 높아진다.
4. 합성 과제와 스케일링 법칙
합성 과제는 2층·head 2개·head 차원 128의 작은 모델로 Palindrome, MQAR(multi-query associative recall), Stack을 학습한다(p.7–8). 과제마다 최대 20,000 step 동안 학습률 {5×10⁻⁵, 1×10⁻⁴, 5×10⁻⁴, 1×10⁻³}를 탐색하고 가장 좋은 훈련 정확도 곡선을 제시한다. 저자들은 학습 길이를 256에서 2,048로 늘릴 때 KDA가 세 과제 모두에서 가장 높은 정확도를 보이고, 1,024 길이 고정 조건에서 Palindrome·MQAR에서 GDN보다 빨리 수렴하며, Mamba2는 이 설정에서 세 과제를 모두 풀지 못한다고 보고한다.
스케일링 법칙은 Moonlight 구조의 MoE 다섯 크기로 측정한다(Table 2, p.9). 모든 모델은 4,096 문맥으로 학습했고, 활성 파라미터 수에서 임베딩은 제외한다.
| 활성 파라미터 | head·layer | hidden | 학습 토큰 | 학습률 |
|---|---|---|---|---|
| 653M | 16 | 1,216 | 38.8B | 2.006×10⁻³ |
| 878M | 18 | 1,376 | 59.8B | 1.790×10⁻³ |
| 1.1B | 20 | 1,536 | 85.2B | 1.617×10⁻³ |
| 1.4B | 22 | 1,632 | 102.5B | 1.486×10⁻³ |
| 1.7B | 24 | 1,776 | 128.0B | 1.371×10⁻³ |
표 2. Kimi Team (2025), Table 2, p.9의 일부.
MLA는 Chinchilla 방법론에 따라 크기별 하이퍼파라미터를 탐색했고, Kimi Linear는 하이브리드 비율 외에는 MLA 설정을 그대로 사용했다(p.9). 저자들은 별도 튜닝을 하면 Kimi Linear 곡선이 더 좋아질 것으로 기대한다. 손실을 계산량 C(PFLOP/s-day)의 함수로 적합한 결과는 다음과 같다.
\begin{aligned}
L_{\mathrm{MLA}}(C)&=2.3092\,C^{-0.0536},\\
L_{\mathrm{Kimi}}(C)&=2.2879\,C^{-0.0527}.
\end{aligned}
저자들은 compute-optimal 학습 조건에서 MLA 대비 약 1.16× 계산 효율을 보고한다(Fig. 5, p.9).
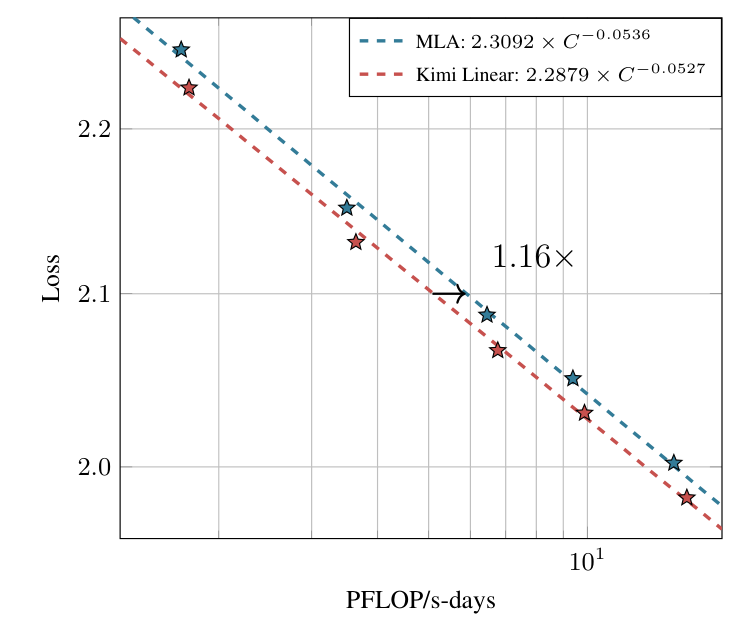
그림 2. Kimi Team (2025), Figure 5, arXiv v2 PDF p.9. 다섯 크기에서 측정한 손실과 MLA·Kimi Linear의 적합 곡선, 1.16× 표기다.
5. 1.4T 비교의 학습 조건과 단문맥 결과
세 모델(MLA, GDN-H, Kimi Linear)은 같은 구조 크기·파라미터 수·학습 설정을 쓴다(p.9). 4,096 문맥, MuonClip 옵티마이저, WSD 학습률 일정으로 Kimi K2 사전학습 코퍼스에서 뽑은 1.4T 토큰을 학습하고, 학습률 1.1×10⁻³, 전역 배치 32M 토큰, 같은 annealing과 장문맥 활성화 단계를 적용한다(p.10). GDN-H에도 같은 Sigmoid 출력 게이트를 적용한다(p.8). 후학습에서도 세 모델에 같은 SFT 레시피를 쓴다(p.11).
Table 3은 사전학습 모델의 결과다(p.11).
| 벤치마크 | MLA | GDN-H | Kimi Linear |
|---|---|---|---|
| HellaSwag | 81.7 | 82.2 | 82.9 |
| ARC-challenge | 64.6 | 66.5 | 67.3 |
| Winogrande | 78.1 | 77.9 | 78.6 |
| BBH | 71.6 | 70.6 | 72.9 |
| MMLU | 71.6 | 72.2 | 73.8 |
| MMLU-Pro | 47.2 | 47.9 | 51.0 |
| TriviaQA | 68.9 | 70.1 | 71.7 |
| GSM8K | 83.7 | 81.7 | 83.9 |
| MATH | 54.7 | 54.1 | 54.7 |
| EvalPlus | 59.5 | 63.1 | 60.2 |
| CRUXEval-I-cot | 51.6 | 56.0 | 56.6 |
| CRUXEval-O-cot | 61.5 | 58.1 | 62.0 |
| CEval | 79.3 | 79.1 | 79.5 |
| CMMLU | 79.5 | 80.7 | 80.8 |
표 3. Kimi Team (2025), Table 3, p.11. 1.4T 사전학습 모델 비교.
Kimi Linear는 14개 중 12개 지표에서 두 기준선보다 높다. MATH는 MLA와 같고, EvalPlus는 GDN-H(63.1)가 가장 높다. Table 4는 SFT 후 결과다(p.11).
| 벤치마크 | MLA | GDN-H | Kimi Linear |
|---|---|---|---|
| BBH | 68.2 | 68.5 | 69.4 |
| MMLU | 75.7 | 75.6 | 77.0 |
| MMLU-Pro | 65.7 | 64.8 | 67.4 |
| MMLU-Redux | 79.2 | 78.7 | 80.3 |
| GPQA-Diamond (Avg@8) | 57.1 | 58.6 | 62.1 |
| LiveBench (Pass@1) | 45.7 | 46.4 | 45.2 |
| AIME 2025 (Avg@64) | 20.6 | 21.1 | 21.3 |
| MATH500 | 80.8 | 83.0 | 81.2 |
| HMMT 2025 (Avg@32) | 11.3 | 11.3 | 12.5 |
| PolyMath-en (Avg@4) | 41.3 | 41.5 | 43.6 |
| LiveCodeBench v6 (Pass@1) | 25.1 | 25.4 | 26.0 |
| EvalPlus | 62.6 | 62.5 | 61.0 |
표 4. Kimi Team (2025), Table 4, p.11. 같은 SFT 레시피 적용 후 비교.
12개 중 9개 지표에서 Kimi Linear가 가장 높다. LiveBench와 MATH500은 GDN-H, EvalPlus는 MLA가 가장 높다. 저자들은 MATH500과 EvalPlus를 작은 예외로 언급한다(p.11). Avg@k는 k번 샘플링한 정확도의 평균이다.
6. 장문맥 Table 5와 RL 곡선
Table 5는 128k 문맥에서 네 모델을 비교한다(p.12). Kimi Linear (RoPE)는 MLA 층에 RoPE를 쓴 변형이다.
| 벤치마크 | MLA | GDN-H | Kimi Linear (RoPE) | Kimi Linear |
|---|---|---|---|---|
| RULER | 81.3 | 80.5 | 78.8 | 84.3 |
| MRCR | 22.6 | 23.9 | 22.0 | 29.6 |
| HELMET-ICL | 88.0 | 85.5 | 88.0 | 90.0 |
| LongBench V2 | 36.1 | 32.6 | 35.4 | 35.0 |
| Frames | 60.5 | 58.7 | 59.9 | 58.8 |
| RepoQA | 63.0 | 63.0 | 66.5 | 68.5 |
| LCA Lib | 32.8 | 34.7 | 31.3 | 37.1 |
| LCA Commit | 33.2 | 30.5 | 32.5 | 32.7 |
| 평균 | 52.2 | 51.2 | 51.8 | 54.5 |
표 5. Kimi Team (2025), Table 5, p.12. 128k 장문맥 비교.
Kimi Linear는 평균 54.5로 가장 높고 RULER·MRCR·HELMET-ICL·RepoQA·LCA Lib에서 앞선다. LongBench V2, Frames, LCA Commit은 MLA가 가장 높다. Kimi Linear (RoPE)의 평균은 51.8로 NoPE를 쓴 Kimi Linear(54.5)보다 낮으며, 저자들은 Table 5의 장문맥 결과를 NoPE 선택의 근거로 든다(p.8).
RL은 같은 알고리즘과 하이퍼파라미터로 MLA와 Kimi Linear를 수학 문제에 학습한 곡선이다(Fig. 6, p.12). 저자들은 학습 과정 전체에서 Kimi Linear의 훈련 정확도가 더 빠르게 오르고, MATH500·AIME 2025 시험 정확도도 더 높게 유지된다고 보고한다.
7. 효율 측정, 5.7T 공개 모델과 저자 한계
효율 수치는 그림마다 측정 조건이 다르다.
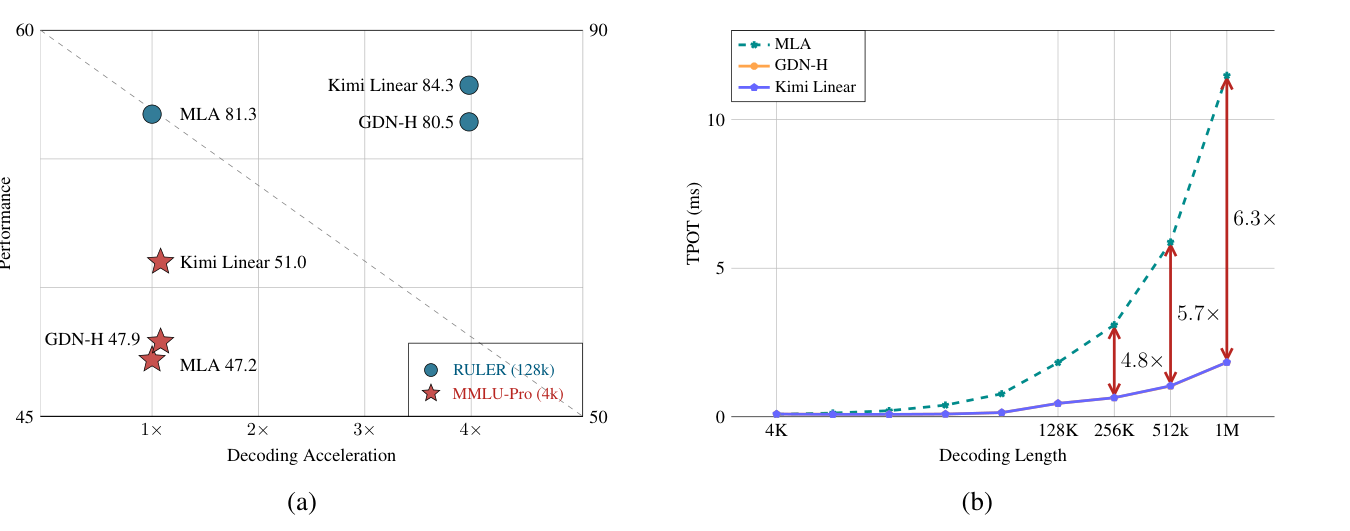
그림 3. Kimi Team (2025), Figure 1, arXiv v2 PDF p.1. (a) MMLU-Pro(4k)와 RULER(128k)의 성능 대 가속, (b) 디코딩 길이별 TPOT. 캡션은 낮은 TPOT이 더 큰 배치를 가능하게 해 1M에서 6.3× 빠른 TPOT을 얻는다고 설명한다.
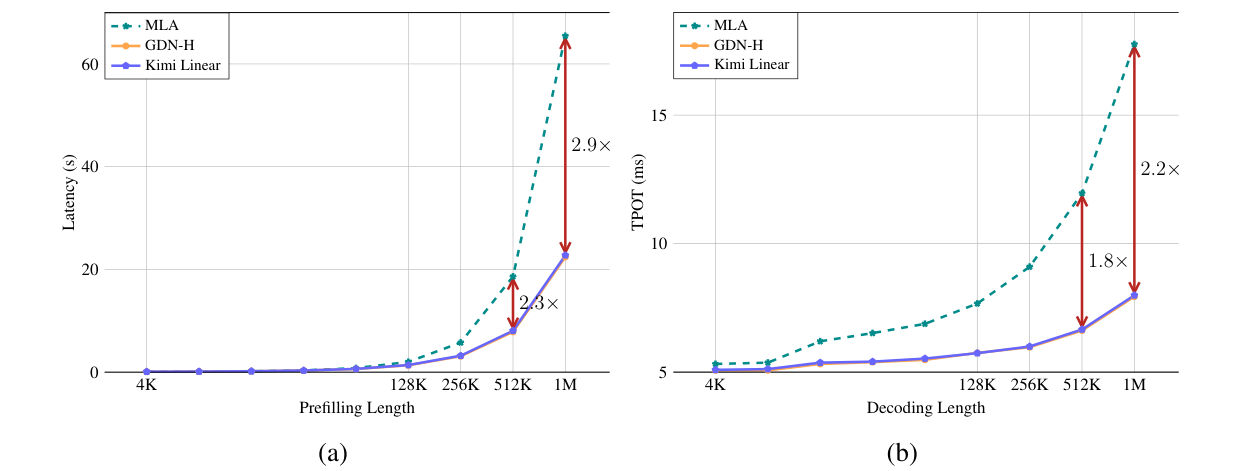
그림 4. Kimi Team (2025), Figure 7, arXiv v2 PDF p.13. 배치 크기 1에서 측정한 (a) 프리필 시간과 (b) 디코딩 TPOT. 1M에서 프리필 2.9×, 디코딩 2.2×다.
| 수치 | 값 | 조건 |
|---|---|---|
| KV 캐시 절감 | 최대 75% | 3:1 층 비율에서 완전 MLA 대비 |
| 디코딩 TPOT | 6.3× (1.84 ms 대 11.48 ms, 1M) | Fig. 1(b), 더 큰 배치를 허용하는 조건 |
| 디코딩 TPOT | 2.2× (1M), 1.8× (512K) | Fig. 7(b), 배치 1 |
| 프리필 | 2.9× (1M), 2.3× (512K) | Fig. 7(a), 배치 1 |
| RULER 가속 | 3.98× | Fig. 1(a), 128k |
TPOT(time per output token)은 출력 토큰 하나를 만드는 데 걸리는 시간이다. 저자들은 4k–16k 길이에서는 프리필 속도가 MLA와 비슷하고 128k 이상에서 차이가 커지며, 프리필에서 GDN-H와 Kimi Linear의 곡선은 거의 구별되지 않는다고 설명한다(p.12–13).
App. D는 5.7T 토큰으로 학습한 공개 체크포인트를 Moonlight(활성 3B, 총 16B)와 비교한다(Table 8·9, p.28). 저자들은 3× sparsity와 새 어텐션 구조로 거의 모든 벤치마크에서 Moonlight보다 높다고 쓰고, 5.7T 모델은 1M 문맥 RULER에서 94.8을 기록한다. Moonlight-Instruct는 8K를 넘는 과제에서 평가되지 않았다. 이 비교는 MLA·GDN-H와의 1.4T 비교와 별개다.
저자들은 순수 선형 구조가 유한 상태 용량 때문에 긴 시퀀스 모델링과 문맥 내 회수에 이론적 어려움이 있다고 설명하고(p.2), 이를 하이브리드로 보완한다. 스케일링 법칙에서 Kimi Linear는 MLA의 하이퍼파라미터를 그대로 썼으며(p.9), NoPE의 이점은 층 간 위치 편향에 대한 가설로 제시한다(p.8). Mamba2의 합성 과제 실패는 해당 모델 설정에 한정하고(p.8), 선형 어텐션과 sparse attention의 결합은 향후 과제로 남긴다(p.17).
References
Kimi Team, Zhang, Y., Lin, Z., Yao, X., Hu, J., Meng, F., Liu, C., Men, X., Yang, S., Li, Z., Li, W., Lu, E., Liu, W., Chen, Y., Xu, W., Yu, L., Wang, Y., Fan, Y., Zhong, L., . . . Du, Y. (2025). Kimi Linear: An expressive, efficient attention architecture [Preprint]. arXiv. https://arxiv.org/abs/2510.26692v2