UltraBERT: Beyond the Limit of BERT Pre-Training
분류와 검색을 함께 겨냥한 인코더 사전학습
UltraBERT는 5%·50% 마스킹 시퀀스를 4:1로 섞고 LM head를 나누며, 저자들은 1.3B 교사에서 증류한 150M·380M 모델의 분류·검색 결과를 보고합니다.
Paper: Jungwoo Park; Taewhoo Lee; Jaewoo Kang (2026). "UltraBERT: Beyond the Limit of BERT Pre-Training". arXiv preprint, arXiv:2610.15028v1, 2026년 10월 10일, 31쪽. PDF · arXiv
양방향 인코더는 앞뒤 문맥을 함께 읽어 텍스트의 표현을 만듭니다. 마스킹은 입력 일부를 가리고 원래 토큰을 예측하게 하는 학습 방식이며, LM head는 그 예측을 출력하는 층입니다. B는 10억, T는 1조를 뜻하며 모델 크기와 학습 토큰 수는 구별합니다. 이 논문은 양방향 인코더의 사전학습에서 토큰 수, 마스킹 비율, 교사 모델의 지식 이전을 다시 살펴봅니다. 연구진은 분류와 검색에서 같은 사전학습 설정이 통하는지 비교한 뒤, 서로 다른 마스킹 비율을 한 모델 안에서 결합하는 UltraBERT를 제시합니다.
1. 모델 구조보다 사전학습 레시피를 살펴봅니다
UltraBERT의 질문은 인코더에 토큰을 더 투입하면 하류 성능이 계속 오르는지, 마스킹 비율이 분류와 검색에 어떤 차이를 만드는지, 큰 교사 모델의 지식이 작은 인코더에도 도움이 되는지입니다. 저자들은 150M, 380M, 1.3B 규모의 인코더를 같은 데이터 혼합과 토크나이저로 학습하며 이 변수를 비교합니다. 핵심 제안은 두 마스킹 비율의 시퀀스를 함께 학습하고, 두 비율에 별도 언어 모델링(LM) head를 두는 것입니다.
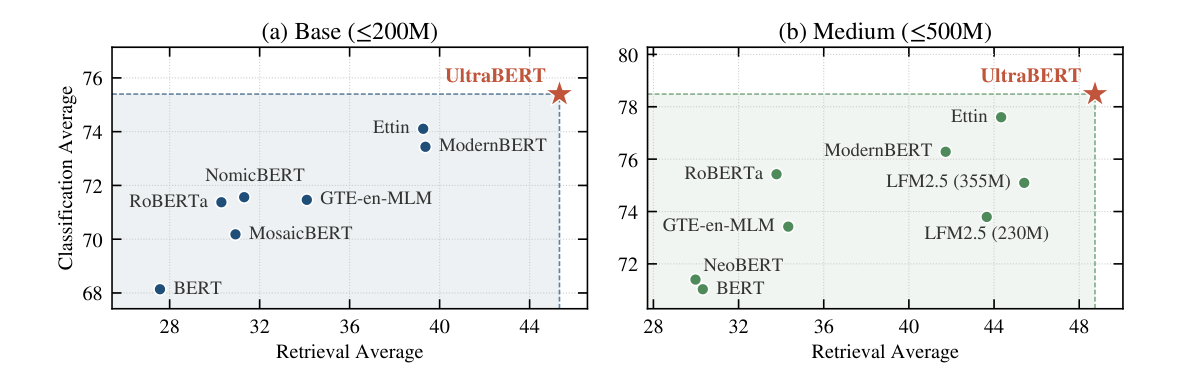
출처: Park et al. (2026), arXiv v1 Figure 1, PDF p. 2.
Figure 1은 분류 평균(GLUE, SQuAD 2.0, MultiCoNER v2, Few-NERD, RewardBench)과 검색 평균(BEIR, RAR-b Code·Math 평균, MLDR)을 나타냅니다. 이 점은 각 과제 점수를 저자가 정의한 묶음별로 평균한 값이지, 하나의 벤치마크 정확도가 아닙니다.
2. 토큰을 늘려도 하류 지표는 같은 속도로 오르지 않습니다
토큰 스케일링 실험에서는 150M과 1.3B 인코더를 마스킹 30%로 최대 8.8T 토큰까지 학습합니다. GLUE 평균, SQuAD 2.0 F1, BEIR 평균은 약 1–2T 토큰 이후 완만해지는 반면 학습·검증 손실은 계속 낮아집니다. BEIR은 첫 평가 지점인 275B 토큰 이후 큰 변화가 없었다고 보고합니다.
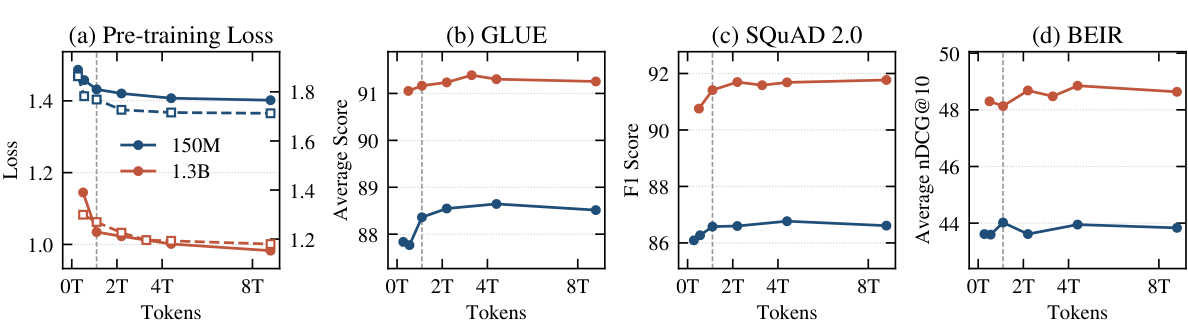
출처: Park et al. (2026), arXiv v1 Figure 2, PDF p. 3.
Figure 2는 150M·1.3B 인코더의 학습·검증 손실과 GLUE, SQuAD 2.0, BEIR 추이를 보여줍니다. 관측은 두 크기와 30% 마스킹 조건에서 얻은 결과입니다.
이 실험에서 읽을 수 있는 결과는 해당 설정에서 하류 지표의 증가폭이 작아졌다는 점입니다. 저자들은 이를 인코더 사전학습의 토큰 규모를 정할 때 고려할 관측으로 제시합니다. 뒤이은 마스킹 비율 비교에도 서로 다른 토큰 예산을 배정합니다.
3. 분류와 검색은 서로 다른 마스킹 비율을 선호합니다
저자들은 150M, 380M, 1.3B 모델에서 3%, 6%, 15%, 30%, 50%의 마스킹 비율을 비교합니다. 토큰 예산은 30%와 50%에서 1T, 15%에서 2T, 3%와 6%에서 5T입니다. GLUE와 SQuAD 2.0에서는 마스킹 비율이 낮을수록 점수가 높아지는 경향을 보이고, BEIR에서는 50% 비율이 세 크기에서 가장 높은 점수를 냅니다.
따라서 논문은 단일 마스킹 비율이 두 용도의 선호를 동시에 충족시키기 어렵다고 설명합니다. 낮은 비율은 입력 문맥을 더 많이 남겨 분류에 유리하고, 높은 비율은 검색에서 더 좋은 결과와 함께 나타납니다. 이 비교는 비율마다 토큰 예산을 달리해 포화 구간을 살피도록 설계되어 있습니다.
4. 두 비율의 시퀀스를 섞고 LM head를 분리합니다
150M 모델의 혼합 실험에서는 5%와 50% 마스킹 시퀀스를 한 배치에 4:1로 넣습니다. 이 비율은 마스킹된 토큰 수가 아니라 각 비율로 만든 시퀀스 수의 비율입니다. 두 조건이 같은 인코더를 공유하고, LM head만 비율별로 나누는 설정을 비교합니다.
| 150M 모델의 혼합 설정 | GLUE | BEIR |
|---|---|---|
| 공유 LM head | 88.9 | 44.7 |
| 분리 LM head | 89.4 | 45.1 |
Table 1에서 분리 head 설정은 공유 head 설정보다 GLUE에서 0.5, BEIR에서 0.4 높습니다. 논문은 서로 다른 마스킹 조건에서 LM head의 기하가 달라지는 관찰을 제시하고, head 공유가 gradient 수준의 간섭을 만들 수 있다고 추측합니다. 저자들은 이를 직접 측정한 결과가 아니라 conjecture로 표현합니다.
5. 증류 결과는 마스킹 비율에 따라 다릅니다
Table 2는 1.3B 교사에서 380M 모델로 500B 토큰 동안 logit 기반 증류를 수행한 결과를 보고합니다. 15% 마스킹에서는 GLUE가 90.2에서 90.8로 오르고 BEIR은 46.0으로 유지됩니다. 50%에서는 GLUE가 89.6으로 변하지 않고 BEIR이 47.2에서 46.5로 낮아집니다. 이 두 조건을 바탕으로 최종 레시피는 낮은 비율의 학습에만 교사 KL 손실을 적용합니다.
저자들은 마스킹 비율과 표현이 활용하는 차원의 정도인 effective rank 사이에서 r=0.91의 상관을 보고합니다. 그러나 이 상관만으로 높은 effective rank가 검색 향상을 일으키는지는 알 수 없다고 설명합니다. 6% 마스킹 모델에 KoLeo 정규화를 더한 실험에서는 effective rank와 BEIR 점수가 높아지지만, BEIR은 50% 단일 비율 모델보다 낮고 GLUE는 떨어집니다.
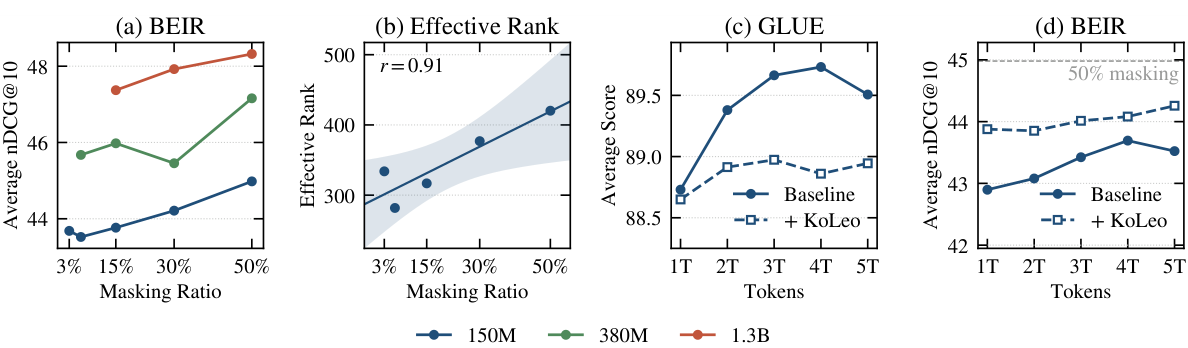
출처: Park et al. (2026), arXiv v1 Figure 6, PDF p. 6.
Figure 6은 비율별 BEIR, 150M 표현의 effective rank, 6% 마스킹 모델에 KoLeo를 적용한 GLUE·BEIR 결과를 함께 보여줍니다.
6. UltraBERT는 1.3B 교사에서 두 크기로 이어집니다
최종 모델은 1.3B 인코더를 폭 기준으로 380M, 이어 150M으로 가지치기한 뒤 학습합니다. 두 학생 크기는 모두 축소 전의 같은 1.3B 원 교사에서 지식을 증류받습니다. 한 배치에는 5%와 50% 마스킹 시퀀스를 4:1로 섞고 각각 별도 LM head를 둡니다. 5% head에는 교사의 예측 분포와 학생의 차이를 줄이는 KL 손실을 적용하며, 50% head는 표준 MLM 손실로 학습합니다.
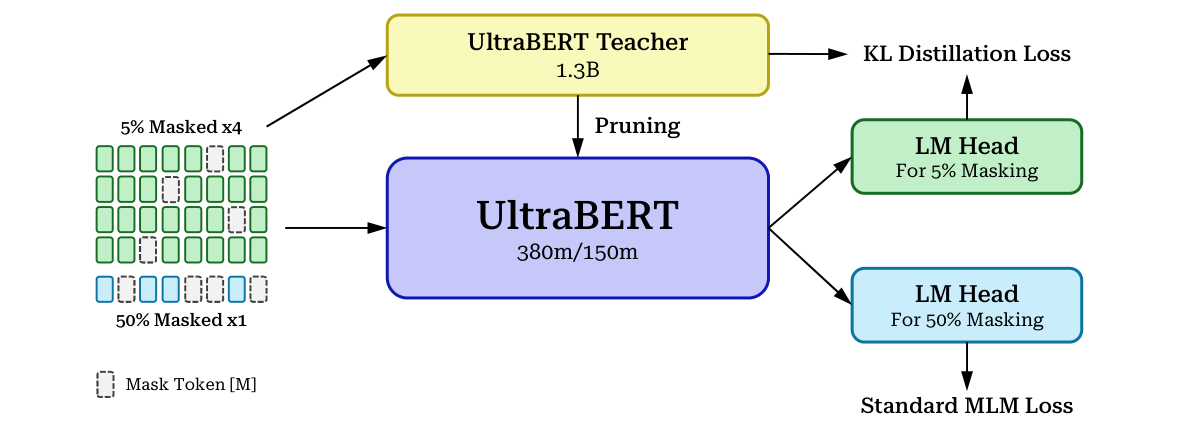
출처: Park et al. (2026), arXiv v1 Figure 10, PDF p. 8.
각 학생의 사전학습 예산은 2T 토큰이며, 마지막 100B 토큰 구간에서 문맥 길이를 32K로 늘립니다. 이 2T는 학생 학습 예산을 가리키며, 교사 사전학습과 교사 추론을 포함한 전체 파이프라인 비용을 뜻하지 않습니다. 모델은 24개 층을 유지하며, 폭을 줄여 두 학생 크기를 구성합니다.
7. Table 3은 두 크기의 과제별 결과를 함께 보고합니다
| 모델 | GLUE | SQuAD 2.0 | MultiCoNER v2 | Few-NERD | RewardBench | BEIR | RAR-b Code | RAR-b Math | MLDR | LongEmbed |
|---|---|---|---|---|---|---|---|---|---|---|
| UltraBERT 150M (152M) | 89.5 | 89.2 | 57.9 | 67.4 | 73.0 | 45.2 | 39.1 | 55.4 | 43.5 | 72.0 |
| UltraBERT 380M | 91.0 | 90.9 | 63.5 | 68.3 | 78.8 | 47.7 | 47.0 | 61.7 | 44.1 | 74.9 |
저자들은 Table 3의 두 크기에서 20개 결과 열 중 18개가 각 크기별 최고라고 보고합니다. 예외는 base 크기의 MultiCoNER v2(57.9)와 medium 크기의 MLDR(44.1)입니다. 표제 수치인 GLUE 91.0과 BEIR 47.7은 모두 380M 모델의 결과입니다. Table 3의 매개변수 수는 LM head를 제외합니다.
평가 절차도 결과를 읽을 때 함께 봐야 합니다. GLUE와 SQuAD 2.0은 dev 세트에서 체크포인트와 설정을 선택하고 같은 dev 점수를 보고합니다. 검색에서는 MS MARCO를 한 epoch 학습하고 BEIR 평균이 가장 높은 체크포인트와 학습률을 고릅니다. RAR-b에는 그 BEIR 선택 모델을 사용하며, MLDR은 같은 학습률로 이어서 학습합니다. UltraBERT는 32K 문맥을 지원하고 비교 모델의 표기 문맥은 512–8,192 토큰이며, 입력은 각 모델의 문맥 한도에 맞춰 잘립니다.
이 결과에서 UltraBERT의 핵심은 분류와 검색에 서로 다른 마스킹 비율을 적용하고, 이를 하나의 인코더와 분리된 LM head 안에서 함께 학습한 점입니다. 토큰 스케일링, 비율별 비교, 증류 실험, 최종 벤치마크를 통해 저자들은 사전학습 레시피의 선택이 인코더의 하류 성능과 연결되는 방식을 제시합니다.
References
Park, J., Lee, T., & Kang, J. (2026). UltraBERT: Beyond the limit of BERT pre-training (Version 1, arXiv:2610.15028v1) [Preprint]. arXiv. https://arxiv.org/abs/2610.15028v1