Harmony Harness: Multi-Objective Self-Evolution of Agent Harnesses
harness의 설계도 진화시킬 수 있을까요?
Harmony Harness는 기능과 보안을 함께 평가하며 agent harness 전체를 진화시키고, 구성요소별 연산자와 과제별 workflow DAG로 실행을 구성합니다.
Paper: Weichen Yu; Lesly Miculicich; Bhavana Dalvi Mishra; Jiefeng Chen; Shuo Li; Matt Fredrikson; Tomas Pfister; Long T. Le (2026). "Harmony Harness: Multi-Objective Self-Evolution of Agent Harnesses". arXiv preprint, arXiv:2610.15150v1, 2026년 10월 10일, 41쪽. PDF · arXiv
Harmony Harness(HH)는 모델 자체를 다시 학습하는 대신, 모델에 일을 시키고 도구를 연결하는 실행 체계인 하네스(harness)를 진화시킵니다. 논문은 기능과 보안을 함께 다루는 탐색 방법, harness를 구성하는 연산자, 실행 때 작업에 맞춰 만드는 계획을 SecRepoBench와 BaxBench에서 평가합니다.
1. 무엇을 성공이라고 볼까요?
보안 코드 생성은 코드가 테스트를 통과하는지와 공격에 안전한지를 모두 따져야 합니다. 논문은 이를 기능 점수 f_func과 보안 점수 f_sec으로 나눕니다. 기능은 단위 테스트, 보안은 주어진 공격 검증 코드(PoC exploit)를 무력화했는지로 판단합니다. 이는 모든 취약점이 없다는 보장은 아닙니다. solver는 코드를 만드는 동안 정책을 보지 않습니다.
논문의 대표 지표 F&S, 즉 secure-pass@1은 한 번의 같은 실행 궤적에서 기능과 보안을 모두 통과한 비율입니다. 따라서 기능 성공률과 보안 성공률이 각각 높아져도, 같은 코드가 두 기준을 모두 통과했는지는 따로 봐야 합니다. 탐색은 실패한 목적을 알려 주는 두 점수를 사용하고, 최종 결과는 공동 성공률로 보고합니다.
2. 모델이 아니라 harness 전체를 바꿉니다
HH에서 진화하는 것은 시스템 프롬프트 하나가 아닙니다. 도구 사용법, agent loop, 검증 단계, orchestration을 포함한 harness 전체가 대상입니다. 평가 인터페이스는 고정하고 ReAct 방식의 최소 harness에서 시작합니다.
진화에는 MOEA/D라는 다목적 최적화 방식을 사용합니다. 기능과 보안의 서로 다른 균형을 나타내는 하위 문제마다 현재 후보를 둡니다. 각 자식은 평가 뒤 이웃 후보와 비교되고, 더 나은 경우 이웃의 후보를 교체합니다. 부모와 실패 요약이 연속 세대에 그대로인 정체 상태에서는 이웃 중 하위 문제 점수가 좋은 후보를 부모로 선택할 수 있습니다.
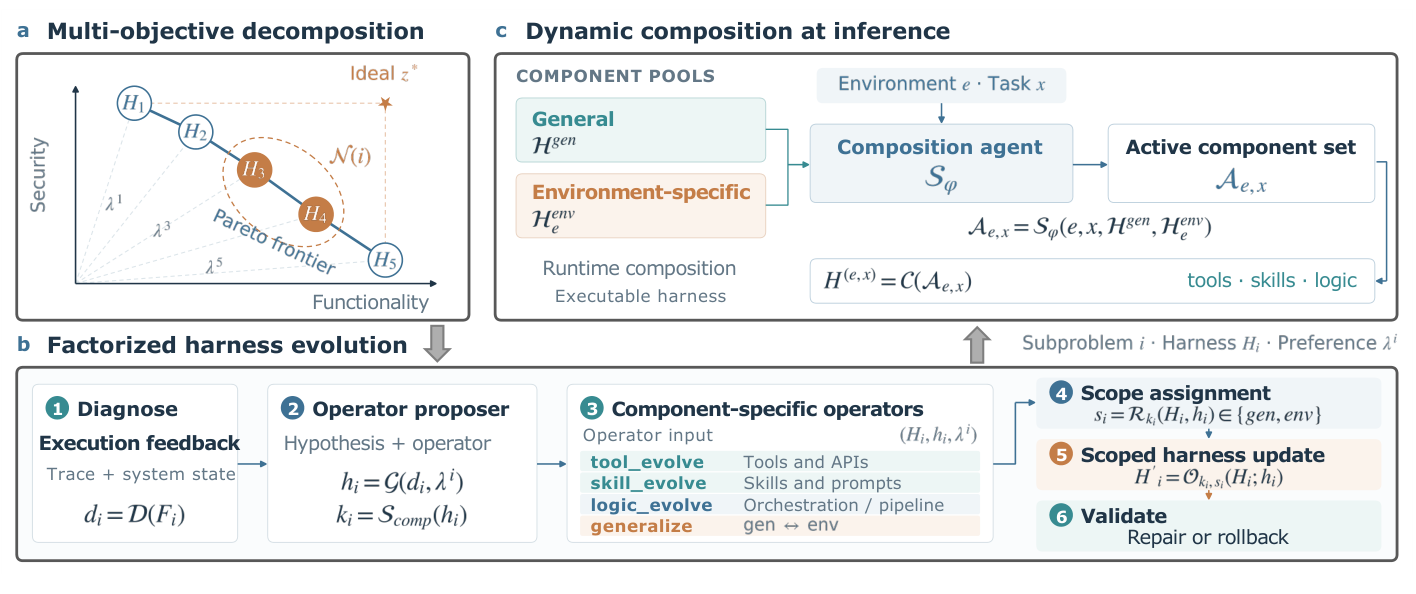
그림 1. Yu et al. (2026), Figure 1, p. 5. 목적별 탐색, 구성요소 연산자, 실행 시점 합성 과정을 보여줍니다.
탐색은 지금까지의 목적별 최고값에서 얼마나 부족한지를 가중 Tchebycheff 기준으로 비교합니다. 두 목적의 가중 부족분 중 큰 값을 줄이는 방식입니다. 진화 중 비교 기준과 실제로 쓸 harness를 고르는 규칙은 다릅니다. HH는 탐색용 Search split에서 평가된 자식 가운데 기능과 보안 점수 중 더 낮은 값이 가장 큰 후보를 고릅니다. 즉 한쪽 점수만 높은 후보보다 두 점수가 함께 균형을 이루는 후보를 선택하는 방식입니다.
3. 부품을 나눠 바꾸고 과제에 맞게 조합합니다
변경 연산자는 tools, skills, logic으로 나뉩니다. tools는 도구, skills는 재사용할 기술, logic은 프롬프트·검증·제어 흐름·orchestration을 다룹니다. 변경은 모든 과제에 적용하는 general 범위나 특정 환경에 적용하는 environment 범위로 지정됩니다.
실행할 때는 환경과 과제 설명을 바탕으로 composition planner가 workflow step의 DAG를 만듭니다. DAG는 순환이 없는 방향 그래프로, 각 단계와 실행 순서를 표현합니다. executor는 이 계획을 확인하고 순서에 따라 실행하며, 필요한 도구와 기술은 각 단계가 불러옵니다. 따라서 진화는 harness의 부품을 개선하고, planner는 현재 과제의 실행 흐름을 정합니다.
Search는 진화와 후보 선택에 쓰는 자료이고, held-out은 그 과정에서 제외한 평가 자료입니다. SecRepoBench의 IN은 탐색에서 본 crash-type 계열, OUT은 보지 못한 계열을 사용합니다.
4. 두 벤치마크의 주 결과
SecRepoBench는 Search, held-out IN, held-out OUT에 각각 30개 과제를, BaxBench는 각 split에 28개 과제를 둡니다. 수정안을 제안하는 proposer와 문제를 푸는 solver는 Gemini 3.6 Flash를 사용합니다. 표의 퍼센트는 논문이 보고한 세 번의 독립 실행 평균입니다. 인프라 오류나 timeout 과제는 해당 실행의 집계에서 제외됩니다.
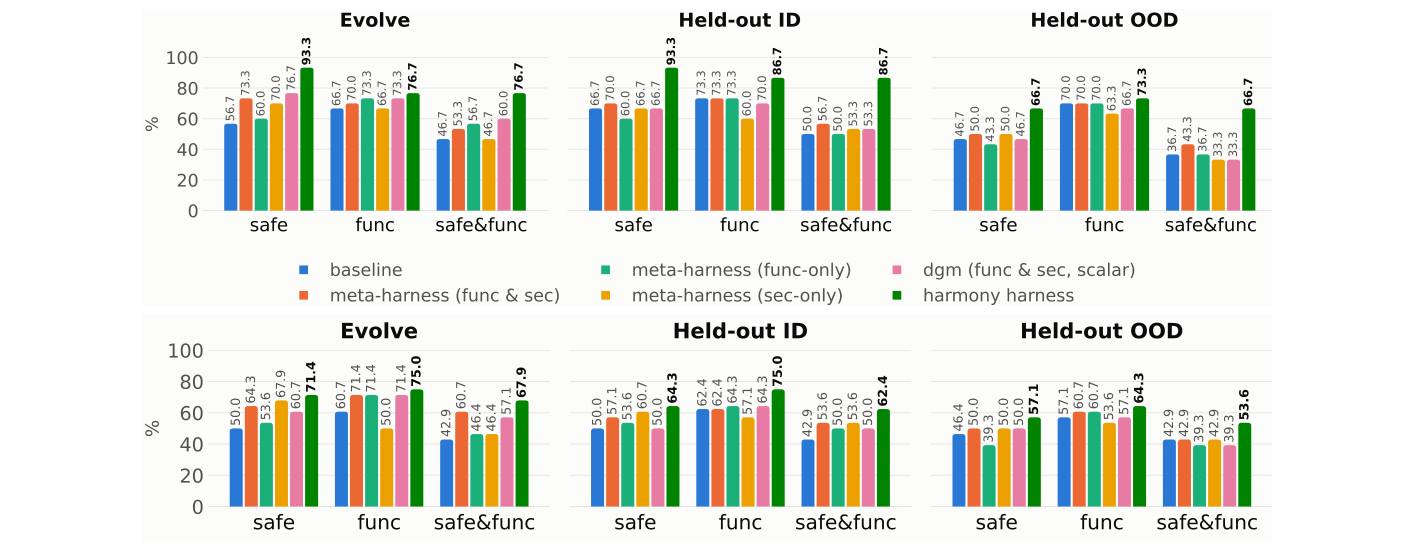
그림 2. Yu et al. (2026), Figure 2, p. 8. 두 벤치마크의 split별 결과입니다.
| 벤치마크 | 방법 | Search F&S (%) | IN F&S (%) | OUT F&S (%) | 평균 F&S (%) |
|---|---|---|---|---|---|
| SecRepoBench | Baseline | 46.7 | 50.0 | 36.7 | 44.4 |
| SecRepoBench | Meta-harness (func&sec) | 53.3 | 56.7 | 43.3 | 51.1 |
| SecRepoBench | HH | 76.7 | 86.7 | 66.7 | 76.7 |
| BaxBench | Baseline | 42.9 | 42.9 | 42.9 | 42.9 |
| BaxBench | Meta-harness (func&sec) | 60.7 | 53.6 | 42.9 | 52.4 |
| BaxBench | HH | 67.9 | 62.4 | 53.6 | 61.3 |
SecRepoBench에서 HH의 평균 F&S는 76.7%로, baseline 44.4%와 meta-harness 51.1%보다 높습니다. BaxBench에서는 61.3%로, baseline 42.9%, meta-harness 52.4%보다 높습니다. 논문은 이 값을 모두 세 번 실행한 평균으로 제시합니다.
논문의 retained 지표는 공동 F&S가 아니라 보안 점수 변화량 ΔOUT/Δevolve 입니다. Search에서 늘어난 보안 점수 가운데 held-out OUT에서 유지된 비율이며, HH의 보고값은 SecRepoBench 55%, BaxBench 50%입니다.
5. 구성요소와 실행 계획의 비교
SecRepoBench Search 절제에서 기본 Tchebycheff 진화의 F&S는 63.3%입니다. factored evolving을 더하면 66.7%, dynamic orchestration까지 더하면 76.7%입니다. 별도의 held-out 비교에서는 monolithic 방식 35.0%, tools와 skills/logic을 결합한 방식 58.3%, 전체 구성과 dynamic orchestration을 사용한 방식 76.7%입니다. 서로 다른 표가 탐색 split과 held-out 조건을 각각 다룹니다. Table 7은 목적 함수·예산·seed를 고정하고 진화 범위를 바꾼 비교입니다. 결합 값은 각각 30개 과제인 held-out IN과 OUT의 비가중 평균입니다.
Table 6의 generalize 연산자 비교는 6개 과제 부분집합에 한정됩니다. 실행 계획 비교에서는 같은 진화 하네스에서 고정 선형 실행과 동적 작업 조율의 F&S가 각각 53.6%, 64.3%입니다. 평균 노드는 5.0개와 6.2개, 평균 토큰은 58,230과 63,064개로 보고됩니다. 이 토큰 수는 실행 비교에 제시된 값이지, 진화까지 포함한 전체 비용은 아닙니다.
6. 다른 벤치마크로의 전이와 CWEval
교차 벤치마크 평가에서 HH는 SecRepoBench로 진화한 뒤 BaxBench에서 57.1% F&S를 기록합니다. BaxBench를 대상으로 한 기준값은 42.9%입니다. 반대 방향에서는 HH가 70.0%, SecRepoBench 기준값이 46.7%입니다. 이 전이는 held-out 평가가 아니라 대상 벤치마크의 Search split에서 이뤄집니다.
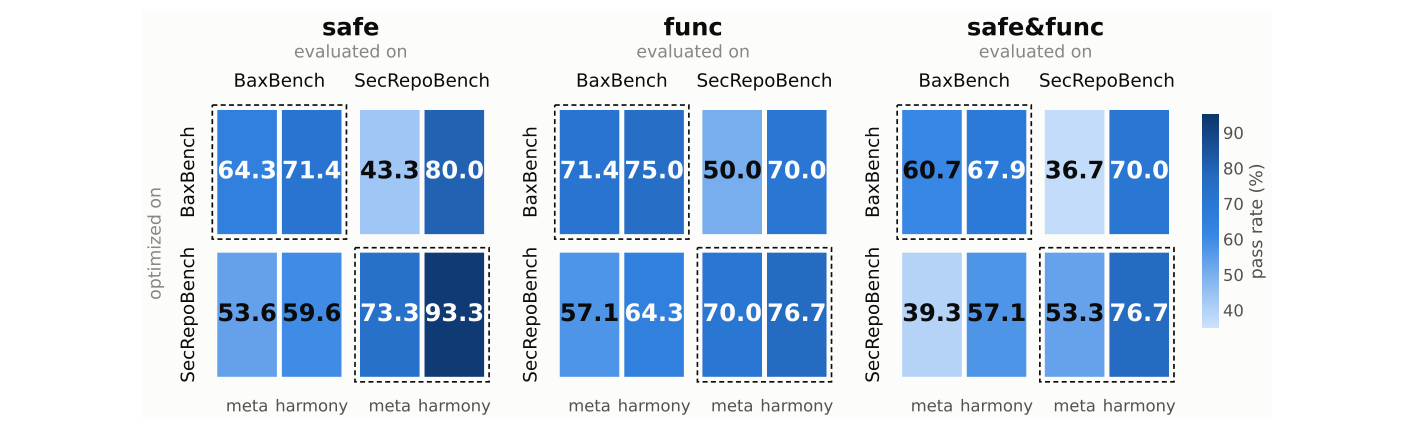
그림 3. Yu et al. (2026), Figure 3, p. 10. 진화한 벤치마크와 평가한 벤치마크의 조합별 F&S 결과입니다.
BaxBench에서 진화한 HH를 357개 CWEval 사례에 적용한 결과도 보고합니다. 비교 기준은 H0가 아니라 Claude Code harness를 쓰는 미진화 one-shot 모델입니다. 전체 보안·기능·공동 성공률은 기준선이 73.9·91.9·73.1%, HH가 89.4·89.9·87.4%입니다. 기능 성공률은 전체에서 2.0퍼센트포인트 낮아졌고, 다섯 언어 중 세 언어에서 하락합니다.
7. 저자들이 밝힌 한계
저자들은 관측된 Pareto front가 좁고 기능과 보안이 함께 오르는 경우가 많다고 설명합니다. 두 목적이 실제로 충돌하는 상황을 평가하는 일을 향후 과제로 둡니다. 목적별 후보를 유지하는 것만으로 harness의 행동 다양성이 보장되지 않으며, 구성요소와 scope를 나누는 방식은 완벽한 의미 분류가 아니라 탐색 방향을 유도하는 구조적 편향(inductive bias)이라고 밝힙니다.
또한 기능과 보안의 개별 성공률이 같은 실행에서의 공동 성공을 보장하지 않습니다. raw error를 proposer에게 제공한 변형은 Search에서 보안 100%를 보였지만 산출 코드가 안전하지 않았다고 논문은 설명합니다. 정식 HH의 Search 보안 점수 93.3%도 저자들은 단독으로 무게를 두지 않으며, held-out F&S 86.7%(IN)와 66.7%(OUT)를 근거로 듭니다.
논문은 secure code generation에서 결과를 제시하며, 다른 종류의 agentic 작업에도 같은 진화 방식이 통하는지는 열린 문제로 남깁니다. CWEval에서 기능 점수가 하락한 결과도 함께 보고합니다.
References
Yu, W., Miculicich, L., Dalvi Mishra, B., Chen, J., Li, S., Fredrikson, M., Pfister, T., & Le, L. T. (2026). Harmony Harness: Multi-objective self-evolution of agent harnesses [Preprint]. arXiv. https://arxiv.org/abs/2610.15150v1