UltraBERT: Beyond the Limit of BERT Pre-Training
UltraBERT는 5%·50% 마스킹 시퀀스를 4:1로 섞고 LM head를 나누며, 저자들은 1.3B 교사에서 증류한 150M·380M 모델의 분류·검색 결과를 보고합니다.
Paper: Jungwoo Park; Taewhoo Lee; Jaewoo Kang (2026). "UltraBERT: Beyond the Limit of BERT Pre-Training". arXiv preprint, arXiv:2610.15028v1, 2026년 10월 10일, 31쪽. PDF · arXiv
이 논문은 bidirectional encoder의 사전학습 레시피를 토큰 규모, masked language modeling(MLM)의 masking ratio, LM head 구성, pruning·distillation 관점에서 다룬다. 저자들은 낮은 masking ratio가 분류에, 높은 ratio가 검색에 유리하다는 결과를 바탕으로 두 설정을 하나의 모델에 결합한 UltraBERT를 제시한다.
논문의 주요 설계는 5%와 50% masking 시퀀스를 한 배치에서 4:1로 혼합하고 각 ratio에 별도 LM head를 두는 것이다. 5% 시퀀스에는 1.3B 교사의 KL 증류를 적용하며, 50% 시퀀스는 표준 MLM 손실로 학습한다. 최종 150M·380M 모델은 2T 토큰으로 학습되고 마지막 100B 토큰에서 문맥 길이를 32K로 확장한다. Table 3은 10개 지표를 두 모델 크기에서 비교하며, 표의 매개변수 수는 LM head를 제외한다.
핵심 요약
| 주제 | 논문에 보고된 내용 |
|---|---|
| 토큰 규모 | 150M·1.3B 모델을 30% masking으로 최대 8.8T 토큰까지 학습했다. 저자들은 하류 성능이 약 1–2T 이후 완만해지는 관측을 보고한다. |
| masking ratio | 150M·380M·1.3B에서 낮은 ratio는 분류에, 높은 ratio는 BEIR 검색에 유리한 경향을 보인다. ratio별 토큰 예산은 서로 다르다. |
| ratio 혼합 | 5%·50% 시퀀스를 4:1로 섞고 두 LM head를 분리한 150M 모델은 GLUE 89.4, BEIR 45.1을 기록했다. |
| 증류 | 1.3B에서 pruning한 380M 모델의 증류 비교에서 15% masking은 GLUE가 90.2에서 90.8로, 50% masking은 BEIR이 47.2에서 46.5로 바뀌었다. |
| UltraBERT | 150M·380M, 2T 토큰, 네이티브 32K 문맥. KL 증류는 혼합 배치 중 5% 시퀀스에만 적용한다. |
| Table 3 | 저자 보고 수치상 두 크기 각 10개 지표 가운데 9개씩 최고다. base 예외는 MultiCoNER v2, medium 예외는 MLDR다. 91.0 GLUE와 47.7 BEIR은 모두 380M 결과다. |
목차
- 문제 설정과 모델 구성
- 토큰 규모와 사전학습 데이터
- Masking ratio, 분류·검색 및 RTD
- Ratio 혼합과 LM head 분리
- Pruning·증류와 최종 학습 레시피
- 평가 프로토콜과 지표
- 주요 결과
- 저자들이 밝힌 해석의 범위와 결론
1. 문제 설정과 모델 구성
저자들은 최근 bidirectional encoder가 RoPE, SwiGLU, 지역·전역 attention 등 구조를 현대화했지만, MLM의 masking ratio와 학습 레시피는 제한된 토큰 예산에서 발전한 관행을 잇는다고 설명한다. 논문은 분류와 검색을 함께 수행하는 encoder를 목표로 사전학습 선택을 다시 살핀다.
모든 모델은 24층이며, 매 세 번째 층에 전역 attention을 두고 나머지는 지역 attention을 사용한다. RoPE base는 지역 attention에서 10K, 전역 attention에서 640K이며, 32K 문맥 확장 단계에서 전역 RoPE base를 2.56M으로 높인다. LM head는 입력 임베딩과 tied되지 않고, 어휘 49,152개인 SmolLM2 tokenizer를 사용한다. 모델은 폭을 조정해 150M(은닉 768, SwiGLU 중간 크기 1,024), 380M(1,024, 3,072), 1.3B(2,048, 5,632)로 구성한다.
기본 사전학습은 AdamW, 배치 4M 토큰, 10B 토큰 warm-up을 사용한다. 학습률은 warmup-stable-decay 일정으로 마지막 10% 구간에서 감쇠한다. 레시피 탐색 실험의 peak learning rate는 3e-4, distillation과 최종 UltraBERT 학습은 1e-4다. 각 모델은 256칩 TPU pod slice에서 학습했다고 보고한다(Park et al., 2026, Appendix A.1).
2. 토큰 규모와 사전학습 데이터
저자들은 150M·1.3B encoder를 30% masking으로 최대 8.8T 토큰 학습하고 중간 checkpoint의 GLUE, SQuAD 2.0, BEIR 결과를 비교한다. Figure 2에서 학습 손실과 WikiText-103 검증 손실은 계속 감소하는 반면, 하류 성능은 대체로 1–2T 토큰 이후 완만해진다. BEIR은 최초 평가점인 275B 토큰 이후 큰 변화가 없었다고 보고한다. 이 결과는 논문에서 실험한 두 크기와 30% masking 조건의 관측이다.
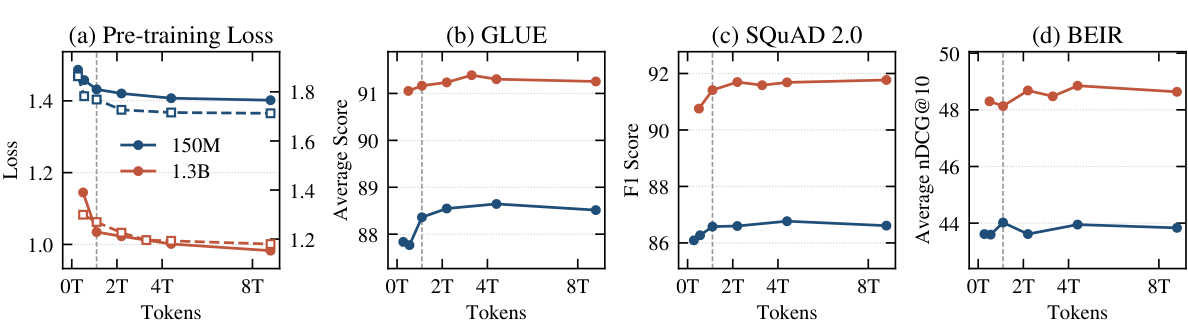
Figure 2. 150M·1.3B encoder의 사전학습 손실과 downstream 성능. (a) 실선은 학습 손실, 점선은 WikiText-103 검증 손실이며, (b) GLUE 평균, (c) SQuAD 2.0 F1, (d) BEIR 평균 nDCG@10을 나타낸다. Park et al. (2026), Figure 2, p. 3.
Figure 3은 1.3B encoder와 SmolLM2 1.7B decoder를 ARC, BoolQ, CommonsenseQA, MMLU, OpenBookQA, SIQA의 여섯 MCQA 벤치마크에서 비교한다. Base 모델은 5-shot, instruction-tuned 모델은 zero-shot으로 평가하며, 저자들은 해당 실험에서 encoder의 instruction-tuned 점수는 완만해지고 decoder는 계속 향상했다고 보고한다.
Table 4의 2T-token 사전학습 혼합은 웹 66.9%, 코드 14.0%, 학술 자료 7.1%, 수학 5.8%, 참고 자료 3.7%, 지시 데이터 2.5%로 구성된다. 데이터셋별 학습 토큰은 DCLM 881.7B, FineWeb-Edu 455.5B, Stack-Edu 280.5B, peS2o 141.6B, MegaMath 58.4B, Cosmopedia v2 65.6B, FLAN 44.4B 등이다. 전체 고유 토큰 수는 1,227.8B이고, 2T 학습 예산에 대한 혼합 전체의 평균 epoch 수는 1.63으로 표에 기재되어 있다. 저자들은 여러 단계에 걸쳐 혼합 비율을 바꾸는 예비 실험에서 fine-tuning 이후 성능 차이가 작았다고 보고하고, 혼합이 zero-/few-shot 출력 분포에 영향을 줄 수 있다는 해석을 제시한다(Appendix A.3).
3. Masking ratio, 분류·검색 및 RTD
Masking ratio 실험은 150M·380M·1.3B에서 수행한다. 낮은 ratio의 수렴에 더 많은 토큰을 배정해 50%·30%는 1T, 15%는 2T, 6%·3%는 5T 토큰을 사용한다. Figure 4에서 GLUE와 SQuAD 2.0 점수는 ratio가 높아질수록 낮아지는 경향을 보인다. Figure 6a의 BEIR 평균 nDCG@10은 50% masking에서 세 크기 모두 가장 높다. 따라서 결과의 조건에는 ratio뿐 아니라 ratio별 토큰 예산도 포함된다.
150M 결과는 아래와 같다. 낮은 ratio가 분류에서, 높은 ratio가 검색에서 높은 점수를 보이는 패턴을 수치로 제시한다.
| Masking ratio | GLUE | BEIR 평균 nDCG@10 |
|---|---|---|
| 6% | 89.5 | 43.5 |
| 15% | 88.9 | 43.8 |
| 30% | 88.3 | 44.2 |
| 50% | 87.5 | 45.0 |
저자들은 MLM과 replaced token detection(RTD)도 150M 모델에서 비교한다. RTD 생성기는 판별기의 절반 깊이이며, 생성기가 실제로 교체하는 비율이 변하는 점을 고려해 평균 replacement ratio를 MLM masking ratio에 맞춘다. Figure 5의 분류 지표는 CoLA를 제외한 GLUE와 SQuAD 2.0 F1 평균이다. 저자들은 RTD와 MLM 곡선을 보간해 차이를 계산하고, RTD의 이점이 약 15%에서 가장 크고 낮은·높은 양 끝에서 작아지는 모양을 보고한다. contextual corruption의 차이가 이 패턴을 설명할 수 있다는 것은 저자들의 가설이다.
Appendix C의 추가 비교에서 50% MLM으로 사전학습한 150M 모델을 RTD로 100B 토큰 더 학습했을 때, CoLA는 61.6에서 71.5로, CoLA를 제외한 GLUE 평균은 91.2에서 91.7로 바뀌었다. 저자들은 CoLA의 판단과 RTD의 token plausibility 판단이 가깝다고 설명하고 RTD 비교에서 CoLA를 제외한다.
4. Ratio 혼합과 LM head 분리
저자들은 6%와 50% masking으로 학습한 150M 모델의 입력 임베딩과 LM head를 시각화한다. Figure 7은 vocabulary entry별 첫 세 주성분을, Figure 8은 leading singular value로 정규화한 singular value 분포를 보여준다. 논문은 두 masking 조건에서 입력 임베딩은 비슷하지만 LM head의 형상과 특이값 분포는 다르다고 설명한다. 공유 head를 통한 gradient 흐름이 두 masking regime 사이 간섭을 만들 수 있다는 설명은 저자들의 conjecture다.
여러 mixing 전략을 비교한 Table 1은 다음과 같다. {5%, 50%}는 두 ratio의 시퀀스를 한 배치에서 사용하며, + Decoupling은 ratio마다 LM head를 따로 둔 설정이다. 5% 시퀀스가 50%보다 수렴이 느린 점을 고려해 낮은 ratio 시퀀스를 네 배 포함한다.
| 전략 | GLUE | BEIR 평균 nDCG@10 |
|---|---|---|
| 단일 6% | 89.5 | 43.5 |
| 단일 15% | 88.9 | 43.8 |
| 단일 30% | 88.3 | 44.2 |
| 단일 50% | 87.5 | 45.0 |
| 50% → 6% | 88.8 | 43.9 |
| 50% → 15% | 88.6 | 44.1 |
| Uniform(5%, 50%) | 88.0 | 44.2 |
| {5%, 50%}, 공유 head | 88.9 | 44.7 |
| {5%, 50%}, 분리 head | 89.4 | 45.1 |
저자들은 분리 head 결과가 단일 6% 모델의 GLUE 결과와 단일 50% 모델의 BEIR 결과에 근접한다고 설명한다. Figure 9는 단일 30%, Uniform 혼합의 공유 head, 5%와 50%의 분리 head에서 LM head 행렬의 기하를 비교한다.
Figure 6의 나머지 패널은 150M encoder의 representation effective rank와 6% masking 모델의 KoLeo regularizer 적용 전후 GLUE·BEIR 점수를 다룬다. 논문은 ratio가 높을 때 effective rank도 대체로 높고, KoLeo가 6% 모델의 BEIR을 높이지만 50% masking보다 낮으며 GLUE에는 불리했다고 보고한다. 저자들은 높은 effective rank와 검색 향상 사이의 인과관계를 구분할 수 없다고 명시한다. Appendix D는 KoLeo, 표현 분포의 entropy, 2차 모멘트의 isotropy, 특이값 분포, effective rank를 연결하는 이론적 논의를 제시한다.
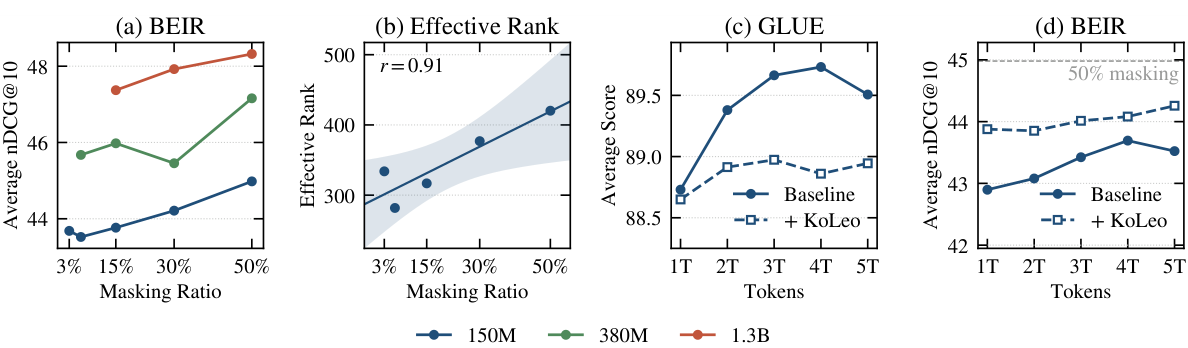
Figure 6. (a) 세 크기 모델의 ratio별 BEIR 평균 nDCG@10, (b) 150M 모델의 effective rank, (c)(d) 6% masking 모델의 KoLeo 적용 전후 GLUE 평균과 BEIR 평균 nDCG@10. Park et al. (2026), Figure 6, p. 6.
5. Pruning·증류와 최종 학습 레시피
저자들은 1.3B encoder를 pruning해 380M으로 줄이고, 1.3B 부모 모델에서 500B 토큰 동안 logit 기반 증류를 수행한다. 아래 결과는 같은 masking ratio로 처음부터 학습한 380M 모델과의 비교다.
| Masking ratio | 모델 | GLUE | BEIR 평균 nDCG@10 |
|---|---|---|---|
| 15% | 1.3B | 91.8 | 47.4 |
| 15% | 380M | 90.2 | 46.0 |
| 15% | 380M, distilled | 90.8 | 46.0 |
| 50% | 1.3B | 90.7 | 48.3 |
| 50% | 380M | 89.6 | 47.2 |
| 50% | 380M, distilled | 89.6 | 46.5 |
저자들은 15% masking에서 증류 후 GLUE가 90.2에서 90.8로 상승하고 BEIR은 46.0으로 유지된다고 보고한다. 50% masking에서는 GLUE가 89.6으로 같고 BEIR은 47.2에서 46.5로 낮아졌다. 높은 ratio에서 교사 신호가 덜 유용할 수 있다는 설명은 저자들이 제시한 가능성이다. Attention-score 및 Gram-matrix 기반 증류는 긴 입력에서 O(L²) 메모리·연산 비용이 들고 FlashAttention과 호환되지 않는다는 이유로 다루지 않는다.
최종 UltraBERT는 1.3B 교사에서 380M으로 pruning·증류한 다음, 그 380M 모델을 다시 150M으로 pruning한다. 두 학생 모두 1.3B 교사에서 증류하며 24층은 유지하고 폭을 줄인다. 각 배치에는 5%·50% masking 시퀀스를 4:1로 넣고, 각 ratio에 분리된 LM head를 사용한다. KL divergence는 5% 시퀀스의 teacher/student logits에만 적용하고 50% 시퀀스에는 표준 MLM 손실을 사용한다.
최종 두 모델은 각각 2T 토큰 학습이며, 마지막 100B 토큰에서 문맥 길이를 32K로 늘린다. Figure 10은 pruning 순서, 두 masking ratio, 두 LM head 및 loss 구성을 요약한다. Appendix A는 모델 구조와 학습·가지치기 설정, TPU 실행 구성을 기술한다.
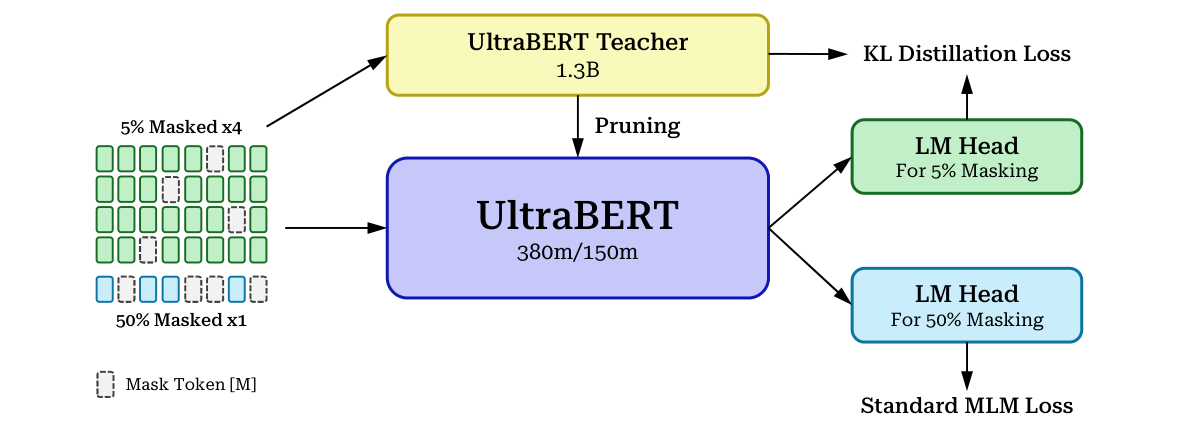
Figure 10. 1.3B 교사에서 380M·150M 학생을 만들고, 각 배치에서 5%와 50% masking 시퀀스를 4:1로 혼합한다. 두 ratio는 별도 LM head를 사용하며, 5% head는 1.3B 교사의 KL distillation, 50% head는 표준 MLM loss로 학습한다. Park et al. (2026), Figure 10, p. 8.
6. 평가 프로토콜과 지표
분류 평가에는 GLUE, SQuAD 2.0, MultiCoNER v2, Few-NERD, RewardBench가 포함된다. 모든 task에서 학습률 grid를 사용하며, 분류 task의 학습률 후보는 5e-6, 8e-6, 1e-5, 3e-5, 5e-5, 8e-5다.
- GLUE는 WNLI를 제외한 8개 task에서 dev 점수를 보고한다. CoLA는 Matthews correlation, STS-B는 Pearson correlation, MNLI는 matched accuracy, 나머지는 accuracy다. 입력 최대 길이는 128 token이다. RTE·MRPC·STS-B는 같은 모델의 최선 MNLI checkpoint에서 초기화한다. MNLI·QQP·QNLI·SST-2는 batch 64, 1·2·3 epoch를 사용한다. CoLA·STS-B·MRPC·RTE는 batch 16·32·64, 2·5·10 epoch를 grid search하고 seed별 최선 dev 점수의 중앙값을 보고한다(4 seed).
- SQuAD 2.0은 최대 384 token, document stride 128에서 batch 16·32·64와 1·2·3 epoch를 탐색하고 dev F1을 보고한다.
- MultiCoNER v2는 영어 subset이며 train/dev/test가 16,778/871/249,980 문장이다. dev 선택에는 3 seed 평균을 쓰고 test macro-F1을 보고한다. Few-NERD 공식 supervised split은 131,767/18,824/37,648이며 test micro-F1을 사용한다.
- RewardBench는 단일 턴 선호쌍 135,981개로 Bradley–Terry loss를 학습하고, 6,800쌍을 dev로 둔다. 입력은 최대 1,024 token이며, Chat·Chat Hard·Safety·Reasoning 네 섹션의 공식 가중 평균을 보고한다.
검색은 mean pooling 기반 single-vector dense retriever와 cached multiple-negatives ranking loss를 사용한다. MS MARCO에서 1.25M hard-negative triplet으로 1 epoch 학습하고 최대 입력은 256 token이다. 열 개 학습률(1e-5부터 1e-3까지)을 탐색한 뒤 BEIR 점수가 가장 높은 checkpoint를 선택한다. BEIR은 15개 데이터셋 평균 nDCG@10이며 MS MARCO dev와 CQADupstack 12개 forum 평균을 포함한다. 같은 checkpoint를 RAR-b의 code·math subset에도 적용하며, 각각 301K·389K 후보에서 정답을 검색한다.
MLDR 단계는 영어 학습 triplet 80K개를 사용하고 MS MARCO에서 선택한 학습률을 유지한다. 입력 길이는 모델 문맥에 맞추되 16K로 제한한다. LongEmbed 6개 task 평가는 최대 32K token까지 사용한다. NarrativeQA·QMSum·SummScreenFD·2WikiMultihopQA는 nDCG@10, Passkey·Needle은 길이별 recall@1을 측정한다. Figure 11의 Passkey는 256–32,768 token 길이별 50개 query를 사용한다.
7. 주요 결과
Table 3의 모델 매개변수 수는 LM head를 제외한다. 열은 GLUE, SQuAD 2.0, MultiCoNER v2, Few-NERD, RewardBench, BEIR, RAR-b Code, RAR-b Math, MLDR, LongEmbed 순이다.
| 크기 | 모델 | Params | GLUE | SQuAD | MultiCoNER | Few-NERD | RewardBench | BEIR | RAR-b Code | RAR-b Math | MLDR | LongEmbed |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Base | BERT | 110M | 84.7 | 76.3 | 53.8 | 66.6 | 59.4 | 36.7 | 6.6 | 27.5 | 29.0 | 29.3 |
| Base | RoBERTa | 125M | 86.4 | 83.7 | 56.5 | 67.1 | 63.2 | 39.6 | 11.7 | 33.4 | 28.7 | 33.8 |
| Base | MosaicBERT | 137M | 85.4 | 79.4 | 57.8 | 65.7 | 62.5 | 41.4 | 12.7 | 30.9 | 29.6 | 40.5 |
| Base | NomicBERT | 137M | 84.0 | 82.7 | 60.1 | 66.9 | 64.1 | 42.0 | 13.8 | 30.2 | 29.9 | 45.0 |
| Base | GTE-en-MLM | 137M | 85.6 | 82.7 | 59.2 | 66.4 | 63.4 | 42.4 | 12.0 | 33.6 | 37.1 | 58.5 |
| Base | ModernBERT | 149M | 88.4 | 86.7 | 57.4 | 66.7 | 68.0 | 42.6 | 29.6 | 46.1 | 37.7 | 63.2 |
| Base | Ettin Encoder | 149M | 88.9 | 87.4 | 57.4 | 66.5 | 70.3 | 42.4 | 31.8 | 47.1 | 35.9 | 60.1 |
| Base | UltraBERT | 152M | 89.5 | 89.2 | 57.9 | 67.4 | 73.0 | 45.2 | 39.1 | 55.4 | 43.5 | 72.0 |
| Medium | BERT | 334M | 85.2 | 81.8 | 57.7 | 67.8 | 62.6 | 38.6 | 12.2 | 33.0 | 29.8 | 30.0 |
| Medium | RoBERTa | 355M | 88.9 | 89.4 | 62.3 | 68.1 | 68.5 | 42.8 | 20.3 | 37.8 | 29.5 | 32.2 |
| Medium | GTE-en-MLM | 434M | 87.6 | 87.2 | 63.0 | 67.1 | 62.2 | 39.4 | 13.5 | 32.0 | 40.8 | 57.0 |
| Medium | NeoBERT | 222M | 89.0 | 86.6 | 57.4 | 66.4 | 57.6 | 42.9 | 17.3 | 33.4 | 21.7 | 32.4 |
| Medium | LFM2.5-Encoder | 230M | 88.2 | 86.1 | 59.6 | 67.6 | 67.5 | 46.7 | 30.9 | 50.2 | 43.7 | 70.0 |
| Medium | LFM2.5-Encoder | 355M | 89.2 | 87.2 | 62.7 | 67.9 | 68.5 | 47.3 | 38.6 | 50.2 | 44.5 | 71.7 |
| Medium | ModernBERT | 395M | 90.4 | 89.8 | 60.9 | 67.6 | 72.8 | 45.2 | 34.0 | 46.1 | 39.9 | 63.5 |
| Medium | Ettin Encoder | 395M | 90.8 | 90.4 | 62.3 | 67.8 | 76.7 | 45.9 | 38.5 | 54.0 | 40.9 | 64.3 |
| Medium | UltraBERT | 380M | 91.0 | 90.9 | 63.5 | 68.3 | 78.8 | 47.7 | 47.0 | 61.7 | 44.1 | 74.9 |
Table 3. 분류·검색 벤치마크 비교. 매개변수 수에서 LM head는 제외한다. Park et al. (2026), Table 3, p. 9.
Table 3에서 UltraBERT는 각 크기의 10개 지표 중 9개에서 가장 높은 점수다. base의 예외는 MultiCoNER v2이며, medium의 예외는 MLDR다. 초록의 91.0 GLUE·47.7 BEIR은 380M 행의 점수다. Figure 1은 GLUE·SQuAD 2.0·MultiCoNER v2·Few-NERD·RewardBench의 평균을 classification average로, BEIR·RAR-b Code/Math 평균·MLDR의 평균을 retrieval average로 묶어 두 크기 그룹의 위치를 그린다. Figure caption은 이 평균의 입력 점수를 Table 3에서 가져온다고 밝힌다.
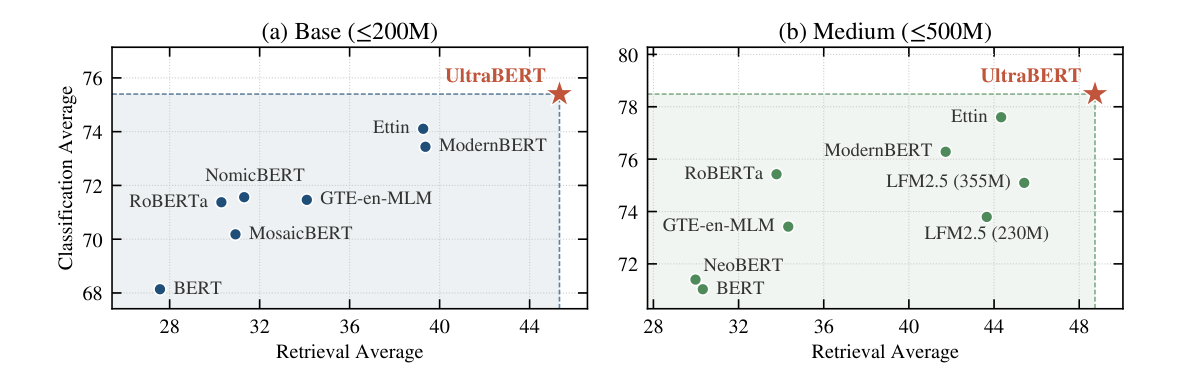
Figure 1. Base(≤200M)와 medium(≤500M) 크기 그룹에서 분류 평균과 검색 평균을 비교한다. 분류 평균은 GLUE, SQuAD 2.0, MultiCoNER v2, Few-NERD, RewardBench의 평균이고 검색 평균은 BEIR, RAR-b Code·Math 평균, MLDR의 평균이다. Park et al. (2026), Figure 1, p. 2.
LongEmbed에서 UltraBERT-150M은 72.0, UltraBERT-380M은 74.9를 기록한다. Table 11은 Passkey와 Needle을 길이별 recall@1 평균으로, 나머지 네 task를 nDCG@10으로 보고한다. Passkey는 두 UltraBERT 크기에서 32K까지 99%대 결과를 보이며, 논문은 길이별 Passkey 정확도를 Figure 11에 제시한다.
8. 저자들이 밝힌 해석의 범위와 결론
논문은 여러 결과를 저자 해석과 구분해 표현한다. RTD의 ratio별 효과를 contextual corruption과 연결하는 설명은 hypothesis이고, masking ratio별 LM head의 gradient-level interference는 conjecture다. KoLeo 실험에서 effective rank가 retrieval을 높이는 원인인지 두 현상이 독립적인지 저자들은 구분할 수 없다고 밝힌다. 토큰 규모 실험의 직접 조건은 150M·1.3B, 30% masking, 최대 8.8T 토큰이다.
저자들은 ethics statement에서 일반 웹 규모 데이터로 학습한 모델이 데이터 편향을 물려받을 수 있으며 사용자는 각 적용처에서 이를 평가해야 한다고 적는다. 사람 대상 자료를 새로 수집하지 않았고, 사전학습 혼합은 공개된 데이터셋으로 구성했다고 설명한다. 재현성 항목은 Appendix A의 구조·학습·pruning·distillation, Appendix B의 task별 평가 protocol, Appendix E의 세부 결과를 안내하고 평가 코드·모델 가중치·사전학습 데이터 혼합을 공개한다고 밝힌다.
결론에서 저자들은 낮은 masking ratio의 분류 성향과 높은 ratio의 검색 성향을 배치 내 혼합과 LM head 분리로 결합하고, 증류를 낮은 ratio에만 적용한 UltraBERT가 150M·380M 두 크기에서 32K 문맥과 함께 분류·검색 결과를 보고한다고 요약한다(Park et al., 2026, §5).
References
Park, J., Lee, T., & Kang, J. (2026). UltraBERT: Beyond the limit of BERT pre-training (Version 1, arXiv:2610.15028v1) [Preprint]. arXiv. https://arxiv.org/abs/2610.15028v1