Kronecker Delta Rule for Long Context Linear Attention
KronLSTM: Kronecker Delta Rule로 장문맥 선형 attention의 기억을 갱신하기
KronLSTM은 검색단서와 저장정보 쌍의 연관을 고치는 Kronecker Delta Rule을 게이트형 기억에 적용합니다. 두 delta rule의 차이, 이론의 가정, 8k·32k 학습과 장문맥 회수 결과, H100 학습 처리량을 구분해 설명합니다.
Paper: Anamaria-Roberta Hartl; Levente Zólyomi; Michael List; Günter Klambauer; Sebastian Böck; Sepp Hochreiter (2026). "Kronecker Delta Rule for Long Context Linear Attention". arXiv preprint, arXiv:2610.26834v1. arXiv · PDF. 판본: 2026-10-19, 53쪽.
초록: 이 논문은 xLSTM 계열의 행렬 기억에 Kronecker Delta Rule을 넣은 KronLSTM을 제안한다. 핵심은 한 key–value 쌍이 만드는 스칼라 연관을 목표값으로 맞추면서, 기억 행렬을 그 쌍의 바깥곱 방향으로만 수정하는 것이다. 논문은 이 규칙을 고정 step size의 확률 과정으로 분석해 평균의 least-squares 수렴, 유일한 stationary distribution, 기대 기억 norm의 bound를 제시하고, 입력 의존 게이트를 갖는 실제 블록과 chunkwise kernel을 구현한다. 1.5B/100B 모델, 8k pretraining, 32k context extension, real-world recall·NIAH·state tracking·throughput 실험을 원문 수치와 조건으로 정리한다.
이 글에서 pair association은 v^{\top}Sk처럼 key와 value를 함께 넣어 얻는 스칼라 점수이고, vector retrieval은 Sk=v처럼 key 하나에서 value 벡터 전체를 회수하는 목표다. 두 목표는 같은 행렬 모양을 사용해도 저장하는 제약과 읽기 방식이 다르다.
1. 문제: 고정 크기 행렬 기억은 무엇을 고치나
Softmax attention은 긴 문맥에서 token 쌍을 직접 비교하므로 계산량이 문맥 길이에 따라 제곱으로 늘고, 추론 때 보관하는 KV cache도 길어진다. 선형 attention은 과거를 고정 크기의 행렬 S\in\mathbb{R}^{d_v\times d_k}에 압축한다. key k_t, query q_t\in\mathbb{R}^{d_k}, value v_t\in\mathbb{R}^{d_v}가 들어오면 기본 읽기는
h_t=S_tq_t이고, Hebbian 선형 attention은
S_{t+1}=S_t+v_tk_t^{\top}처럼 새 바깥곱을 더한다. 이 규칙은 association을 쌓지만 이미 저장한 내용을 오차에 따라 다시 맞추지는 않는다. 길게 쓰면 새 write가 옛 readout을 덮어 버릴 수 있고, 기억의 크기도 입력에 따라 커진다.
DeltaNet은 다른 목표를 둔다. 한 단계에서 S_tk_t가 v_t가 되도록 벡터 residual을 줄여
S_{t+1}=S_t-\beta_t(S_tk_t-v_t)k_t^{\top}
      =S_t(I-\beta_tk_tk_t^{\top})+\beta_tv_tk_t^{\top}
\tag{1}
로 쓴다. 즉 DeltaNet의 loss는 \frac12\lVert S k_t-v_t\rVert_2^2이고, 한 key에 대해 d_v개의 값을 회수하도록 하는 vector retrieval 규칙이다. 현재 memory가 어떤 값을 내놓는지에 따라 correction 방향이 달라지므로 key가 겹치는 다른 value readout에도 영향을 준다.
KronLSTM이 겨냥하는 질문은 다르다. “이 key가 이 value를 회수하는가”가 아니라 “이 key–value pair가 memory에서 얼마나 강하게 연결되어 있는가”를 하나의 수로 정하고, 그 수를 고칠 때 다른 pair의 점수를 덜 바꾸는 방법을 찾는다. 이 차이가 이름의 핵심이며, 단순히 rank-one update를 쓴다는 사실만으로는 두 규칙을 구별할 수 없다.
논문의 비교 대상은 GDN, KDA, GDN-2, Mamba-3, mLSTM이다. 모두 행렬 또는 상태를 순차적으로 갱신하지만, Hebbian write, key-conditioned vector delta, channel-wise decay, Kronecker scalar delta가 서로 다른 목표를 사용한다. 논문은 순수 선형 모델과 2,048-token sliding-window attention을 5:1로 섞은 hybrid 모델을 각각 비교한다.
2. Kronecker Delta Rule: 쌍의 스칼라 연관을 수정하는 식
2.1 표기와 vectorization
한 head에서 memory는 S_t\in\mathbb{R}^{d_v\times d_k}, key와 query는 k_t,q_t\in\mathbb{R}^{d_k}, value는 v_t\in\mathbb{R}^{d_v}이다. 이 글은 논문과 같이 column-major vectorization을 사용한다.
a_t=k_t\otimes v_t=\operatorname{vec}(v_tk_t^{\top}),\qquad
 s_t=\operatorname{vec}(S_t).
\tag{2}
그러면 Kronecker identity로
v_t^{\top}S_tk_t=a_t^{\top}s_t,
 \qquad \lVert a_t\rVert_2^2=\lVert k_t\rVert_2^2\lVert v_t\rVert_2^2
\tag{3}
가 된다. 따라서 matrix의 bilinear score가 Kronecker feature 공간의 선형 score가 된다. \operatorname{vec}(vk^{\top})=k\otimes v라는 순서를 바꾸면 feature와 reshape도 함께 바뀌므로 이 convention은 식 전체에서 고정되어야 한다.
2.2 scalar target과 update
현재 pair의 scalar association을 v_t^{\top}S_tk_t로 정의하고 목표를 c_t\in\mathbb{R}로 두면, 논문의 손실과 gradient update는 다음과 같다.
\ell_t(S)=\frac12\left(v_t^{\top}Sk_t-c_t\right)^2,\begin{aligned}
S_{t+1}
&=S_t-\beta_t\left(v_t^{\top}S_tk_t-c_t\right)v_tk_t^{\top}\\
&=S_t-\beta_t\left(v_t^{\top}S_tk_t\right)v_tk_t^{\top}
+\beta_tc_tv_tk_t^{\top}.
\end{aligned}
\tag{4}첫 항은 현재 pair의 score를 erase하고, 둘째 항은 target을 write한다. c_t=1은 unit-strength association, c_t=0은 그 scalar association을 지우는 경우다. c_t를 입력으로부터 만든 gate로 두면 쓰는 양도 입력 의존이 된다. 논문 본문의 일반 규칙은 두 항에 모두 \beta_t가 붙지만, KronLSTM 블록은 \widetilde c_t=c_t/\beta_t를 사용해 erase gate와 write gate를 분리한다.
같은 pair를 같은 target으로 다시 제시하면 residual r_t=v_t^{\top}S_tk_t-c_t는
r_{t+1}=\left(1-\beta_t\lVert k_t\rVert_2^2\lVert v_t\rVert_2^2\right)r_t
\tag{5}
가 된다. 따라서 0<\beta_t\lVert k_t\rVert_2^2\lVert v_t\rVert_2^2<2에서 residual이 수축하고, \beta_t=1/(\lVert k_t\rVert_2^2\lVert v_t\rVert_2^2)인 Newton step에서는 한 번에 target을 맞춘다.
식 (4)를 vectorized하면
s_{t+1}=(I-\beta_ta_ta_t^{\top})s_t+\beta_tc_ta_t.
\tag{6}
이는 입력이 a_t=k_t\otimes v_t이고 목표가 scalar c_t인 Widrow–Hoff/LMS Delta Rule이다. 그러므로 Kron rule의 “Delta”는 새로운 행렬 항등식이라는 뜻이 아니라, matrix association을 Kronecker feature 공간의 delta rule로 읽는다는 뜻이다.
2.3 pair와 vector의 간섭·capacity
다른 probe pair (k_i,v_i)의 score가 이번 update로 바뀌는 양은
\Delta\left(v_i^{\top}Sk_i\right)
=-\beta_t\left(v_t^{\top}S_tk_t-c_t\right)
  (v_i^{\top}v_t)(k_t^{\top}k_i).
\tag{7}
key overlap이나 value overlap 중 하나가 0이면 그 scalar pair score는 변하지 않는다. 반면 DeltaNet의 vector target S k_t=v_t는 key overlap을 통해 여러 value 좌표를 함께 바꾼다. Kron rule의 correction 방향 v_tk_t^{\top}는 memory를 읽어 결정하는 것이 아니라 입력 pair가 정하므로, 이 식의 overlap 곱이 pair 수준의 footprint를 설명한다.
{a_i}가 선형 독립이면 각 triple (k_i,v_i,c_i)는 하나의 선형 제약 a_i^{\top}s=c_i를 주므로 최대 d_kd_v개의 scalar association을 정확히 맞출 수 있다. d개의 orthonormal key와 d개의 orthonormal value를 예로 들면 d^2개의 pair (k_i,v_j)에 각각 다른 scalar c_{ij}를 저장할 수 있고, V^{\top}SK=C^{\top}로 읽는다. 이것은 “d_kd_v개의 scalar slot”이라는 capacity이며, DeltaNet의 “d_v차원 value vector를 key마다 회수”하는 capacity와 같은 단위가 아니다.
논문 부록 A3.4는 같은 scalar constraint를 만족시키는 보정들만 비교한다. Newton correction은 Frobenius norm과 모든 unitarily invariant norm을 최소화하고, column space를 v_t 방향에, row space를 k_t 방향에 둘 수 있는 유일한 correction이며, isotropic probe에서 기대 interference도 최소화한다. 이 정리는 scalar pair 목표에 대한 최소성이다. vector retrieval 목표를 더 잘 수행한다는 정리로 바뀌지는 않는다.
3. 수렴 정리의 가정과 기억 norm
3.1 확률 모델
본문의 이론은 실제 입력 stream 전체를 곧바로 모델링하지 않고, 고정 step size \beta와 i.i.d. triple (k_t,v_t,c_t)\sim p를 가정한다. a=k\otimes v에 대해
\bar A=\mathbb{E}[aa^{\top}]\succ0,
\qquad \bar b=\mathbb{E}[ca],
\qquad s_{LS}=\bar A^{-1}\bar b,
\qquad \rho=c-a^{\top}s_{LS}
\tag{8}
를 둔다. s_{LS}는 scalar target을 feature a로 예측하는 least-squares memory이고, \rho는 설명되지 않는 residual이다. 부록의 finite-support 설정에서는 과거와 독립인 index를 p_i>0로 뽑고, feature matrix가 full column rank d_kd_v이며, 유한 2차 모멘트와 고정 \beta를 갖고, 모든 sample에서
0<\beta\lVert a_i\rVert_2^2<2
\tag{9}
를 요구한다. Theorem 2의 간단한 non-expansive bound에는 더 강한
\kappa=\beta\max_i\lVert a_i\rVert_2^2\le 1
\tag{10}
과 S_0=0이 필요하다. \bar A\succ0는 모든 Kronecker feature 방향이 충분히 관측된다는 뜻이며, key와 value를 각각 정규화했다는 사실만으로 이 조건이 자동으로 생기지는 않는다.
3.2 Theorem 1: 평균과 stationary distribution
식 (6)의 기대값은 정확히
\mathbb{E}[s_{t+1}]
=(I-\beta\bar A)\mathbb{E}[s_t]+\beta\bar b
\tag{11}
이다. \beta\lVert a_i\rVert^2<2와 full-rank 조건 아래 평균의 고정점은 s_{LS}이고, 고유값을 \lambda_k(\bar A)라 하면
\left\lVert\mathbb{E}[S_t]-S_{LS}\right\rVert_F
\le r^t\left\lVert S_0-S_{LS}\right\rVert_F,
\qquad
r=\max_k\left|1-\beta\lambda_k(\bar A)\right|<1.
\tag{12}
논문은 여기에 Markov-chain 분석을 붙인다. 같은 random index를 두 memory에 적용하는 synchronous coupling에서는 additive residual 항이 서로 지워지고, homogeneous factor만 남는다. 그 결과 finite second moment를 갖는 법률 공간의 Wasserstein-2 거리에서 transition kernel이 수축하고, 유일한 stationary distribution \pi_\beta가 존재하며 S_t의 법칙이 그 분포로 기하급수적으로 수렴한다. stationary mean은 정확히 \mathbb{E}{\pi\beta}[S]=S_{LS}이다.
이는 각 sample path가 한 값으로 수렴한다는 뜻은 아니다. target들이 서로 맞지 않는 overloaded stream에서는 residual에 의해 stationary fluctuation과 LMS misadjustment가 남는다. consistent target이면 residual이 0이 되어 relaxed Kaczmarz 수렴을 회복할 수 있고, constant \beta에서 시간 평균을 취해 S_{LS}에 접근하는 경우도 부록에 정리되어 있다.
3.3 Theorem 2: 기대 norm bound
least-squares memory는 설명된 target energy와 feature covariance의 고유값 사이에 놓인다.
\frac{\mathbb{E}[c^2]-\mathbb{E}[\rho^2]}{\lambda_{\max}(\bar A)}
\le \lVert S_{LS}\rVert_F^2
\le
\frac{\mathbb{E}[c^2]-\mathbb{E}[\rho^2]}{\lambda_{\min}(\bar A)}.
\tag{13}\kappa\le1이고 S_0=0이면 q_\beta=1-\beta(2-\kappa)\lambda_{\min}(\bar A)에 대해
\mathbb{E}\lVert S_t\rVert_F^2
\le \left(1+q_\beta^{t/2}\right)^2
\frac{\mathbb{E}[c^2]}{\lambda_{\min}(\bar A)}
\le \frac{4\mathbb{E}[c^2]}{\lambda_{\min}(\bar A)}.
\tag{14}
stationary law의 expected squared norm에는 더 작은 상한 \mathbb{E}[c^2]/\lambda_{\min}(\bar A)가 제시된다. \lambda_{\min}(\bar A)가 작으면 feature coverage가 나쁜 것이므로 bound가 커진다. 즉 정리의 상수는 target energy뿐 아니라 Kronecker feature 분포의 conditioning에도 의존한다.
3.4 고정 beta 이론과 실제 게이트
실제 KronLSTM에서는 F_t,\beta_t,c_t,k_t,v_t가 layer input x_t의 함수다. 실제 recurrence를 vectorized하면
s_{t+1}=(I-\beta_ta_ta_t^{\top})(F_t\otimes I_{d_v})s_t+c_ta_t
\tag{15}
가 된다. 이는 고정 \beta, i.i.d. feature와 target을 전제로 한 식 (6)의 Markov chain과 다른 과정이다. 논문 본문은 L2-normalized key·value와 sigmoid \beta_t 때문에 각 rank-one homogeneous factor가 non-expansive이고, F_t의 diagonal도 1보다 작아 추가 contraction을 준다고 설명한다. 이 설명은 실제 block의 per-step spectral 성질을 말하며, Theorem 1–2의 fixed-\beta stationary law와 동일한 가정을 선언하는 것은 아니다.
특히 분리된 write를 개념적으로 \widetilde c_t=c_t/\beta_t로 나타낼 수 있지만 \beta_t\to0이면 이 값은 커질 수 있다. 구현은 +c_tv_tk_t^{\top}를 직접 사용하므로, 이 write gate를 고정-\beta 정리의 scalar target과 그대로 동일시하지 않는다. 논문이 증명한 것은 지정한 확률 모델에서의 memory 평균·분포·기대 norm이며, input-dependent gate와 deep optimizer 전체를 같은 정리의 대상으로 바꾸지는 않는다.
4. 실제 KronLSTM 블록과 chunkwise 계산
4.1 세 가지 gate와 읽기
KronLSTM은 key 방향 forget, scalar erase, scalar write를 분리한다.
S_{t+1}=S_tF_t
-\beta_t\left(v_t^{\top}S_tF_tk_t\right)v_tk_t^{\top}
+c_tv_tk_t^{\top}.
\tag{16}
F_t=\operatorname{diag}(f_t)\in\mathbb{R}^{d_k\times d_k}는 key 차원별 forget이다. erase gate와 write gate는
\beta_t=\sigma(w_\beta^{\top}x_t+b_\beta),
\qquad
c_t=\sigma(w_c^{\top}x_t+b_c)
\tag{17}
로 만들며 각각 (0,1)에 있다. forget vector는
f_t=\sigma(-(s_f)_t)^\alpha,
 \qquad s_f=W_fx_t+b_f,
 \qquad \alpha=\exp(a_{\log})>0
\tag{18}
이다. a_{\log}는 head마다 하나인 학습 scalar이고, 지수는 head의 retention timescale을 조절한다.
각 head의 q,k,v는 입력의 linear projection 뒤에 짧은 causal depthwise convolution과 SiLU를 거치고 L2 normalize된다. memory readout \widetilde h_t=S_tq_t에는 value 차원의 sigmoid output gate와 per-head RMSNorm을 적용하고, head들을 output projection으로 섞는다. mLSTM의 normalizer state와 stabilizer state는 KronLSTM에 없고, 실제 state는 각 head의 S_t이다.
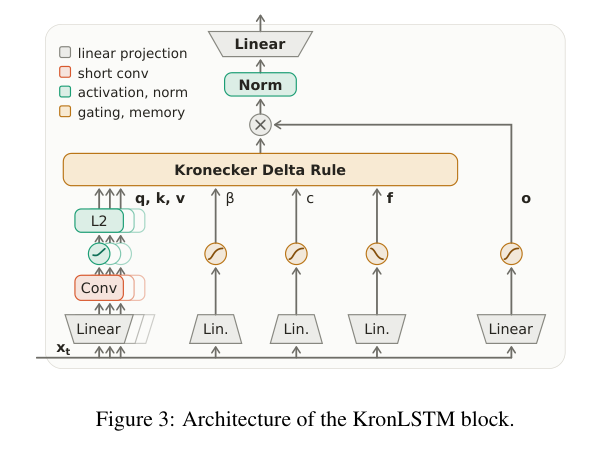
그림 1. Hartl et al. (2026), Figure 3, PDF p. 6. 입력에서 q·k·v projection, 세 gate, matrix memory, query readout과 output gate로 이어지는 KronLSTM block이다. 이미지를 누르면 논문 도판 파일을 연다.
4.2 chunkwise-parallel 알고리즘
부록 A8은 token recurrence를 chunk 길이 C의 행렬 계산으로 바꾼다. chunk 안에서 누적 forget을 \gamma_r로 모으고, decay-scaled key·query를 사용하면
\widetilde S_r=\widetilde S_{r-1}+u_rv_r\bar k_r^{\top},
\qquad
u_r=c_r-\beta_r v_r^{\top}\widetilde S_{r-1}\widetilde k_r
\tag{19}
가 된다. u_r들은 decay-weighted key Gram과 value Gram의 Hadamard product로 만든 unit lower-triangular system을 푸는 방식으로 한 chunk에서 계산한다. Kronecker feature k_r\otimes v_r를 길이 d_kd_v로 실제 생성하지 않고, key Gram·value Gram·Hadamard 곱만 사용한다. incoming memory가 solve에 들어가는 양은 각 token의 scalar score v_r^{\top}S_0\widetilde k_r이다.
한 head·한 chunk의 보고 비용은 key Gram 두 개에 2C^2d_k, value Gram에 C^2d_v, triangular solve에 O(C^3), memory와의 세 곱에 3Cd_kd_v, intra-chunk contraction에 C^2d_v이다. C를 고정하면 길이 L에 대해 선형이지만, chunk solve와 value-dimension contraction은 kernel과 hardware에 따라 상수가 달라진다. backward에서는 value Gram이 system matrix에 들어가므로 DeltaNet·GDN·KDA와 다른 gradient 경로가 생긴다.
저자들은 reference recurrence와 chunk kernel의 double-precision forward·operator 오차를 상대값 10^{-15} 이하, central finite-difference gradient 오차를 10^{-9} 수준으로 보고한다. 부록 A8.9는 chunk 길이 1, 8, 16, 전체 길이, 길이의 배수 여부, d_k\ne d_v, nonzero initial memory, 강·약 decay, \beta\in(0,1)와 (0,2)를 포함했다고 기술한다.
5. 실험 설계: 1.5B pretraining, hybrid, context extension
5.1 1.5B/100B 모델의 공통 recipe
주요 실험은 1.5B parameter decoder-only 모델을 100B tokens로 학습한다. 24 layers, hidden dimension 2048, 16 heads, 다른 baseline과 KronLSTM의 d_{qk}=d_v=128을 사용한다. FineWeb-Edu 100B-token sample을 Llama 2 tokenizer(vocabulary 32,000)로 토큰화하고 EOS로 문서를 이어 8,192-token sequence로 packing한다. 이 8k는 pretraining context이며, 모든 주요 비교 모델이 같은 corpus·tokenizer·optimizer·schedule·batch size·seed를 공유하고 mixer만 바꾼다.
순수 linear 설정과, linear layer 5개마다 2,048-token SWA layer 하나를 넣는 5:1 hybrid 설정을 모두 평가한다. optimizer는 AdamW(\beta=(0.9,0.95), \epsilon=10^{-10}), peak learning rate 3\times10^{-4}, 10% linear warmup 뒤 3\times10^{-5}까지 cosine decay, weight decay 0.1, global gradient clip 1.0이다. precision은 bf16 mixed precision이고 optimizer state는 fp32이다. global batch는 128 sequences, 즉 step당 1,048,576 tokens이다. 본 학습은 16 nodes × 4 NVIDIA GH200에서 FSDP-2 data parallelism으로 수행했다.
400M/40B 부록 모델은 24 layers, hidden 1024, 4 heads, d_v=256이다. 이것은 1.5B/100B 표와 다른 규모·token budget이며, 본문 수치에 섞지 않는다.
5.2 metric과 context protocol
Table 1의 Avg-6은 HellaSwag, PIQA, ARC-easy, ARC-challenge, WinoGrande, LAMBADA accuracy의 평균이다. LAMBADA perplexity는 별도 열이다. Table 2는 SWDE, SQuAD, FDA, TriviaQA, NQ, DROP의 2k real-world recall suite다. Table 3은 8k로 pretrain한 checkpoint를 4k·8k·16k에서 RULER NIAH로 평가하며 16k는 pretraining 길이 밖의 zero-shot extrapolation이다.
이 단계는 Gao et al. (2024)의 ProLong-64K에서 가져온 books·code·textbooks·arXiv long-document mixture와 FineWeb-Edu를 사용하고, optimizer state를 다시 시작하며, 5% warmup과 peak 8.4\times10^{-5}에서 cosine schedule을 다시 적용한다.
6. 결과: 언어 모델링, 장문맥, state tracking, throughput
6.1 Table 1 언어 모델링
| 설정 | 모델 | Avg-6 ↑ | LAMBADA PPL ↓ |
|---|---|---|---|
| Linear | GDN | 57.73 | 12.58 |
| Linear | Mamba-3 | 57.31 | 12.95 |
| Linear | KDA | 58.12 | 12.67 |
| Linear | GDN-2 | 57.94 | 12.54 |
| Linear | mLSTM | 57.18 | 13.87 |
| Linear | KronLSTM | 59.72 | 11.72 |
| Hybrid 5:1 | GDN | 57.99 | 12.95 |
| Hybrid 5:1 | Mamba-3 | 58.54 | 13.01 |
| Hybrid 5:1 | KDA | 57.85 | 12.60 |
| Hybrid 5:1 | GDN-2 | 58.79 | 11.85 |
| Hybrid 5:1 | mLSTM | 57.35 | 14.38 |
| Hybrid 5:1 | KronLSTM | 59.56 | 11.18 |
표 1. Hartl et al. (2026) Table 1, PDF p. 7. 모든 값은 1.5B/100B, 8k pretraining의 저자 보고값이다.
Linear KronLSTM의 Avg-6은 KDA보다 1.60 accuracy points 높고, 여섯 task 중 다섯 task에서 최고다. hybrid KronLSTM은 GDN-2보다 Avg-6이 0.77점 높고 네 task에서 최고다. 다만 각 열의 최고 모델은 다르다. 예를 들어 Linear PIQA는 GDN 73.61이 KronLSTM 73.45보다 높고, Hybrid ARC-easy는 GDN-2 72.64가 KronLSTM 71.93보다 높다.
6.2 Table 2 real-world recall
| 설정 | GDN | Mamba-3 | KDA | GDN-2 | mLSTM | KronLSTM |
|---|---|---|---|---|---|---|
| Linear Avg-6 ↑ | 29.81 | 28.41 | 29.17 | 29.39 | 28.79 | 30.31 |
| Hybrid Avg-6 ↑ | 35.27 | 36.96 | 36.01 | 35.85 | 36.37 | 37.40 |
표 2. Hartl et al. (2026) Table 2, PDF p. 8. SWDE·SQuAD·FDA·TriviaQA·NQ·DROP의 2k context 산술평균이다.
Linear KronLSTM은 SWDE 30.87, SQuAD 39.28, FDA 15.34, TriviaQA 61.61, NQ 15.46, DROP 19.31을 기록했다. hybrid은 각각 46.89, 43.57, 27.86, 64.51, 18.82, 22.76이다. 두 설정 모두 여섯 task 중 세 task에서 KronLSTM이 최고이며, hybrid 평균은 Mamba-3 36.96보다 0.44점 높다.
6.3 Table 3 NIAH와 32k extension
8k pretraining checkpoint의 NIAH 일부 결과를 다음처럼 읽을 수 있다. 각 셀은 4k / 8k / 16k accuracy(%)다.
| 모델·설정 | S2 | MQ | MV |
|---|---|---|---|
| Linear GDN | 96.0 / 45.6 / 17.8 | 44.8 / 21.2 / 8.6 | 46.8 / 23.5 / 13.8 |
| Linear KronLSTM | 98.2 / 60.4 / 16.0 | 47.2 / 24.8 / 12.7 | 43.3 / 24.6 / 17.6 |
| Hybrid GDN-2 | 56.0 / 31.2 / 16.6 | 33.2 / 23.2 / 3.0 | 40.5 / 22.7 / 12.8 |
| Hybrid KronLSTM | 71.2 / 35.0 / 17.4 | 38.8 / 23.1 / 12.2 | 44.5 / 21.8 / 13.2 |
표 3. Hartl et al. (2026) Table 3의 S2·MQ·MV 발췌, PDF p. 9. 16k는 8k pretraining 밖의 평가다.
Linear KronLSTM의 S2는 8k에서 GDN보다 14.8점 높지만 16k에서는 1.8점 낮다. MQ의 GDN 대비 차이는 2.4, 3.6, 4.1점이고 MV의 차이는 −3.5, 1.1, 3.8점이다. S1은 Linear KronLSTM이 4k/8k/16k에서 66.2/29.4/11.6인 반면 GDN은 100.0/100.0/99.2이다. 논문은 S1의 반복 noise sentence와 recurring key에서 residual accumulation이 생길 수 있다고 설명한다. SWA hybrid의 window 밖 retrieval이 제한되는 현상과 함께, task별 숫자를 구분해 보고한다.
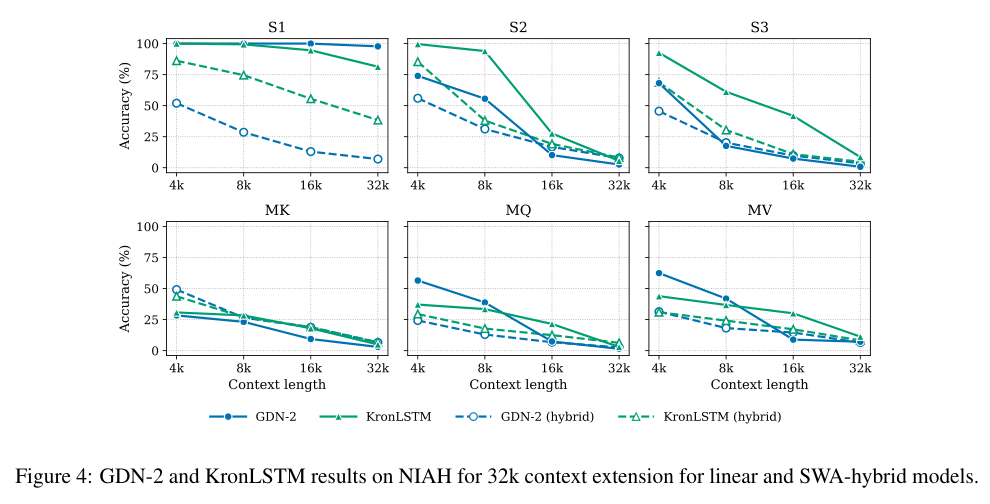
그림 2. Hartl et al. (2026), Figure 4, PDF p. 10. 8k pretraining에서 32k로 continued pretraining한 GDN-2와 KronLSTM의 linear·hybrid NIAH이다. 이미지를 누르면 논문 도판 파일을 연다.
| 설정 | 모델 | Avg-6 ↑ | LMB PPL ↓ | Recall avg ↑ | FDA |
|---|---|---|---|---|---|
| Linear | GDN-2 | 58.75 | 8.36 | 29.95 | 19.60 |
| Linear | KronLSTM | 60.19 | 7.66 | 31.08 | 18.15 |
| Hybrid | GDN-2 | 59.32 | 8.27 | 35.21 | 30.40 |
| Hybrid | KronLSTM | 60.10 | 7.64 | 36.23 | 23.96 |
표 4. Hartl et al. (2026) Table 4, PDF p. 9. context extension 뒤 recall은 2,048-token 평가다.
32k extension에서 KronLSTM은 두 설정 모두 GDN-2보다 Avg-6과 perplexity가 좋고 recall 평균도 높다. Linear recall은 30.31에서 31.08로, hybrid recall은 37.40에서 36.23으로 바뀐다. 이 수치는 Table 2와 Table 4의 평가 context가 같아도 학습 branch와 data mixture가 달라졌다는 조건 안에서 읽는다. Appendix Table A4는 32k에서 Linear KronLSTM이 S1 81.4, S2 5.6, S3 8.6, MK 5.0, MQ 3.0, MV 11.3을, Hybrid KronLSTM이 각각 38.4, 8.2, 4.8, 6.8, 6.3, 8.3을 보고한다. GDN-2와 두 설정 모두 16k보다 32k에서 accuracy가 크게 내려간다.
6.4 state tracking
논문은 state-tracking을 위해 \beta_t=2\sigma(\cdot)\in(0,2)로 범위를 넓힌다. parity, S3 permutation, modulo arithmetic을 사용하며, sequence length는 학습 최대 128, 평가 128·256·512·1024이다. parity와 S3는 두 blocks, 50k steps, learning rate 후보 10^{-3}와 10^{-4}를 사용하고, modulo arithmetic은 세 blocks와 150k steps가 필요하다. 각 길이에는 50,000개의 fresh sequence를 평가하고 seeds 1–3의 mean ± standard deviation을 보고하며, learning rate는 length 256의 평균 정확도가 가장 높은 값으로 선택한다.
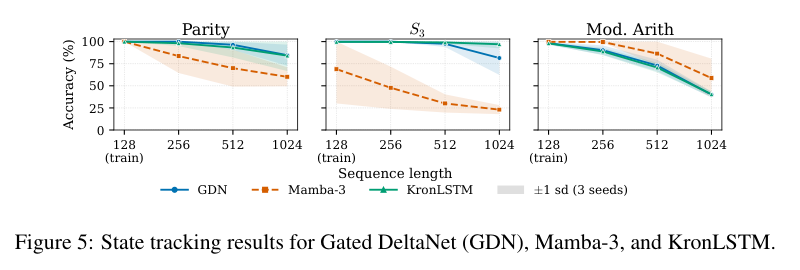
그림 3. Hartl et al. (2026), Figure 5, PDF p. 10. GDN·Mamba-3·KronLSTM의 parity, S3 permutation, modulo arithmetic state tracking 결과다. 이미지를 누르면 논문 도판 파일을 연다.
KronLSTM은 parity와 S3에서 GDN과 비슷하고 Mamba-3보다 높으며, modulo arithmetic에서는 Mamba-3가 앞선다. 이 실험의 \beta 범위는 언어 모델 block의 sigmoid \beta_t\in(0,1) 및 Theorem 2의 non-expansive 설정과 다르다.
6.5 training throughput의 범위
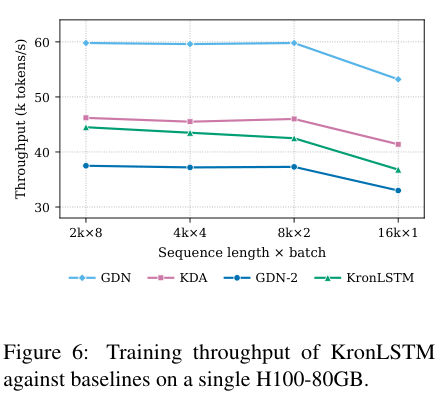
그림 4. Hartl et al. (2026), Figure 6, PDF p. 10. 순수 linear 1.5B 모델의 single H100-80GB training throughput이다. 이미지를 누르면 논문 도판 파일을 연다.
Fig. 6은 single NVIDIA H100 80GB에서 한 step당 16,384 tokens를 처리하며, sequence length × batch를 2k×8, 4k×4, 8k×2, 16k×1로 바꾼다. 순수 linear 1.5B 모델에서 KronLSTM은 36.8–44.5K tokens/s로 GDN-2보다 모든 shape에서 11–18% 높고, 8k×2까지는 KDA보다 4–8% 낮다. GDN은 가장 빠른 baseline이며 16k×1에서는 모든 모델이 느려진다.
이 figure의 단위는 end-to-end training throughput이다. inference TPOT, prefill latency, KV-cache bytes, peak activation memory, 32k retrieval 속도를 측정한 표가 아니다. 32k extension 결과는 retrieval과 language-model metric이고, Fig. 6은 pure-linear 1.5B fixed-token training step이라는 별도 protocol이다.
6.6 400M 결과와 write-rule ablation
Appendix Table A2의 400M/40B linear 모델에서 KronLSTM은 Avg-6 48.43, LAMBADA PPL 28.28이다. mLSTM은 표의 Avg-6 46.29, PPL 43.40이고, KDA는 PPL 27.84, Mamba-3는 PIQA 67.25, GDN-2는 ARC-easy 60.23으로 각 열의 선두가 나뉜다. WinoGrande에서는 GDN-2와 KronLSTM이 52.41로 공동 선두다.
| variant | Avg-6 ↑ | LMB PPL ↓ | Recall 2k ↑ | NIAH 4k / 8k / 16k |
|---|---|---|---|---|
| base | 59.72 | 11.716 | 30.3 | 59.5 / 30.5 / 14.3 |
| no L2 norm on value | 59.41 | 11.844 | 31.3 | 39.6 / 32.7 / 12.6 |
| beta on both sides | 60.00 | 11.479 | 30.8 | 46.9 / 29.4 / 11.8 |
| non-learnable target | 58.17 | 12.495 | 30.1 | 41.9 / 26.2 / 10.1 |
표 5. Hartl et al. (2026) Table A3, PDF p. 47. 1.5B/100B write-rule ablation이다.
논문은 write gate를 unit target으로 고정하면 language-model Avg-6이 1.6점, perplexity가 0.8만큼 나빠지고, L2 normalization 제거와 coupled erase/write는 언어 모델링에서 base와 가까우며 NIAH에서는 길이에 따라 순서가 바뀐다고 보고한다. 이 표는 scalar target과 erase/write 분리가 서로 다른 실험 variant임을 보여 준다.
7. 논문이 남기는 범위와 저자 한계
KronLSTM의 방법은 행렬 memory에서 pair (k,v)의 scalar score v^{\top}Sk를 target에 맞추고, correction을 vk^{\top} 한 방향으로 제한한다. vectorized feature k\otimes v를 쓰면 classical LMS, relaxed Kaczmarz, generalized Householder transition과 같은 형태가 되며, pair overlap의 곱으로 interference를 기술할 수 있다. 논문은 fixed-\beta i.i.d. model에서 평균이 least-squares memory로 수렴하고 law가 stationary distribution으로 수렴하며, feature covariance가 충분히 조건화된 경우 expected memory norm을 bound한다고 증명한다.
실제 block은 key-wise forget, scalar erase, scalar write, projection·convolution·SiLU·L2 normalization·output gate·RMSNorm을 함께 사용한다. 이 block의 gates는 입력에 의존하고, 8k pretraining의 natural-text 모델과 32k continued-pretraining 모델은 서로 다른 context-training protocol을 사용한다. 1.5B/100B의 Avg-6·recall·NIAH·throughput 결과, 400M/40B 부록, state-tracking 결과는 각각 표의 metric과 조건 안에서 제시된다.
저자들은 결론에서 더 큰 규모의 KronLSTM scaling과 full softmax attention layer를 포함한 hybrid training을 향후 과제로 적다. 현재 논문의 hybrid는 2,048-token SWA를 5:1로 섞은 설정이며, full softmax hybrid는 결과에 포함되지 않는다.
References
Arora, S., Eyuboglu, S., Zhang, M., Timalsina, S., Alberti, S., Zinsley, D., Zou, J., Rudra, A., & Ré, C. (2024). Simple linear attention language models balance the recall-throughput tradeoff. Proceedings of the 41st International Conference on Machine Learning, 235, 1763–1840. https://proceedings.mlr.press/v235/arora24a.html
Beck, M., Pöppel, K., Spanring, M., Auer, A., Prudnikova, O., Kopp, M., Klambauer, G., Brandstetter, J., & Hochreiter, S. (2024). xLSTM: Extended long short-term memory. Advances in Neural Information Processing Systems, 37, 107547–107603. https://doi.org/10.52202/079017-3417
Gao, T., Wettig, A., Yen, H., & Chen, D. (2024). How to train long-context language models (effectively) (arXiv:2410.02660). arXiv. https://arxiv.org/abs/2410.02660
Grazzi, R., Siems, J., Zela, A., Franke, J. K. H., Hutter, F., & Pontil, M. (2025). Unlocking state-tracking in linear RNNs through negative eigenvalues. International Conference on Learning Representations. https://openreview.net/forum?id=UvTo3tVBk2
Hartl, A.-R., Zólyomi, L., List, M., Klambauer, G., Böck, S., & Hochreiter, S. (2026). Kronecker Delta Rule for long context linear attention (arXiv:2610.26834v1). arXiv. https://arxiv.org/abs/2610.26834v1
Hatamizadeh, A., Choi, Y., & Kautz, J. (2026). Gated DeltaNet-2: Decoupling erase and write in linear attention (arXiv:2605.22791). arXiv. https://arxiv.org/abs/2605.22791
Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780. https://doi.org/10.1162/neco.1997.9.8.1735
Hsieh, C.-P., Sun, S., Kriman, S., Acharya, S., Rekesh, D., Jia, F., Zhang, Y., & Ginsburg, B. (2024). RULER: What’s the real context size of your long-context language models? Conference on Language Modeling, 1. https://openreview.net/pdf?id=kIoBbc76Sy
Katharopoulos, A., Vyas, A., Pappas, N., & Fleuret, F. (2020). Transformers are RNNs: Fast autoregressive transformers with linear attention. Proceedings of the 37th International Conference on Machine Learning, 119, 5156–5165. https://proceedings.mlr.press/v119/katharopoulos20a.html
Kimi Team. (2025). Kimi Linear: An expressive, efficient attention architecture (arXiv:2510.26692v2). arXiv. https://arxiv.org/abs/2510.26692
Schlag, I., Irie, K., & Schmidhuber, J. (2021). Linear transformers are secretly fast weight programmers. Proceedings of the 38th International Conference on Machine Learning, 139, 9355–9366. https://proceedings.mlr.press/v139/schlag21a.html
Widrow, B., & Hoff, M. E. (1960). Adaptive switching circuits. In 1960 IRE WESCON Convention Record, Part 4 (pp. 96–104).
Yang, S., Wang, B., Zhang, Y., Shen, Y., & Kim, Y. (2024). Parallelizing linear transformers with the delta rule over sequence length. Advances in Neural Information Processing Systems, 37, 115491–115522. https://doi.org/10.52202/079017-3668
Yang, S., Kautz, J., & Hatamizadeh, A. (2025). Gated delta networks: Improving Mamba2 with delta rule. International Conference on Learning Representations. https://openreview.net/forum?id=r8H7xhYPwz
Zellers, R., Holtzman, A., Bisk, Y., Farhadi, A., & Choi, Y. (2019). HellaSwag: Can a machine really finish your sentence? Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, 4791–4800. https://aclanthology.org/P19-1472/
Keywords: KronLSTM, Kronecker Delta Rule, scalar pair association, DeltaNet, long-context retrieval, expected memory norm, chunkwise linear attention Author: PaperWiki Last Updated: 2026-10-24