Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention
Latent Sparse Attention 쉬운 읽기
초장문맥 sparse attention에서 비용의 대부분이 key를 찾는 인덱서에 있다는 점을 짚고, 비슷한 key를 묶어 묶음만 고르는 LSA를 설명합니다. 10M 토큰까지의 정확도와 속도 향상, 처음부터 학습하는 N-LSA, 저자가 밝힌 한계를 함께 봅니다.
Paper: Ales Kubicek; Andrea Caciolai; Liangzu Peng; Sukrit Sumant; Benjamin Hoover; Fraser Greenlee; Ruairidh M. Battleday; Radim Urban; Torsten Hoefler; James C. R. Whittington (2026). "Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention". arXiv preprint, arXiv:2610.42147v1, 2026-10-30. 원문 · PDF.
판본: arXiv:2610.42147v1, 2026-10-30, 32쪽 읽기 버전: 2026-11-03
1. 문맥이 천만 토큰이 되면 무엇이 느려질까요
최근 LLM은 100만 토큰이 넘는 문맥을 다룹니다. 이 길이에서는 attention이 비용의 대부분을 차지합니다. 그래서 많은 모델이 **sparse attention(희소 attention)**을 씁니다. 모든 이전 토큰을 보는 대신, **인덱서(indexer)**가 query마다 중요한 key 몇 개를 골라 그것만 봅니다.
문제는 인덱서 자신입니다. 고를 key를 찾으려고 인덱서는 여전히 모든 key를 훑습니다. 논문 측정에서 1,000만(10M) 토큰일 때 인덱서가 sparse attention prefill 시간의 98%를 차지했습니다. 인덱서 비용이 없다면 prefill은 58배, decode는 8.9배 더 빨라질 수 있었습니다.
2. 비슷한 key끼리 묶어 두고, 묶음만 고릅니다
**LSA(Latent Sparse Attention)**는 key를 위치가 아니라 의미로 묶습니다. 학습된 작은 공간(latent space, 잠재 공간)에서 비슷한 key들을 **bucket(묶음)**으로 모으고, 각 묶음의 대표점인 **centroid(중심)**만 저장합니다. query는 모든 key 대신 이 중심들만 점수화해 상위 묶음을 고르고, 그 안의 key에 attention합니다. 처음 몇 개의 sink key와 최근 key(window)는 항상 함께 봅니다.
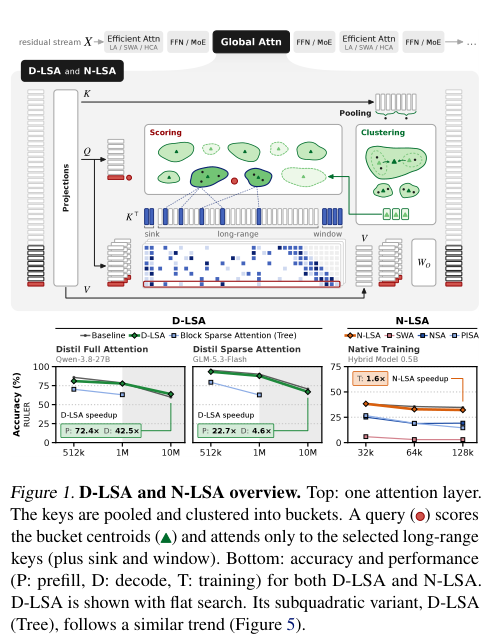
원 논문 Figure 1(논문 PDF 1쪽): 위는 attention 레이어 하나의 흐름입니다. key를 모으고(Pooling) 묶은 뒤(Clustering), query(빨간 점)가 묶음의 중심(삼각형)만 점수화해 고른 key에만 attention합니다. 아래는 두 변형의 정확도와 속도 향상(P: prefill, D: decode, T: 학습)입니다. 원문 PDF에서 보기.
묶음을 찾는 방식은 두 가지입니다. Flat 검색은 모든 중심을 점수화하고, Tree 검색은 묶음을 여러 층의 나무로 쌓아 위에서부터 내려가며 후보를 좁힙니다. Tree는 query마다 중심을 O(\log T)개만 보면 되므로 문맥 길이 T가 커져도 비용이 훨씬 천천히 늘어납니다.
3. 기존 모델에 붙이는 D-LSA, 처음부터 배우는 N-LSA
- D-LSA(증류형): 이미 학습된 모델은 그대로 두고, key·query를 작은 64차원 공간으로 옮기는 행렬 두 개와 레이어별 온도만 학습합니다. 원래 모델의 attention 분포를 따라 하도록 **증류(distillation)**하며, 학습량은 352M 토큰입니다.
- N-LSA(네이티브형): 인덱서용 투영 없이 attention의 key를 직접 묶고, 다음 토큰 예측 loss만으로 처음부터 학습합니다. 파라미터, 교사 모델, 보조 손실이 추가되지 않습니다.
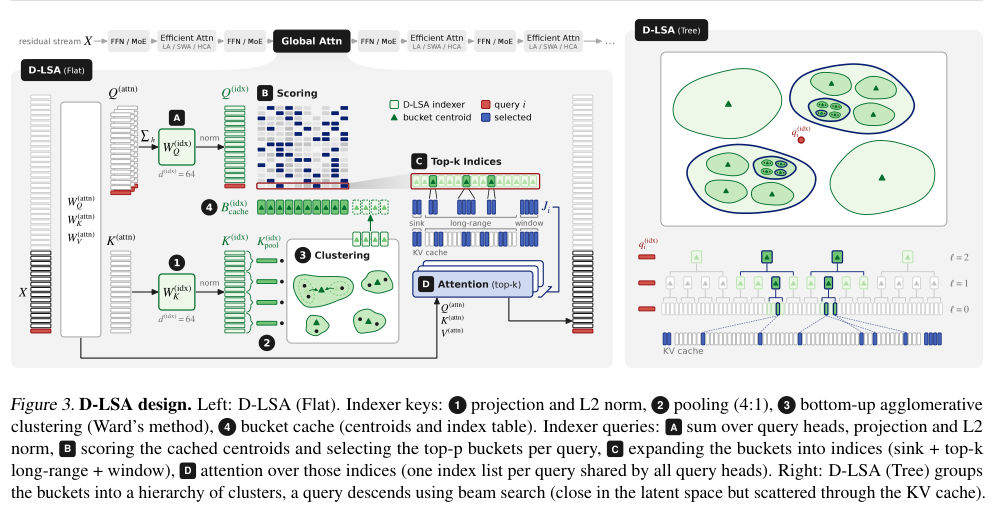
원 논문 Figure 3(논문 PDF 4쪽): 왼쪽 D-LSA (Flat)에서 key는 ① 투영·정규화, ② 4개씩 합치기, ③ Ward 방법으로 묶기, ④ 중심 저장을 거칩니다. query는 Ⓐ 투영, Ⓑ 중심 점수화, Ⓒ 고른 묶음을 key 목록으로 펼치기, Ⓓ attention 순서로 처리됩니다. 오른쪽 Tree는 묶음을 계층으로 쌓아 beam search로 내려갑니다. 원문 PDF에서 보기.
4. 정확도는 거의 그대로였습니다
D-LSA는 full attention을 쓰는 QWEN-3.8-27B와, 원래 sparse attention을 쓰는 GLM-5.3-FLASH에 붙여 평가했습니다. 지식(MMLU-Pro, GPQA-Diamond), 추론(AIME25, MATH500), LongBench v2에서는 두 모델 모두 원래 성능의 95% 신뢰구간 안에 있었습니다.
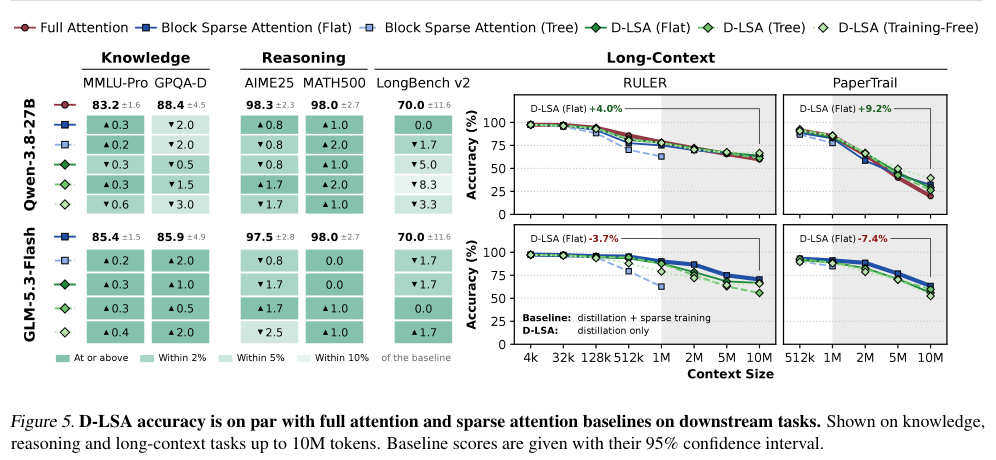
원 논문 Figure 5(논문 PDF 8쪽): 왼쪽 표는 지식·추론 과제에서 원래 모델 대비 점수 차이이고, 오른쪽 그래프는 4k부터 10M 토큰까지의 RULER와 PaperTrail 정확도입니다. 위 줄은 QWEN-3.8-27B, 아래 줄은 GLM-5.3-FLASH입니다. 원문 PDF에서 보기.
긴 문맥에서는 모델마다 달랐습니다.
- QWEN-3.8-27B: D-LSA (Flat)는 1M 토큰까지 full attention과 5점 이내였고, 10M에서는 오히려 앞섰습니다(RULER 63.9 대 59.9, PaperTrail 29.1 대 19.8).
- GLM-5.3-FLASH: 1M까지는 원래 sparse attention과 3점 이내였지만 2M–5M에서는 최대 8점 뒤졌고, 10M RULER에서는 4점 이내였습니다. 원래 sparse attention은 모델과 함께 학습됐고 D-LSA는 증류만 했다는 차이가 있습니다.
PaperTrail은 저자들이 만든 벤치마크입니다. 최신 과학 논문 묶음에 꾸며 낸 사실을 심어 두고, 논문 하나에서 셋 이상까지 사실을 이어 따라가야 답할 수 있게 했습니다.
5. 문맥이 길수록 더 빨라졌습니다
레이어 하나 기준 속도 향상은 다음과 같습니다.
| 모델(비교 대상) | 1M prefill | 10M prefill | 10M decode |
|---|---|---|---|
| GLM-5.3-FLASH (원래 sparse attention 대비) | 3.5배 | 22.7배 | 4.6배 |
| QWEN-3.8-27B (full attention 대비) | – | 72.4배 | 42.5배 |
512k 토큰에서는 블록을 다 훑어도 아직 싸서 향상이 2.1배에 그쳤습니다. 10M 이후로 외삽하면 Tree 검색이 Flat을 앞지르고, 100M 토큰에서는 원래 sparse attention보다 90배 이상 빠를 것으로 예측됩니다.
모델 전체로 보면 향상 폭이 작아집니다. 빨라지는 것은 global attention 레이어뿐이기 때문입니다. SGLang 서빙에서 GLM-5.3-FLASH 10M 토큰 요청은 첫 토큰까지 시간이 2.2배(CP8) 또는 5.8배(TP8) 줄었고, QWEN-3.8-27B는 9.2배 줄었습니다. 인덱스 메모리도 10M에서 레이어당 246MiB로, GLM-5.3-FLASH의 331MiB보다 작았습니다.
6. N-LSA는 full attention과 같은 loss에 도달했습니다
약 0.5B 크기의 하이브리드 모델(24개 레이어 중 4분의 1만 attention)로 실험했습니다. 128k 토큰 학습 구간에서 N-LSA의 검증 loss는 1.085로 full attention과 같았고, PISA 1.100, NSA 1.117, SWA 1.154보다 낮았습니다. RULER 128k에서는 32.2로 full attention(34.7)과 3.5점 이내였고, NSA 19.2, PISA 14.6, SWA 3.0보다 높았습니다.
속도는 128k에서 attention 레이어 하나가 full attention보다 1.6배, 64k에서 1.1배 빨랐고, 모델 전체 학습 구간은 1.24배 빨리 끝났습니다. 다만 더 짧은 문맥에서는 key를 고르는 비용이 아끼는 비용보다 컸습니다. 최대 메모리도 128k에서 레이어당 6.8GiB로 full attention의 5.8GiB보다 많았습니다.
7. 저자가 밝힌 한계
- LSA는 key를 찾는 비용을 줄일 뿐 KV cache를 저장하는 비용은 줄이지 않습니다. 저자들은 KV cache 압축, 레이어 간 인덱스 공유와 함께 쓸 수 있다고 봅니다.
- Tree 검색은 GLM-5.3-FLASH에서 1M 이후 정확도가 Flat보다 빠르게 떨어졌습니다(10M RULER 55.8 대 66.8). 증류 뒤 모델 전체를 sparse attention으로 더 학습하는 단계는 비용 때문에 생략했고, 이 단계가 격차를 줄일지는 열린 문제입니다.
- N-LSA는 약 0.5B 모델, 128k 토큰, Flat 검색에서만 학습했습니다. 더 큰 모델, 더 긴 문맥, Tree 검색은 다음 과제입니다.
8. 정리
LSA는 초장문맥 sparse attention에서 비싼 부분이 'key를 찾는 일'이라는 점을 짚고, 이를 비슷한 key의 묶음을 고르는 검색으로 바꿨습니다. D-LSA는 기존 모델에 짧은 증류로 붙여 10M 토큰까지 비슷한 정확도를 유지하며 attention 레이어를 크게 빠르게 했고, N-LSA는 처음부터 학습해도 full attention과 같은 loss에 도달했습니다.
References
Kubicek, A., Caciolai, A., Peng, L., Sumant, S., Hoover, B., Greenlee, F., Battleday, R. M., Urban, R., Hoefler, T., & Whittington, J. C. R. (2026). Latent sparse attention: Towards subquadratic ultra-long context attention (Version 1, arXiv:2610.42147) [Preprint]. arXiv. https://arxiv.org/abs/2610.42147v1