Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention
초장문맥 attention의 인덱서 비용을 어떻게 줄이는가? Latent Sparse Attention 논문 정리
초장문맥 sparse attention에서 비용의 대부분이 key를 찾는 인덱서에 있다는 점을 짚고, 비슷한 key를 묶어 묶음만 고르는 LSA를 설명합니다. 10M 토큰까지의 정확도와 속도 향상, 처음부터 학습하는 N-LSA, 저자가 밝힌 한계를 함께 봅니다.
Paper: Ales Kubicek; Andrea Caciolai; Liangzu Peng; Sukrit Sumant; Benjamin Hoover; Fraser Greenlee; Ruairidh M. Battleday; Radim Urban; Torsten Hoefler; James C. R. Whittington (2026). "Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention". arXiv preprint, arXiv:2610.42147v1, 2026-10-30. 원문 · PDF.
요약
| 항목 | 논문이 보고한 내용 |
|---|---|
| 문제 | 1M 토큰 이상의 초장문맥에서 sparse attention의 인덱서가 모든 key를 스캔하므로 비용이 여전히 이차적이다. 10M 토큰에서 인덱서가 sparse attention prefill 시간의 98%를 차지한다. |
| 방법 | key를 학습된 잠재 공간에서 계층적으로 클러스터링하고, query가 모든 key 대신 클러스터 centroid를 점수화해 상위 key를 선택한다. Flat 검색은 모든 bucket을 스캔하고, Tree 검색은 계층을 타고 내려가 O(\log T) centroid만 점수화한다. |
| 두 변형 | D-LSA는 사전학습된 모델에 증류로 추가하고, N-LSA는 NTP loss만으로 처음부터 학습한다. |
| D-LSA 헤드라인 | GLM-5.3-FLASH에서 10M 토큰 기준 한 attention 레이어의 prefill 22.7×, decode 4.6× 빠르고(baseline sparse attention 대비), QWEN-3.8-27B에서는 full attention 대비 72.4×, 42.5×다. 정확도는 유사하게 유지된다. |
| N-LSA 헤드라인 | 0.5B 하이브리드 모델에서 128k 토큰 기준 한 attention 레이어가 full attention보다 1.6× 빠르고, 검증 loss가 같다(1.085 대 1.085). |
| 저자 한계 | KV cache 저장 비용은 줄이지 않으며 직교적이다. Tree 검색은 1M 이후 GLM-5.3-FLASH에서 Flat보다 정확도가 빠르게 떨어졌다. N-LSA는 약 0.5B, 128k, Flat 검색에서만 평가했다. |
목차
- 초장문맥과 인덱서 병목
- Sparse attention의 설계 공간
- 의미 클러스터링과 검색
- D-LSA: 증류 기반 LSA
- N-LSA: 네이티브 학습
- 실험 설정
- D-LSA 정확도
- D-LSA 성능
- N-LSA 결과
- 저자 논의와 결론
1. 초장문맥과 인덱서 병목
1.1 문맥 창의 확대
최근 모델은 문맥 창을 1M 토큰 이상으로 확대하고 있다(Gemini, MiniMax, DeepSeek, Qwen). 에이전트 워크플로가 소프트웨어 공학이나 과학 연구 같은 장기 과제로 이동하면서, 더 긴 문맥이 점수를 높이는 경향이 관찰된다.
1.2 인덱서의 비용
Full attention은 prefill이 O(T^2), decode가 O(T)이다. Sparse attention은 인덱서가 query마다 상위 k개 key를 골라 attention 비용을 O(Tk)로 줄이지만, 인덱서 자체가 모든 key를 스캔하므로 여전히 O(T^2)이다. 10M 토큰에서 인덱서가 sparse attention prefill 시간의 98%를 차지하고, 인덱서가 '공짜'라면 sparse attention이 prefill에서 58×, decode에서 8.9× 더 빨라질 수 있다고 논문은 보고한다(Figure 2, p.2).
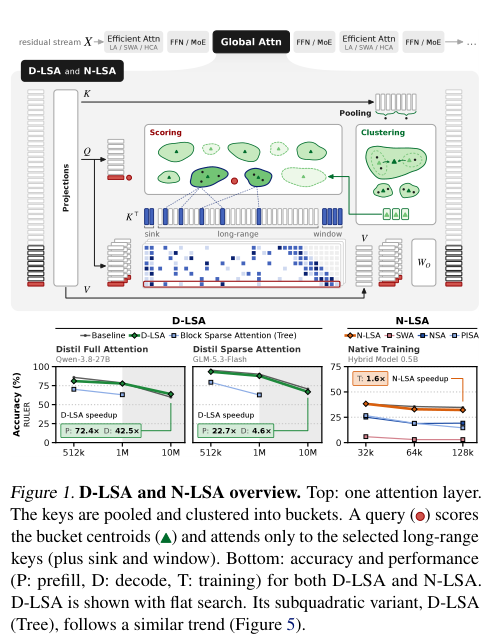
그림 1. D-LSA와 N-LSA 개요. 위: key를 pooling·클러스터링한 뒤 query가 bucket centroid를 점수화해 선택된 long-range key에만 attention한다. 아래: 두 변형의 정확도와 성능(P: prefill, D: decode, T: training). 출처: Kubicek, Caciolai, Peng et al. (2026), Latent Sparse Attention, arXiv:2610.42147v1, Figure 1, PDF p.1.
2. Sparse attention의 설계 공간
논문 Table 1(p.3)은 기존 sparse attention 방법을 인덱서가 점수화하는 단위(토큰, 블록, 클러스터)와 검색 방식(Flat, Fixed, Tree), 학습 방식(학습 불필요, 증류, 네이티브)으로 분류한다.
- Token sparse: 헤드 수·차원·정밀도를 줄인 경량 인덱서가 query마다 앞선 모든 key를 점수화한다(DSA; DeepSeek-AI, 2025).
- Block sparse: 연속 key를 블록으로 묶고 query가 블록을 점수화한다. NSA(Yuan et al., 2025)와 MoBA(Lu et al., 2025)는 sparse attention으로 처음부터 사전학습하고, QSA(Qwen Team, 2026)와 GLM-5.3-FLASH SA는 네 key를 하나로 압축한 뒤 점수화한다. 논문은 이런 개선이 인덱서 비용을 상수배로 나눌 뿐 query당 작업량은 여전히 문맥에 비례한다고 지적한다. PISA(Tang et al., 2026)는 블록 스캔을 트리로 바꾸지만 정확도는 16k 토큰까지만 평가했다.
- Semantic sparse: 위치가 아니라 유사도로 key를 클러스터링하고 query가 클러스터마다 centroid 하나를 점수화한다. LSA가 여기에 해당한다.
검색 방식에서 Flat은 모든 그룹을 직접 점수화(O(T)), Fixed는 고정 수준의 얕은 계층, Tree는 깊은 계층을 내려가며 O(\log T)으로 줄인다. LSA는 학습된 잠재 공간에서 Flat과 Tree 모두를 지원한다.
3. 의미 클러스터링과 검색
3.1 클러스터링 과정
- L2 정규화: 각 index key
k^{(\text{idx})}_j를 단위 벡터로 정규화한다. - Pooling:
n_\text{pool}개 연속 index key를 합산해 pool key를 만든다. 클러스터링은T / n_\text{pool}개 pool key에 대해 수행된다. - 클러스터링: cluster block(
n_\text{cluster}개 연속 key) 안에서 pool key를 Ward 방법(Ward, 1963)으로 bottom-up agglomerative clustering한다. 평균\bar{n}b개 key를 가진m = n\text{cluster} / \bar{n}_b개 bucket으로 합쳐지며, 한 bucket의 최대 key 수n^{\max}_b가 상한이다. - Bucket cache: 각 bucket의 centroid
c_b와 key 위치 인덱스 테이블을 저장한다. 한 번 클러스터링된 bucket은 변하지 않는다.
3.2 검색 과정
- Query 정규화와 점수화: index query
q^{(\text{idx})}i를 L2 정규화한 뒤 모든 bucket centroid와 내적s{i,b} = c_b \cdot q^{(\text{idx})}_i를 계산하고 상위p개 bucket을 선택한다. - 확장: 선택된 bucket을 best-first로 확장해
k개 long-range key를 채운다. 모든 query에n_\text{sink}개 sink key와n_w개 최근 key(window)도 항상 포함한다. - Attention: query별 인덱스 집합
J_i에 대해 FlashAttention-3(Shah et al., 2024) 등 기존 커널로 attention을 계산한다.J_i는 모든 query head에서 공유된다.
3.3 Tree 검색
Tree 변형은 bucket을 다단계 계층으로 구성한다. 각 상위 수준의 node bucket은 하위 수준의 bucket n_{b,\ell}개를 포함하며, 포함된 모든 key에 대한 centroid를 가진다. Beam search로 계층을 내려가 후보를 좁히므로 query당 O(\log T)개 centroid만 점수화한다. 이는 인덱서의 prefill을 O(T \log T)로 만든다.
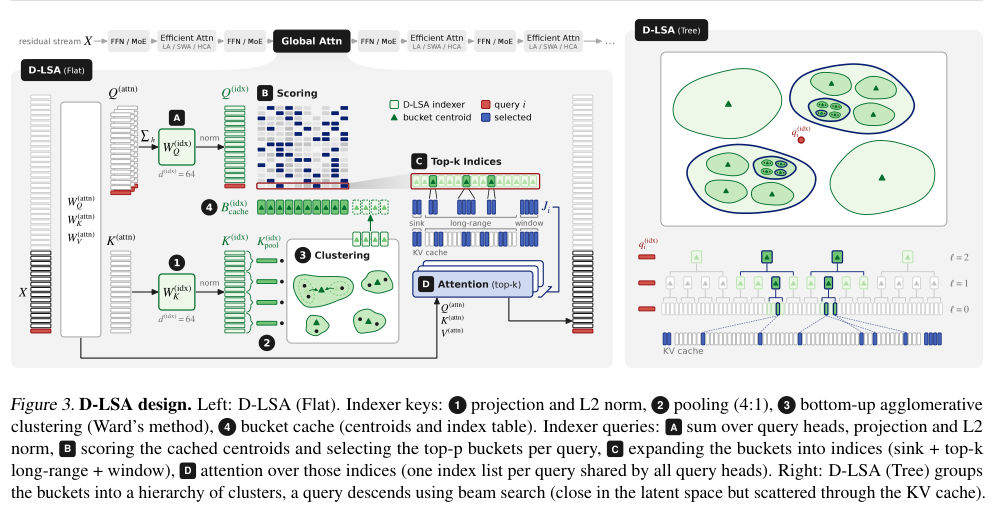
그림 2. D-LSA 설계. 왼쪽: D-LSA (Flat). 인덱서 key의 투영·정규화, pooling, 클러스터링, bucket cache와, 인덱서 query의 점수화·확장·attention. 오른쪽: D-LSA (Tree). 출처: Kubicek et al. (2026), Figure 3, PDF p.4.
4. D-LSA: 증류 기반 LSA
D-LSA는 사전학습된 모델의 attention에 LSA를 추가하고, 모델은 고정한 채 작은 투영 행렬 W^{(\text{idx})}_K, W^{(\text{idx})}_Q와 계층별 temperature \tau만 학습한다.
k^{(\text{idx})}_j = k^{(\text{attn})}_j W^{(\text{idx})}_K, \qquad q^{(\text{idx})}_i = \left(\sum_h q^{(\text{attn})}_{i,h}\right) W^{(\text{idx})}_QQuery head를 합산해 하나의 index query로 만들고, 인덱스 공간 차원 d^{(\text{idx})} = 64로 유지한다. QWEN-3.8-27B에서는 RoPE가 적용된 차원을 제외한 부분만 읽는다.
증류 손실은 고정 모델의 head-평균 attention 분포 A_i와 D-LSA 점수의 softmax \hat{A}_i 사이의 forward KL 발산이다.
\mathcal{L}_i = D_{\text{KL}}(A_i \| \hat{A}_i)증류는 7개 도메인의 16k–1M 토큰 문서에서 352M 토큰, 48k step으로 수행한다. DSA(DeepSeek-AI, 2025)의 2.1B 토큰 dense warm-up에 비하면 짧은 학습이다. 논문은 증류 이후 모델 전체를 sparse attention 아래에서 추가 학습하는 sparse training 단계를 지원하지만 비용 때문에 생략했다고 밝힌다.
D-LSA (Training-Free) 변형은 key의 principal direction을 투영 행렬 대신 사용해 학습 없이도 작동한다.
5. N-LSA: 네이티브 학습
N-LSA는 전용 인덱스 투영 없이 attention 자체의 key를 클러스터링한다. 단일 key-value head를 사용하고, bucket 점수는 query head 중 centroid와 가장 높은 유사도를 기록한 값이다.
s_{i,b} = \max_h \; \hat{q}_{i,h} \cdot c_bselection을 통한 gradient는 차단하고, NTP loss만으로 attention projection을 학습한다. 파라미터 추가, 교사 모델, 인덱스 투영, 보조 손실이 없다. N-LSA의 attention 레이어는 위치 인코딩을 사용하지 않는다.
6. 실험 설정
6.1 모델과 비교 대상
D-LSA는 QWEN-3.8-27B(full attention)과 GLM-5.3-FLASH(sparse attention)에서 평가한다. 비교 대상은 Full Attention, Block Sparse Attention(Flat과 Tree), D-LSA(Flat, Tree, Training-Free)이다. 학습된 모든 인덱서는 동일한 방식으로 증류해 공정성을 확보한다.
N-LSA는 약 0.5B 하이브리드 모델(24 레이어, 4분의 1이 attention, 나머지는 Gated DeltaNet; Yang et al., 2025)에서 Full Attention, SWA, NSA(Yuan et al., 2025), PISA(Tang et al., 2026)와 비교한다. 모든 sparse 방법은 query당 약 2,560개 key에 attend한다.
6.2 벤치마크
- 지식: MMLU-Pro(2,000문항 층화 표본), GPQA-Diamond.
- 추론: AIME25(4회 반복), MATH500(100문제).
- 장문맥: LongBench v2(Bai et al., 2025; 60문항), RULER(Hsieh et al., 2024) 13개 task(4k–10M 토큰; 1M까지 task당 100개, 그 이상 20개).
- PaperTrail: 논문이 개발한 장문맥 과학적 이해 벤치마크. 최근 과학 논문 모음에 가공된 사실을 심어 놓고, 사실의 경로를 따라 연결해야 답할 수 있다. 3개 도메인(외계행성, 장문맥 ML, 양자 오류 정정), 3단계 난이도(단일 논문, 두 논문 연결, 세 논문 이상 추적).
6.3 하드웨어와 서빙
SGLang에 통합해 H200과 B300 GPU에서 서빙한다. Tensor parallelism(TP8)과 context parallelism(CP8, prefill·decode 모두)을 지원한다. QWEN-3.8-27B는 YaRN 확장(Peng et al., 2024; factor 40)으로 10M에 도달하고, GLM-5.3-FLASH는 명시적 위치 인코딩이 없어 확장이 필요 없다.
7. D-LSA 정확도
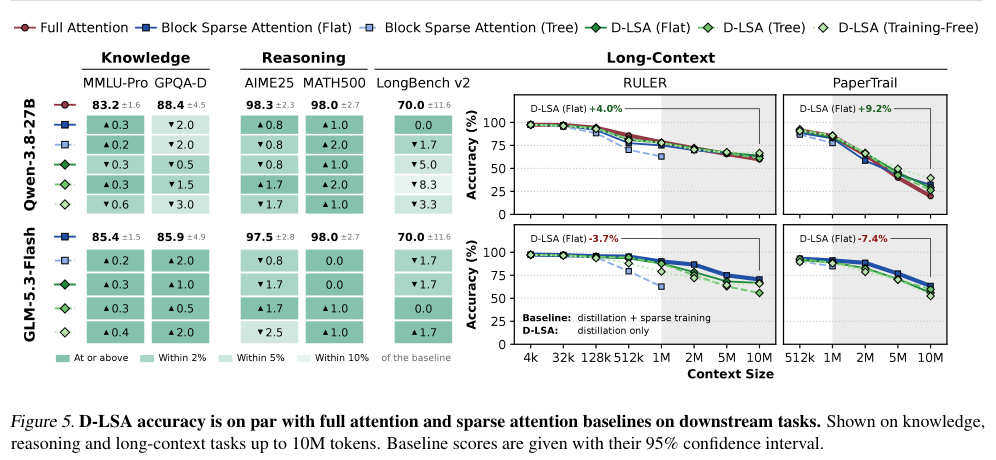
그림 3. D-LSA는 지식·추론·장문맥 과제에서 baseline과 유사한 정확도를 보인다. 10M 토큰까지의 결과. Baseline 점수에는 95% 신뢰구간이 표시된다. 출처: Kubicek et al. (2026), Figure 5, PDF p.8.
7.1 지식과 추론
MMLU-Pro, GPQA-Diamond, AIME25, MATH500, LongBench v2에서 D-LSA는 두 모델 모두의 baseline 95% 신뢰구간 안에 있다. 추론이 수만 토큰으로 길어져도 마찬가지이며, D-LSA가 추론 길이를 측정 가능하게 바꾸지 않는다고 보고한다.
7.2 장문맥
QWEN-3.8-27B에서 D-LSA (Flat)는 1M 토큰까지 full attention과 5점 이내를 유지하고, 10M 토큰에서는 오히려 앞선다. RULER 63.9 대 59.9, PaperTrail 29.1 대 19.8이다. Block Sparse Attention (Flat)과의 공정 비교(둘 다 같은 방식으로 증류)에서도 128k부터 D-LSA가 앞선다.
GLM-5.3-FLASH에서 D-LSA (Flat)는 1M까지 baseline sparse attention과 3점 이내이고, 2M–5M에서 최대 8점 뒤지며, 10M RULER에서 4점 이내다. 이 비교는 baseline이 모델과 함께 학습된 반면 D-LSA는 이미 sparse한 attention에서 증류만 했기 때문에 baseline이 유리하다고 논문은 설명한다.
7.3 설계 비교
D-LSA (Tree)는 QWEN-3.8-27B에서 Flat과 유사하지만, GLM-5.3-FLASH에서 1M 이후 정확도가 빠르게 떨어져 10M RULER에서 55.8 대 66.8이다. Block Sparse Attention (Tree)는 512k부터 크게 떨어져 1M RULER에서 약 63이다. D-LSA (Training-Free)는 QWEN-3.8-27B에서 Flat에 근접하지만 GLM-5.3-FLASH에서 뒤처진다.
8. D-LSA 성능
8.1 레이어 단위
Figure 6(p.9)에서 D-LSA의 prefill 속도 향상은 문맥 길이에 따라 커진다. GLM-5.3-FLASH에서 1M에서 3.5×, 10M에서 22.7×(baseline sparse attention 대비)이고, QWEN-3.8-27B에서 10M에서 72.4×(full attention 대비)이다. Decode는 10M에서 각각 4.6×와 42.5×다. 10M 이후로 외삽하면 D-LSA (Tree)의 prefill은 준이차적으로 늘어 Flat을 넘어서고, 100M 토큰에서는 baseline sparse attention보다 90× 이상 빠를 것으로 예측된다. 512k에서는 블록 스캔이 아직 싸서 향상이 2.1×로 작다.
8.2 종단간 (Table 3)
SGLang에서 한 요청의 time to first token(TTFT)과 time per output token(TPOT)을 보고한다. GLM-5.3-FLASH 10M에서 D-LSA (Flat)는 CP8 기준 TTFT 2.2×, TPOT 2.1×, TP8 기준 TTFT 5.8×, TPOT 1.9× 빠르다. QWEN-3.8-27B 10M에서는 TTFT 9.2×, TPOT 2.9×다. 모델 전체의 속도 향상은 레이어 단위보다 작은데, global attention 레이어만 빨라지고 나머지 레이어는 비용이 그대로이기 때문이다.
8.3 메모리
D-LSA의 인덱스는 10M에서 레이어당 246 MiB로, GLM-5.3-FLASH의 331 MiB, QSA의 642 MiB보다 작다. D-LSA는 약 8개 key당 하나의 centroid를 작은 인덱스 공간에 저장하기 때문이다.
9. N-LSA 결과
9.1 검증 loss
Figure 7(p.9)에서 N-LSA는 128k 토큰 decay phase 전체에서 full attention과 같은 검증 loss(1.085 대 1.085)를 보인다. PISA(1.100), NSA(1.117), SWA(1.154)는 뒤처진다. 4k 사전학습에서는 모든 방법이 서로 0.004 이내다.
9.2 Downstream 정확도 (Table 4)
Commonsense reasoning(ARC-e, ARC-c, HellaSwag)에서 모든 모델이 유사하다. Recall(SWDE, FDA)에서 N-LSA는 full attention에 근접하고 다른 sparse 방법보다 앞선다. RULER에서 N-LSA는 128k에서 full attention과 3.5점 이내(32.2 대 34.7)이고, NSA와 PISA는 19.2와 14.6으로 떨어지며, SWA는 3.0이다.
9.3 학습 속도
한 attention 레이어의 forward+backward는 64k에서 full attention(FlashAttention-3) 대비 1.1× 빠르고, 128k에서 1.6× 빠르다. 모델 전체로는 decay phase를 1.24× 빠르게 완료한다(attention이 4분의 1 레이어이므로). 짧은 문맥에서는 key 선택 비용이 절약분보다 크다. Peak memory는 128k에서 레이어당 6.8 GiB 대 5.8 GiB로 N-LSA가 더 높다. 이는 backward를 위해 선택된 key의 인덱스를 유지하기 때문이다.
10. 저자 논의와 결론
10.1 §5 Discussion
저자들은 다음의 한계를 밝힌다.
- LSA는 key를 찾는 비용을 줄이지만 KV cache 저장 비용은 줄이지 않는다. KV cache 압축, 레이어 간 인덱스 공유, multi-token prediction과는 직교적이며 조합할 수 있다.
- Tree 검색은 GLM-5.3-FLASH에서 1M 이후 Flat보다 정확도가 빠르게 떨어졌다. Sparse training이 이 격차를 줄일 수 있는지는 열린 문제다.
- N-LSA는 약 0.5B 파라미터, 128k 토큰, Flat 검색에서만 학습했다. 더 큰 모델, 더 긴 문맥, Tree 검색으로의 네이티브 학습 확장은 미래 과제다.
10.2 결론
초장문맥에서 sparse attention의 비용은 key를 찾는 데 있다. LSA는 key를 학습된 잠재 공간에서 클러스터링하고 모든 key의 스캔을 클러스터 검색으로 대체한다. D-LSA는 사전학습 모델에 증류로 추가되어 10M 토큰까지 baseline과 유사한 정확도를 유지하면서 한 레이어의 prefill을 22.7×(72.4×), decode를 4.6×(42.5×) 빠르게 한다. 종단간으로는 TTFT를 2.2×(9.2×) 줄인다. N-LSA는 NTP loss만으로 full attention의 정확도에 도달하며 128k에서 레이어당 1.6× 빠르다. Tree 검색은 key 탐색 비용을 준이차적으로 만들어 10M 이상으로의 확장 가능성을 제시한다.
References
Bai, Y., Tu, S., Zhang, J., Peng, H., Wang, X., Lv, X., Cao, S., Xu, J., Hou, L., Dong, Y., Tang, J., & Li, J. (2025). LongBench v2: Towards deeper understanding and reasoning on realistic long-context multitasks. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics.
DeepSeek-AI. (2025). DeepSeek-V3.2: Pushing the frontier of open large language models [Preprint]. arXiv. https://arxiv.org/abs/2512.02556
Hsieh, C.-P., Sun, S., Kriman, S., Acharya, S., Rekesh, D., Jia, F., Zhang, Y., & Ginsburg, B. (2024). RULER: What's the real context size of your long-context language models? First Conference on Language Modeling.
Kubicek, A., Caciolai, A., Peng, L., Sumant, S., Hoover, B., Greenlee, F., Battleday, R. M., Urban, R., Hoefler, T., & Whittington, J. C. R. (2026). Latent sparse attention: Towards subquadratic ultra-long context attention (Version 1, arXiv:2610.42147) [Preprint]. arXiv. https://arxiv.org/abs/2610.42147v1
Lu, E., Jiang, Z., Liu, J., Du, Y., Jiang, T., Hong, C., Liu, S., He, W., Yuan, E., Wang, Y., Huang, Z., Yuan, H., Xu, S., Xu, X., Lai, G., Chen, Y., Zheng, H., Yan, J., Su, J., … Qiu, J. (2025). MoBA: Mixture of block attention for long-context LLMs. Advances in Neural Information Processing Systems, 38, 20267–20292.
Peng, B., Quesnelle, J., Fan, H., & Shippole, E. (2024). YaRN: Efficient context window extension of large language models. The Twelfth International Conference on Learning Representations.
Qwen Team. (2026). On the design of Qwen3.8-Next architecture: Evaluation, efficiency, and training stability [Preprint]. arXiv. https://arxiv.org/abs/2608.30320
Shah, J., Bikshandi, G., Zhang, Y., Thakkar, V., Ramani, P., & Dao, T. (2024). FlashAttention-3: Fast and accurate attention with asynchrony and low-precision. Advances in Neural Information Processing Systems, 37, 68658–68685.
Tang, B., Qin, Z., Pan, Y., Li, Z., & Liu, P. (2026). Block sparse attention with log-linear complexity [Preprint]. arXiv. https://arxiv.org/abs/2609.31093
Ward, J. H., Jr. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845
Yang, S., Kautz, J., & Hatamizadeh, A. (2025). Gated delta networks: Improving Mamba2 with delta rule. The Thirteenth International Conference on Learning Representations.
Yuan, J., Gao, H., Dai, D., Luo, J., Zhao, L., Zhang, Z., Xie, Z., Wei, Y., Wang, L., Xiao, Z., Wang, Y., Ruan, C., Zhang, M., Liang, W., & Zeng, W. (2025). Native sparse attention: Hardware-aligned and natively trainable sparse attention. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 23078–23097.
Keywords: Latent Sparse Attention, LSA, D-LSA, N-LSA, hierarchical clustering, subquadratic attention, ultra-long context, sparse attention, PaperTrail Author: PaperWiki Last Updated: 2026-11-03