Multi-Token Prediction Done Right
MTP의 cross-entropy gradient에서 자기 증류 신호를 어떻게 꺼내는가?
표준 MTP의 학습 신호를 자기 증류 항과 잡음 많은 잔차로 나누고, 코드 한 줄로 잔차만 빼는 Soft-MTP를 설명합니다. 167M–1.2B 사전학습에서 표준 MTP보다 나아진 점과 KL-MTP와의 비용 차이, 저자가 밝힌 한계를 함께 봅니다.
Paper: Jayden Teoh (2026). "Multi-Token Prediction Done Right". arXiv preprint, arXiv:2610.38331v1, 2026-10-28. 원문 · PDF.
요약
| 항목 | 논문이 보고한 내용 |
|---|---|
| 문제 | 표준 MTP cross-entropy gradient에는 MTP head를 NTP 분포 쪽으로 끌어당기는 KL 자기 증류 항과, 신호 대 잡음비(SNR)가 낮은 잔차 항이 함께 들어 있다. 잔차는 MTP gradient의 약 80%를 차지하면서 NTP·MTP 학습을 모두 방해하고 스케일이 커질수록 악화된다. |
| 방법 | KL gradient-recovery trick으로 두 분포가 선형 output head를 공유할 때 straight-through gradient routing만으로 KL 발산의 gradient를 정확히 복원한다. 이를 MTP에 적용한 것이 Soft-MTP이며, 한 줄의 코드 변경이다. |
| 헤드라인 | 167M–1.2B에서 Soft-MTP는 표준 MTP보다 낮은 NTP 퍼플렉서티, 빠른 speculative decoding, 높은 zero-shot 정확도를 모든 스케일에서 달성한다. 689M부터 MTP 퍼플렉서티도 낮추고, 1.2B fine-tuning에서 수학·코드 추론이 더 강하다. |
| 효율 | 파라미터 추가 없음, 측정 가능한 오버헤드 없음, fused cross-entropy 커널 호환. KL-MTP 대비 throughput과 메모리 모두 유리하다. |
| 저자 한계 | MTP의 장기적 존속은 불확실하며 DeepSeek-V4.1-Flash는 MTP를 버리고 DSpark를 채택했다. KL gradient-recovery trick의 적용 범위는 output head를 공유하는 teacher-student 쌍이다. |
목차
- 배경과 문제 설정
- MTP gradient의 분해
- KL gradient-recovery trick과 Soft-MTP
- 실험 설정
- 잔차가 학습을 방해하는 증거
- Speculative decoding과 downstream 성능
- Soft-MTP와 KL-MTP 비교
- MTP 가중치와 예측 범위 탐색
- 프론티어 규모에서의 호환성
- 저자 논의와 결론
1. 배경과 문제 설정
1.1 MTP의 위치
Next-token prediction(NTP)은 LLM 사전학습의 표준이지만, Multi-Token Prediction(MTP)이 DeepSeek-V3/V4, Nemotron 3, GLM-5, Kimi K3 등 프론티어 모델에 널리 채택되었다. MTP는 (1) NTP의 근시안적 감독을 보완해(Bachmann & Nagarajan, 2024; Gloeckle et al., 2024) downstream 성능을 올리고, (2) speculative decoding의 drafter로 쓸 수 있어 추론을 가속한다.
1.2 표준 MTP의 한계
MTP head는 보통 data에 대한 cross-entropy로 학습하지만, speculative decoding에서 MTP 토큰은 모델 자신의 NTP 분포와 일치해야 수용된다. 이 분포를 직접 teacher로 쓰는 KL 자기 증류는 vocabulary 크기의 logit 텐서를 양쪽 모두 생성해야 하므로 메모리가 비싸고 fused cross-entropy 커널과 호환되지 않는다. 이 논문은 표준 MTP cross-entropy gradient 안에 이미 그 자기 증류 신호가 들어 있음을 보이고, 잔차를 없애는 방법을 제안한다.
2. MTP gradient의 분해
2.1 표기법
입력 토큰 열 x_{1:T}, vocabulary 크기 V, 공유 trunk이 만드는 NTP hidden state h^{(0)}t, 공유 output head W\theta에서 NTP 분포는 p^{(0)}t = \operatorname{softmax}(W\theta h^{(0)}_t)이다. k번째 MTP head의 hidden state h^{(k)}_t에서 MTP 분포는 p^{(k)}t = \operatorname{softmax}(W\theta h^{(k)}t)이며 x{t+k+1}을 예측한다. 같은 토큰을 예측하는 NTP 분포를 position-aligned NTP 분포라 하고 q^{(k)}t := p^{(0)}{t+k}로 쓴다.
2.2 정확한 분해
h^{(k)}_t에 대한 표준 MTP(hard MTP) gradient는 다음과 같다.
g_{\mathrm{hard}} = W_\theta^\top \!\left(p^{(k)}_t - x_{t+k+1}\right)이것은 다음처럼 두 항으로 정확히 나뉜다.
g_{\mathrm{hard}} = \underbrace{W_\theta^\top \!\left(p^{(k)}_t - q^{(k)}_t\right)}_{g_{\mathrm{KL}}} + \underbrace{W_\theta^\top \!\left(q^{(k)}_t - x_{t+k+1}\right)}_{g_{\mathrm{res}}}g_{\mathrm{KL}}은 MTP 분포를 NTP 분포 쪽으로 끌어당기는 KL 자기 증류 gradient이고, g_{\mathrm{res}}는 aligned NTP hidden state에 대한 cross-entropy gradient에 해당하는 잔차다. 논문은 g_{\mathrm{KL}}이 D_{\mathrm{KL}}(\operatorname{sg}(q^{(k)}_t) | p^{(k)}_t)의 gradient와 같음을 보인다(§4.1).
3. KL gradient-recovery trick과 Soft-MTP
3.1 Trick의 핵심
두 분포가 같은 선형 output head를 공유하면, 각 분포의 cross-entropy gradient를 결합해 KL 발산의 gradient를 logit 텐서를 생성하지 않고 정확히 복원할 수 있다. 구현은 straight-through gradient routing으로, NTP hidden state의 값은 바꾸지 않으면서 MTP hidden state에서 오는 gradient를 NTP 경로로 보낸다(Figure 1의 코드 한 줄 h0[:, k:] += hk.detach() - hk).
3.2 결과: Soft-MTP
Soft-MTP는 잔차 g_{\mathrm{res}}를 제거하고 KL 자기 증류 gradient g_{\mathrm{KL}}만 역전파한다. 기존 NTP와 MTP cross-entropy 계산을 재사용하며, 파라미터 추가가 없고 fused cross-entropy 커널과 호환된다. DeepSeek 방식(순차 MTP 모듈; DeepSeek-AI, 2024)과 Meta 방식(병렬 output head; Gloeckle et al., 2024) 모두 지원한다.
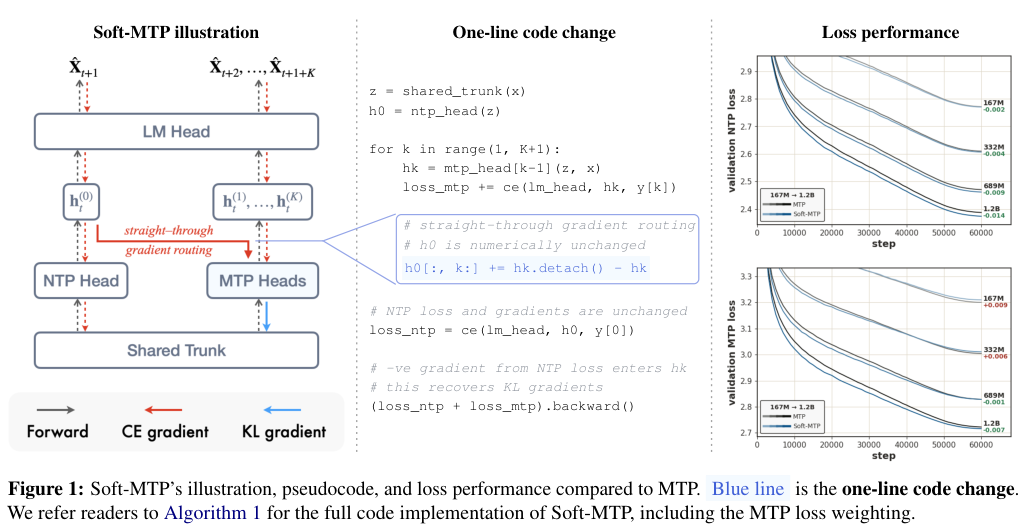
그림 1. Soft-MTP의 구조, 한 줄 코드 변경, 그리고 MTP 대비 loss 곡선. 출처: Teoh (2026), Multi-Token Prediction Done Right, arXiv:2610.38331v1, Figure 1, PDF p.1.
4. 실험 설정
논문은 167M–1.2B LLaMA-style 모델을 NTP, MTP, Soft-MTP로 사전학습한다. DeepSeek 방식 순차 MTP 아키텍처에 K=3 head를 사용하고, 각 head의 파라미터는 trunk의 비임베딩 파라미터의 3.2%로 고정한다. MTP 손실 계수 \lambda_{\mathrm{MTP}} = 1.0이다. FineWeb-Edu 데이터셋에서 60,000 step, 배치 크기 0.5M 토큰, 시퀀스 길이 2,048으로 약 31.5B 토큰을 학습한다. 이는 가장 큰 모델 기준 Chinchilla-optimal의 약 1.3배다. Optimizer는 Muon(update-RMS rescaling 적용)이다.
KL-MTP는 명시적 KL 발산을 최소화하는 대조군이다. Speculative decoding 평가에서는 Leviathan et al. (2023)의 speculative sampling 알고리즘으로 K=3 MTP head가 draft하고 자기 자신의 NTP head로 검증한다.
5. 잔차가 학습을 방해하는 증거
5.1 Signal-to-noise ratio
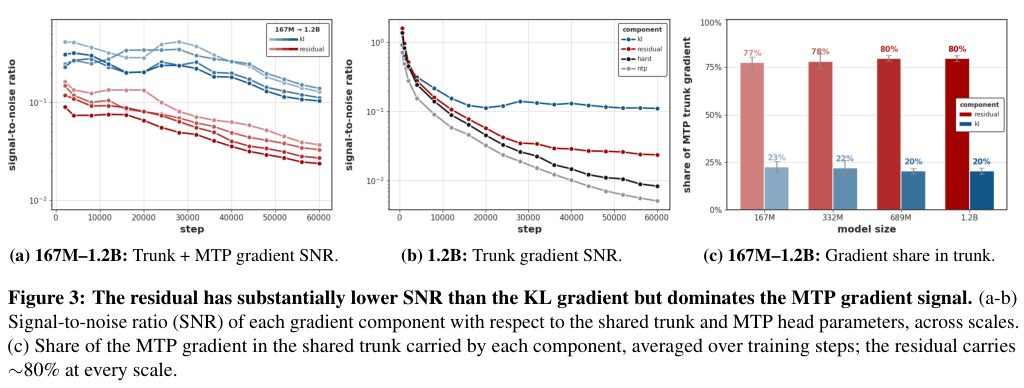
그림 2. (a–b) KL 성분과 잔차 성분의 SNR. 잔차는 KL 성분보다 약 4배 낮은 SNR을 가지며 스케일이 커질수록 격차가 벌어진다. (c) Trunk에 도달하는 MTP gradient 중 각 성분의 비율. 잔차가 약 80%를 차지한다. 출처: Teoh (2026), Figure 3, PDF p.7.
논문은 256개 독립 배치에서 gradient component별 신호(기대 방향의 제곱 노름)와 잡음(총 분산)을 추정한다. 학습 전 과정에서 잔차는 KL 성분보다 약 4배 낮은 SNR을 보이며, 167M의 4.1배에서 1.2B의 4.6배로 격차가 커진다. 그럼에도 잔차는 trunk에 도달하는 MTP gradient의 약 80%를 차지한다.
5.2 NTP와 MTP loss에 대한 영향
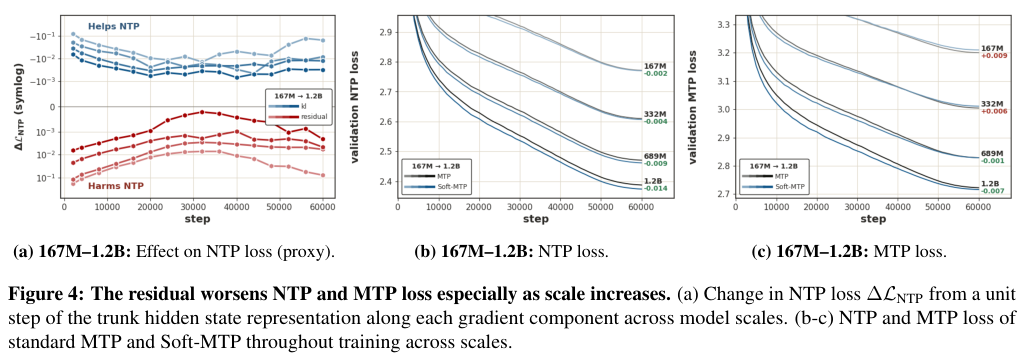
그림 3. (a) 각 gradient 성분 방향으로 단위 step을 내딛었을 때 NTP loss의 변화. KL 성분은 NTP loss를 일관되게 줄이고 잔차는 일관되게 올린다. (b–c) 학습 중 NTP·MTP loss 비교. 출처: Teoh (2026), Figure 4, PDF p.8.
KL gradient 방향의 step은 NTP loss를 일관되게 줄이고, 잔차 방향의 step은 일관되게 올린다. 이 패턴은 학습 전 과정과 모든 스케일에서 유지된다. 결과적으로 잔차를 제거한 Soft-MTP는 NTP loss를 낮추고, 689M부터는 MTP loss도 표준 MTP보다 낮다.
6. Speculative decoding과 downstream 성능
6.1 Speculative decoding (Table 2)
Table 2(p.9)에서 Soft-MTP는 모든 스케일과 모든 도메인(FineWeb-Edu, Wikipedia, Books, Science, Math)에서 표준 MTP보다 높은 acceptance length와 빠른 speedup을 보인다. 다섯 도메인 평균으로 acceptance length 개선은 스케일별 1.8–2.2%, speedup 개선은 1.4–1.5%다. MTP 분포와 NTP 검증자 사이의 KL 발산과 TV 거리도 모든 스케일에서 Soft-MTP가 낮다.
6.2 Zero-shot 성능 (Table 3)
Table 3(p.9)에서 Soft-MTP는 모든 스케일에서 평균 zero-shot 정확도가 표준 MTP보다 높다. 개선 폭은 167M과 332M에서 약 0.1점, 689M과 1.2B에서 약 0.5점이다. 1.2B에서 Soft-MTP는 NTP baseline도 넘는 최고 WikiText·LAMBADA 퍼플렉서티와 최고 평균 정확도(57.31)를 달성한다. 표준 MTP는 작은 스케일에서 NTP 대비 zero-shot 정확도를 올리지 못하는데, 이는 Gloeckle et al. (2024)의 관찰과 일치한다.
6.3 수학과 코드 fine-tuning (Table 4)
Table 4(p.10)에서 1.2B 모델을 MTP head 없이 NTP loss로만 fine-tune한 결과, Soft-MTP가 8개 셀 중 7개에서 표준 MTP를 앞서고 NTP baseline 아래로 떨어지지 않는 유일한 목적함수다. HumanEval pass@64에서 +3.1점, MBPP pass@64에서 +1.2점, GSM8K에서 +1.1점, MATH-500에서 +1.8점이다.
7. Soft-MTP와 KL-MTP 비교
7.1 효율 (Table 5)
Table 5(p.11)에서 1.2B, K=3 기준으로 Soft-MTP는 표준 MTP와 같은 matmul FLOPs, MFU, fused-CE peak memory를 가지며 throughput 차이는 0.07% 이내다. KL-MTP는 모든 축에서 가장 비싸다: FLOPs +1.5%, throughput −5.6%, peak memory +21 GB. KL-MTP는 vocabulary 크기의 teacher·student 분포를 생성해야 하므로 fused cross-entropy 커널의 이점도 거의 받지 못한다.
7.2 성능 비교 (Table 6)
Table 6(p.11)에서 1.2B 기준으로 Soft-MTP는 모든 퍼플렉서티 지표에서 KL-MTP와 동률이거나 앞서고, 평균 zero-shot 정확도(57.31 vs 57.22)도 높다. 코드 fine-tuning 6개 지표 모두 Soft-MTP가 앞선다. 수학 fine-tuning에서는 KL-MTP가 GSM8K +0.68, MATH-500 +1.00으로 앞선다. Speculative decoding에서 두 방법은 거의 같으며 KL-MTP가 FineWeb-Edu에서 최대 0.01 차이로 앞선다.
7.3 왜 output head에서 cross-entropy를 유지하는가
공유 output head W_\theta는 NTP와 MTP 모두의 logit을 매핑한다. KL-MTP 아래에서는 MTP loss의 gradient가 자기 증류 gradient이므로, W_\theta가 MTP와 NTP hidden state의 차이에 덜 민감해지는 shortcut으로 KL을 줄일 수 있다. Soft-MTP는 output head에서 cross-entropy를 유지해 이 shortcut을 방지한다. Figure 6(p.12)에서 logit map의 effective rank를 비교하면 NTP baseline 496, Soft-MTP 437, KL-MTP 321, 표준 MTP 131이다.
8. MTP 가중치와 예측 범위 탐색
Figure 5(p.10)에서 332M 모델로 \lambda_{\mathrm{MTP}} \in {0.25, 0.5, 0.75, 1.0}과 K \in {3,4,5,6,7,8}을 탐색한다. 모든 \lambda_{\mathrm{MTP}}에서 Soft-MTP는 NTP loss와 MTP loss 모두 표준 MTP보다 낮아 Pareto front를 지배한다. NTP loss 대 KL 발산 평면에서도 마찬가지다. 예측 범위 K를 3에서 8까지 바꿔도 모든 K에서 Soft-MTP가 표준 MTP보다 NTP·MTP loss 모두 낮다.
9. 프론티어 규모에서의 호환성
9.1 병렬성
KL gradient-recovery trick은 NTP hidden state h^{(0)}_{t+k}와 MTP hidden state h^{(k)}t가 같은 장치에 있고 \mathcal{L}{\mathrm{NTP}}에서 h^{(k)}_t로의 역전파 경로가 존재하면 된다. Data parallelism, ZeRO, expert parallelism은 그대로 적용된다. Pipeline parallelism에서는 MTP 모듈이 output head와 같은 stage에 있어야 하며, DeepSeek-V3는 이미 이 구조를 사용한다. Sequence sharding(context parallelism, ring attention, sequence parallelism)에서는 shard 경계마다 최대 K개 hidden-state gradient를 교환해야 하지만, 시퀀스 길이와 무관한 비용이다.
9.2 명시적 자기 증류 대비
명시적 KL은 teacher·student의 vocabulary 크기 분포를 동시에 필요로 해 fused cross-entropy 커널이 logit을 생성하지 않고는 계산할 수 없다. Tensor parallelism 없이 학습하는 DeepSeek-V3 같은 모델에서는 이 텐서를 vocabulary 축으로 분할할 수 없어 비용이 크다. KL gradient-recovery trick은 KL gradient를 logit이 아닌 hidden state를 통해 전달하므로 각 head가 표준 fused cross-entropy를 그대로 쓸 수 있다.
10. 저자 논의와 결론
10.1 MTP의 미래와 trick의 확장
논문 §7에서 저자는 MTP의 장기적 채택이 불확실하다고 쓴다. DeepSeek-V4.1-Flash는 MTP를 버리고 사후 학습 speculative decoder인 DSpark을 채택했다. Medusa, EAGLE, DFlash, DSpark 같은 사후 학습 drafter는 편리하지만, base model이 MTP로 예측적 표현을 형성한 적 없을 때 얼마나 잘 작동하는지는 열려 있다. MTP는 NTP 대비 downstream 정확도 향상과 소규모·데이터 제한 학습에서의 이점 때문에 유지될 수 있다.
KL gradient-recovery trick은 teacher와 student가 선형 output head를 공유하는 모든 설정에 적용된다. MTP Boosting, on-policy self-distillation(OPSD), off-policy RL의 score centering 등이 예다. 다만 MTP head와 공유 trunk만 정확한 KL gradient를 받고, 공유 output head W_\theta는 cross-entropy로 갱신된다는 제약이 있다. 이는 이미 output head를 동결하는 방법(Next-Latent Prediction; Teoh et al., 2025 등)에 적합하다.
10.2 결론
표준 MTP cross-entropy gradient는 KL 자기 증류 항과 잔차로 정확히 분해된다. 잔차는 MTP gradient의 대부분을 차지하지만 SNR이 낮고 NTP 학습을 방해하며 스케일이 커질수록 악화된다. KL gradient-recovery trick은 표준 MTP가 이미 계산하는 cross-entropy gradient에서 이 잔차를 제거하고 KL 항을 정확히 복원한다. 결과물인 Soft-MTP는 파라미터 추가 없이, 측정 가능한 오버헤드 없이, NTP·MTP loss, speculative decoding, zero-shot 정확도, 수학·코드 추론 모두에서 표준 MTP를 개선한다.
References
Bachmann, G., & Nagarajan, V. (2024). The pitfalls of next-token prediction. Proceedings of the 41st International Conference on Machine Learning, 235, 2296–2318. PMLR.
DeepSeek-AI. (2024). DeepSeek-V3 technical report [Preprint]. arXiv. https://arxiv.org/abs/2412.19437
Gloeckle, F., Idrissi, B. Y., Rozière, B., Lopez-Paz, D., & Synnaeve, G. (2024). Better & faster large language models via multi-token prediction. Proceedings of the 41st International Conference on Machine Learning.
Leviathan, Y., Kalman, M., & Matias, Y. (2023). Fast inference from transformers via speculative decoding [Preprint]. arXiv. https://arxiv.org/abs/2211.17192
Teoh, J. (2026). Multi-token prediction done right (Version 1, arXiv:2610.38331) [Preprint]. arXiv. https://arxiv.org/abs/2610.38331v1
Teoh, J., Tomar, M., Ahn, K., Hu, E. S., Pearce, T., Sharma, P., Krishnamurthy, A., Islam, R., Lamb, A., & Langford, J. (2025). Next-latent prediction transformers learn compact world models [Preprint]. arXiv. https://arxiv.org/abs/2511.05963
Keywords: Soft-MTP, multi-token prediction, KL gradient-recovery trick, self-distillation, speculative decoding, fused cross-entropy Author: PaperWiki Last Updated: 2026-11-01