CONDA: A Connectivity-Aware Dynamic Index for Approximate Nearest Neighbor Search over Evolving Data
갱신되는 벡터 검색 그래프의 연결성: CONDA
CONDA는 갱신이 이어지는 벡터 검색 그래프에서 연결 경로를 유지하는 방법을 제안합니다. CRNG의 후보 안 두 홉 경로 확인, 역방향 연결 보강, 지연 삭제와 여러 동적 workload의 검색·갱신 결과를 소개합니다.
Paper: Darae Lee; Min-Soo Kim (2026). "CONDA: A Connectivity-Aware Dynamic Index for Approximate Nearest Neighbor Search over Evolving Data". Proceedings of the VLDB Endowment, 19(11), 3357–3370. PDF · DOI
CONDA는 Python 환경 관리 도구가 아니라, 계속 바뀌는 데이터에서 approximate nearest neighbor search(ANN)를 위한 그래프 인덱스입니다. ANN은 모든 벡터를 비교하는 대신 일부 후보를 찾아 가까운 항목을 근사적으로 검색합니다. 그래프 인덱스에서는 벡터를 노드로, 이동할 수 있는 이웃 관계를 간선으로 저장합니다. 데이터가 삽입되고 삭제되면 기존 간선의 일부가 새 데이터에서 멀어지거나 삭제된 노드를 가리킬 수 있습니다. CONDA는 실제 간선 경로를 고려하는 가지치기, 삽입 중 역방향 후보 확장, 검색 중 오래된 간선을 정리하는 삭제 절차를 결합합니다.
H+ Embedding은 벡터 표현을, Hierarchical BM25는 어휘 검색에서 방문할 범위를 다룹니다. CONDA 논문은 동적 갱신 때 벡터 그래프의 연결을 유지하는 방법을 다룹니다.
목차
- 연결성 지표와 탐색
- CRNG의 세 가지 가지치기 경우
- 삽입과 역방향 후보 확장
- 삭제와 검색 중 간선 정리
- 데이터·workload·측정 조건
- 검색, 갱신, 동시 실행 결과
- 구성요소별 절제 실험
- 저자가 밝힌 한계
1. 연결성 지표와 탐색
그래프의 노드 p에서 나가는 간선 수를 out-degree, 다른 노드에서 p로 들어오는 간선 수를 in-degree라고 합니다. CONDA는 각 노드의 out-degree를 R 이하로 유지합니다. 이 제한 안에서 검색 후보를 연결하는 경로를 고르는 것이 삽입 단계의 핵심입니다.
논문은 p의 실제 최근접 이웃 R개를 \mathrm{NN}_R(p)로 두고 국소 연결성 coverage를 다음과 같이 정의합니다.
C_h(p)=\frac{1}{R}\left|\{u\in\mathrm{NN}_R(p):\operatorname{hop}_G(p,u)\le h\}\right|.즉 실제 최근접 이웃 R개 가운데 그래프에서 h홉 이내에 닿는 비율입니다. h=2이면 직접 간선이나 중간 노드 하나를 거치는 경로를 셉니다. 논문은 이 coverage와 self-query 검색 결과를 함께 측정합니다.
관련 지표 세 가지는 서로 다른 조건을 셉니다.
- IS (isolated nodes): in-degree가 0인 노드입니다. 다른 노드에서 들어오는 간선이 없다는 뜻이며, 연결성 평가에서는 이 노드들의 비율을 보고합니다.
- UN (unreachable nodes): search width
L_s=100의 GreedySearch에서 발견되지 않은 노드입니다. 이 측정 설정에서 찾아지지 않았다는 의미이며, 그래프의 모든 가능한 경로를 탐색해도 도달할 수 없다는 뜻은 아닙니다. - Self-query Recall@1: 저장된 벡터를 자기 질의로 검색했을 때 자신이 결과에 포함되는지 측정합니다. 외부 질의의 Recall@10과는 질의와 k가 다릅니다.
논문은 삽입 직후의 두 홉 coverage와 self-query 성능 사이의 관계, 그리고 초기 coverage가 낮은 노드 묶음의 이후 검색 결과를 보고합니다. 이 지표들은 그래프의 국소 구조와 지정된 검색 설정에서의 발견을 측정합니다.
2. CRNG의 세 가지 가지치기 경우
새 노드 p를 연결할 때 알고리즘은 p의 벡터와 후보 v 사이의 거리 δ(p,v)를 기준으로 후보를 처리합니다. 선택된 이웃 집합을 S라 하면, 후보 v를 가리는 연결은 선택된 u ∈ S가 존재하고 실제 간선 v ∈ N_out(u)가 있으며 δ(u,v) < δ(p,v)인 경우입니다. 따라서 p에서 u를 거쳐 v로 갈 때 목표 v까지의 거리가 줄어듭니다. 후보 사이의 거리만으로 간선을 생략하는 것이 아니라, 선택된 u에서 v로 가는 간선이 그래프에 실제로 있는지 확인합니다.
CRNG의 처리 경우는 다음과 같습니다.
- 두 홉 경로가 없습니다. 선택된 이웃에서 v로 가는 실제 간선이 없으면 p→v를 추가합니다.
- 경로가 있고 단조롭게 가까워집니다. 실제 간선 u→v가 위 거리 조건을 만족하면 p→v를 생략하고, 후보 v를 가린 이웃 u를 occlusion map
O[v]에 기록합니다. - 경로는 있지만 단조 조건은 맞지 않습니다. p→v를 추가하고, 해당 경로의 occluder에서 v로 가는 간선 u→v를 제거합니다.
이 절차의 거리 비교는 이미 선택된 이웃으로 실제 연결된 후보에 적용됩니다. 논문의 Lemma 4.1은 pruning에 입력된 후보 집합 C에서 앞쪽 min(R,L)개 후보의 처리와 두 홉 경로를 기술합니다. 여기서 C는 그래프 탐색으로 모은 후보이고 L은 후보 폭입니다. 이 명제의 범위는 해당 후보 집합과 한 번의 pruning 호출입니다.
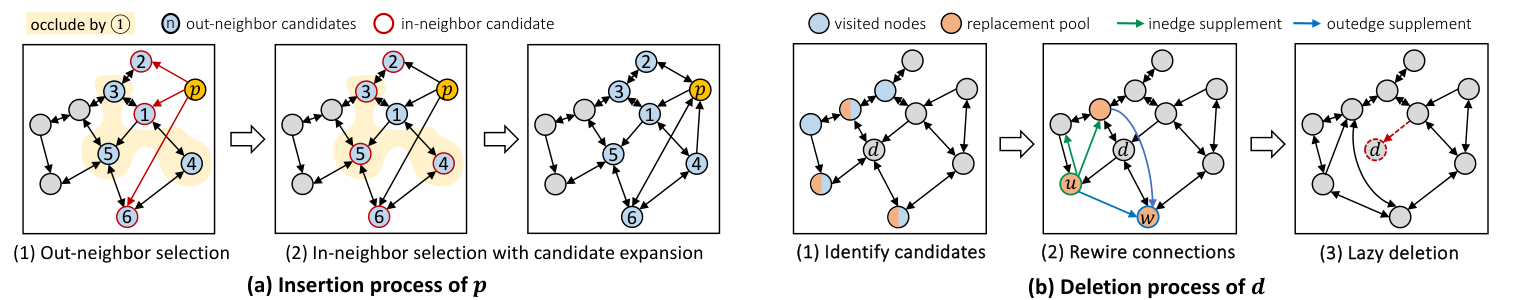
그림 9. Lee와 Kim(2026), PDF p. 7(인쇄 쪽수 3363). 삽입의 outgoing 이웃 선택과 incoming 연결 보강, 삭제 주변의 재연결과 검색 중 정리 단계를 함께 나타냅니다.
3. 삽입과 역방향 후보 확장
새 벡터 p는 GreedySearch로 탐색한 후보에서 outgoing 이웃을 고르고 CRNG로 가지치기합니다. 이어 선택된 기존 이웃 w의 adjacency list에 p를 incoming 후보로 추가합니다. 목록이 R보다 길어지면 이 단계에서 CRNG가 아닌 MRNG 방식으로 다시 가지치기합니다.
기존 이웃의 목록에서 p가 제외되었을 때, 삽입 알고리즘은 p의 후보를 가렸던 이웃을 추적해 추가 incoming 후보를 고려합니다. occlusion map O는 후보 y를 가린 선택 이웃을 기록하는 데 사용됩니다. 확장 후보 수는 원래 방문 후보 가운데 상위 β 비율로 제한하며 기본값은 β=0.25입니다. 이 값은 논문에서 역방향 후보 확장의 설정으로 사용됩니다.
4. 삭제와 검색 중 간선 정리
삭제 단계는 삭제할 노드 d의 벡터로 검색해 방문 집합을 모으고, 그중 가까운 k_d개를 대체 후보 집합으로 만듭니다. 방문 집합에서 발견한 각 incoming 이웃 u의 목록에서는 d로 향하는 참조를 제거하고, 대체 후보 중 u에 가까운 c개 노드를 연결합니다. d의 outgoing 이웃 w에 대해서도 가까운 대체 후보 c개를 골라 각 후보에서 w로 향하는 간선을 보강합니다. 수정된 목록이 차수 상한을 넘으면 CRNG로 가지치기합니다. 이 과정은 전체 그래프를 순회해 모든 incoming 이웃을 찾는 방식이 아니라 검색으로 발견한 주변에서 수행됩니다.
남은 간선은 stale edge, 즉 삭제된 노드를 계속 가리키는 오래된 참조가 될 수 있습니다. 논문은 삭제 노드의 첫 벡터 차원에 sentinel을 기록하고, 이후 검색이 그 노드를 만나면 현재 adjacency list에서 해당 간선을 정리하는 lazy deletion을 설명합니다. 삭제된 location은 free pool로 돌아가 새 삽입에서 재사용됩니다. 이 방법은 전체 그래프의 간선을 삭제 시점에 모두 순회해 정리하는 방식과 다릅니다. 논문은 지역 검색이 일부 incoming 이웃을 놓칠 수 있어 stale edge가 남을 수 있다고 설명합니다.
동시 workload에서는 논문이 per-node reader-writer lock을 사용합니다. 평가에서는 삽입·삭제와 검색을 함께 실행하고 p99 latency와 Recall@1을 보고합니다.
5. 데이터·workload·측정 조건
기본 동적 비교에는 MS Turing, MS SpaceV, Wikipedia, BIGANN, Text-to-Image의 1M(백만) 규모 데이터가 포함됩니다. 논문은 sliding-window(SW)와 expiration(EX, 만료 기반 갱신) workload를 구분합니다. 여기서 churn은 삽입·삭제로 교체되는 데이터 비율이며, SW는 시점당 2%, EX는 평균 4%로 설정됩니다. clustered workload에는 MS Turing 10M과 30M이 포함되고, temporal 평가에는 YFCC84M의 10개월 구간 데이터와 최근 3개월의 질의가 사용됩니다. 동시 workload는 별도로 MS SpaceV 100M에서 수행됩니다.
일반 검색의 L_s=100, graph degree 상한 R=32, 구축 폭 L=64입니다. CONDA와 IPV의 삭제 설정은 L_d=128, k_d=50, c=3; CONDA의 reverse candidate expansion은 β=0.25입니다. 일반 동적 실험은 64개 스레드, 정적 인덱스 검색 비교는 1개 스레드를 사용합니다. 동시 workload는 삽입·삭제·검색에 각각 5개 스레드를 두고 6시간 실행합니다.
데이터 표현과 거리 함수도 자료마다 다릅니다. Wikipedia의 768차원 float32와 Text-to-Image의 200차원 벡터는 inner product를 사용합니다. MS SpaceV의 100차원 int8와 BIGANN의 128차원 uint8 벡터는 L2 거리를 사용합니다. 실험 장치는 Ubuntu 20.04.4, dual Xeon Gold 6326, 논문 표기 32 cores, RAM 512GB입니다.
Recall@k는 정답 최근접 이웃 k개 중 결과에 포함된 비율이고, QPS는 초당 검색 질의 수입니다. 검색 성능 비교는 recall과 검색 throughput의 관계를 데이터셋별로 제시합니다. 업데이트 시간이나 update throughput은 별도 지표이므로 검색 QPS와 같은 측정값이 아닙니다.
6. 검색, 갱신, 동시 실행 결과
논문은 SW·EX 평균 Recall 개선을 FreshVamana 대비 각각 9.7%·9.2%, IPVamana 대비 4.6%·4.0%로 보고합니다. Wikipedia1M/SW에서는 FreshVamana 대비 24.5% 개선을 보고합니다. 이는 상대적인 백분율이며 24.5 percentage points 증가와는 다른 표현입니다.
MS Turing 10M clustered workload에서 Recall 0.80을 맞춘 검색 QPS는 FreshVamana, IPVamana, Wolverine+, Wolverine++ 대비 각각 1.56배, 1.42배, 1.57배, 1.47배로 보고됩니다. 이 값은 해당 recall 수준의 검색 처리량입니다.
Table 3은 MS Turing 10M·30M clustered workload의 전체 update 시간을 초 단위로 보고합니다. 이 표는 검색 Recall을 맞춘 update 비교가 아닙니다.
| 데이터 크기 | FreshVamana | IPVamana | Wolverine+ | Wolverine++ | CONDA |
|---|---|---|---|---|---|
| 10M | 213.0 | 296.2 | 238.0 | 135.2 | 260.3 |
| 30M | 1148.0 | 1391.2 | 1322.7 | 528.8 | 1025.4 |
이 표에서 Wolverine++의 update 시간이 두 규모 모두 가장 짧습니다. 논문은 Wolverine++의 update 시간과 CONDA의 검색 품질을 함께 비교해 보고합니다. 초록의 update throughput 1.90배와 결론의 평균 update time 20.5% 감소는 각각 별도로 보고된 집계값입니다.
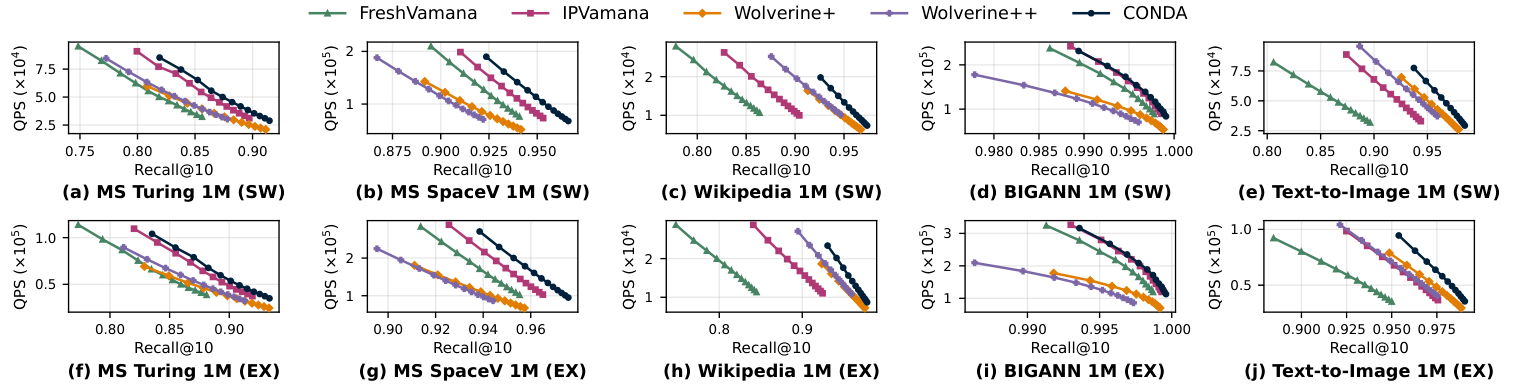
그림 11. Lee와 Kim(2026), PDF p. 9(인쇄 쪽수 3365). 다섯 데이터셋의 SW·EX 조건에서 Recall@10과 QPS를 나타냅니다.
MS SpaceV 100M 동시 workload는 6시간 동안 삽입·삭제·검색을 각각 5개 스레드로 실행합니다. 논문은 검색 p99 latency와 Recall@1을 시간에 따라 보고합니다. Recall@1은 일반 실험의 Recall@10과 다른 지표이며, 동시 실험 도판에서도 시간이 지나며 감소합니다. p99는 요청 지연의 99백분위 값으로, 지연이 그 값 이하인 요청이 99%인 지점을 나타냅니다.
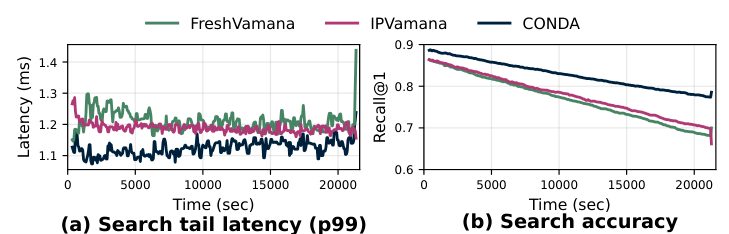
그림 17. Lee와 Kim(2026), PDF p. 10(인쇄 쪽수 3366). MS SpaceV 100M 동시 삽입·삭제·검색 중 p99 latency와 Recall@1의 시간 변화를 나타냅니다.
7. 구성요소별 절제 실험
두 홉 거리 조건
논문은 pruning의 hop parameter를 1, 2, 3으로 바꾸어 평가합니다. Figure 19의 MS SpaceV 측정 시간은 h=1, 2, 3 순서로 33.1초, 24.4초, 32.4초입니다. 별도로 본문에서 보고하는 Wikipedia 시간은 같은 순서로 397초, 97초, 242초입니다. 서로 다른 데이터셋의 측정값이며 같은 실험 행의 숫자로 섞지 않습니다.
Reverse candidate expansion 비율
Table 4는 β를 0에서 0.25로 바꾸는 설정을 비교합니다. Wikipedia의 CONDA 결과는 QPS 9.4K에서 10.2K로 바뀌고 build time은 57.8초에서 56.8초로 보고됩니다. 같은 표에서 FreshVamana는 QPS 10.5K에서 16.2K로 바뀝니다. 이 표의 Wikipedia 열은 CONDA의 target recall이 0.95, FreshVamana의 target recall이 0.85이므로 각 방법의 설정 비교이며, 두 QPS 열의 직접적인 같은-recall 비교는 아닙니다.
Lazy deletion
논문은 lazy deletion을 켰을 때 delete time이 15.9초에서 13.2초로 바뀌고, QPS가 175.9K에서 173.7K로 바뀌며, Recall은 0.16% 하락한다고 보고합니다. 이 결과는 삭제 시간, 검색 QPS, recall을 각각 다른 지표로 제시합니다.
Table 5의 Wikipedia 설정에서는 L_d=16에서 L_d=512로 바꿀 때 stale-edge 비율이 1.26%에서 0.57%로, Recall이 0.899에서 0.921로 바뀝니다. Delete throughput은 9.4K에서 3.7K OPS로 내려갑니다. Query QPS는 L_d=16에서 20.0K, L_d=128에서 17.8K, L_d=512에서 21.1K로 보고됩니다.
Maintenance policy와 query budget
Figure 20은 인덱스 초기 생성과 이후 maintenance policy를 나누어 비교합니다. 논문은 CONDA maintenance를 쓸 때 FreshVamana로 시작한 인덱스에서도 Recall이 개선되는 경향과, CONDA로 시작한 인덱스가 FreshVamana maintenance에서 낮아지는 결과를 보고합니다.
논문은 k=1, 10, 100, 1000의 검색 결과 크기도 평가합니다. 이 비교에서 k=1은 L_s=100을 사용하고, k=10,100,1000은 L_s=10k를 사용합니다. 따라서 각 k의 결과는 서로 다른 search width 설정과 함께 제시됩니다.
8. 저자가 밝힌 한계
논문은 지역 검색이 일부 incoming 이웃을 놓칠 수 있고, 그 결과 stale edge가 남아 장기 검색 성능에 영향을 줄 수 있다고 설명합니다. bounded-cost repair와 disk-resident 확장은 후속 과제로 남깁니다.
References
Lee, D., & Kim, M.-S. (2026). CONDA: A connectivity-aware dynamic index for approximate nearest neighbor search over evolving data. Proceedings of the VLDB Endowment, 19(11), 3357–3370. https://doi.org/10.14778/3836663.3836694