GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
질문은 여러 개, 읽을 기억은 함께: GQA가 KV 캐시를 줄이는 방법
여러 attention head가 같은 Key·Value를 읽으면 무엇이 줄어들까. GQA의 그룹 공유와 기존 모델을 바꾸는 추가 학습을 설명하고, KV 캐시 절감·T5 품질·추론 시간의 서로 다른 의미를 살펴본다.
Paper: Joshua Ainslie; James Lee-Thorp; Michiel de Jong; Yury Zemlyanskiy; Federico Lebrón; Sumit Sanghai (2023). "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints". arXiv:2305.13245v3. Google Research. 앞의 세 저자는 공동 기여자이며 Michiel de Jong은 USC 소속으로, Google Research에서 수행한 연구로 표시된다. 검토 PDF · 서지 정보 · EMNLP 2023 출판본 · DOI. 최초 공개는 2023-05-22이며, 본문·수치·도판은 2023-12-23의 arXiv v3, 7쪽을 기준으로 한다.
언어 모델이 다음 단어를 만들 때는 앞에서 읽은 내용을 다시 참고해야 한다. Attention head마다 서로 다른 관점으로 관련 정보를 찾는데, 그때마다 각자 별도의 Key와 Value를 보관해야 할까? 질문하는 방식은 여러 개 유지하되, 찾아볼 표현은 일부 공유할 수 있다면 저장하고 읽는 부담을 줄일 수 있다.
GQA(Grouped-Query Attention)는 이 절충을 택한다. Query head는 그대로 두고 K/V head만 그룹 단위로 공유한다. 또 이미 학습한 모델을 버리지 않도록, 기존 체크포인트의 K/V projection을 평균한 뒤 추가 사전학습으로 새 구조에 적응시키는 절차를 제시한다. 캐시의 저장 형식만 바꾸는 기법이 아니라, 모델 구조와 학습을 함께 바꾸는 방법이다.
T5-XXL의 GQA-8은 원표 평균 점수 47.1로 MHA-XXL의 47.2에 가깝고, 보고된 시간 지표는 1.51에서 0.28로 작아진다. 다만 이는 모델마다 batch와 병렬화를 최적화한 TPU 실험이다. 이 글은 무엇을 공유하는지부터 살펴본 뒤, KV 캐시가 줄어드는 비율, 품질이 유지된 범위, 실제 측정한 시간의 의미를 나누어 읽는다.
핵심 요약
| 항목 | 설명 |
|---|---|
| 핵심 아이디어 | Query는 H개 유지하고 K/V는 G개만 둔다. GQA-1은 MQA, GQA-H는 MHA다. |
| 체크포인트 재사용 | 그룹 내 K/V projection을 평균한 뒤 원래 recipe로 추가 pretraining한다. 함수가 그대로 보존되는 변환은 아니다. |
| 5%의 의미 | 원래 pretraining step 수의 α=0.05를 추가한다. 원문은 약 600 TPUv3 chip-days를 보고한다. |
| 적용 범위 | T5.1.1 decoder self-attention과 cross-attention. Encoder self-attention은 바꾸지 않는다. |
| 대표 결과 | 저자 보고 평균 MHA-XXL 47.2, GQA-8-XXL 47.1, MQA-XXL 46.6. 서로 다른 task metric의 집계다. |
| 시간 비교 | Table 1의 MHA/GQA 비율 1.51/0.28≈5.39. GQA 시간은 MQA보다 약 16.7% 크다. |
| 주요 유보 | Dev에서 모델 선택·평가, TPU별 최적 batch, Figure 3 ms/Table 1 s 충돌, MQA 평균 산술 불일치. |
| 일반화 경계 | Decoder-only 모델·XXL GQA from-scratch 비교는 이 논문에서 검증하지 않았다. |
목차
- 읽어야 할 KV head를 줄인다는 발상
- G는 query 수가 아니라 공유할 KV 그룹 수다
- 평균으로 변환하되 추가 학습으로 적응한다
- 줄어드는 메모리와 남는 계산을 구분한다
- 평가 프로토콜이 성능 비교의 의미를 정한다
- 품질은 가깝지만 평균의 분모를 확인해야 한다
- 시간 개선은 어떤 측정 조건에서 나온 것인가
- 추가 학습과 그룹 수 절제가 말하는 것
- GQA와 다른 KV 최적화는 다른 항을 바꾼다
- 좋은 절충과 아직 검증되지 않은 범위
1. 읽어야 할 KV head를 줄인다는 발상
Decoder는 새 토큰(token)을 만들 때 이전 토큰들의 key와 value를 다시 참조한다. 여기서 query는 지금 무엇을 찾을지 나타내는 벡터, key는 관련성을 비교할 벡터, value는 그 관련성에 따라 섞어 가져올 정보 벡터다. 앞서 계산한 K/V를 보관하는 공간이 KV 캐시다.
다중 헤드 어텐션(Multi-Head Attention, MHA)은 query head마다 별도의 K/V head를 사용한다. 표현을 다양하게 만드는 데 유리하지만, 생성 길이와 한 번에 처리하는 요청 수(batch)가 커질수록 저장하고 읽어야 할 KV도 커진다.
다중 쿼리 어텐션(Multi-Query Attention, MQA)은 query head를 여러 개 유지하면서 모든 query가 하나의 K/V head를 공유한다. 읽기량은 크게 줄지만 모델의 표현 자유도가 줄어들고, 기존 MHA 모델을 바로 변환하면 품질이 나빠질 수 있다. GQA는 이 두 끝 사이에 여러 K/V 공유 그룹을 둔다.
논문의 기여는 새로운 구조만이 아니다. 이미 비싼 pretraining을 끝낸 MHA checkpoint에서 출발해, 빠른 decoder를 얻기 위한 변환과 uptraining의 절차도 제시한다. ‘작은 모델을 처음부터 학습한다’거나 ‘모델은 그대로 두고 cache만 압축한다’는 접근과 다르다. MQA는 Shazeer(2019)의 선행 연구이며, 이 논문은 Rabe(2023)의 독립적인 GQA 개발과 공개 구현도 관련 연구에서 인정한다.
2. G는 query 수가 아니라 공유할 KV 그룹 수다
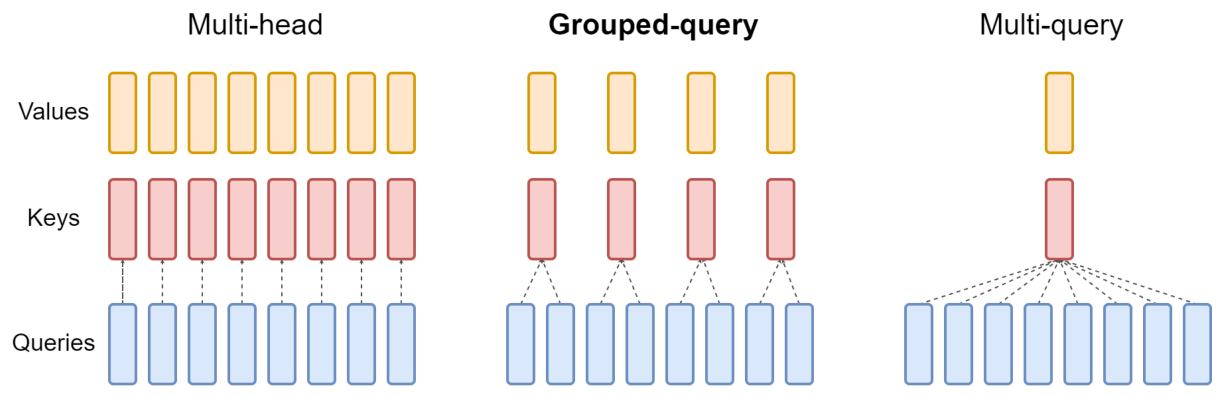
Figure 2. Query head 수는 같고 K/V head 수만 달라진다. 가운데 그림은 query 8개가 KV 4쌍을 공유하는 구조 예시이며, 뒤의 GQA-8 실험 구성을 그대로 그린 것은 아니다. 출처: Ainslie et al. (2023), v3, p.2, Fig.2 — 연구·학습 목적 인용.
| 구조 | Query head | Key head | Value head |
|---|---|---|---|
| MHA | H | H | H |
| GQA-G | H | G | G |
| MQA | H | 1 | 1 |
GQA-8은 K/V 그룹이 8개라는 뜻이다. Query가 8개라는 뜻이나 각 그룹에 반드시 query 8개가 있다는 뜻은 아니다. 균등 그룹이고 G가 H를 나누면 그룹당 query는 H/G개다.
설명용으로 query head가 32개라면 GQA-8에서는 네 query head가 K/V 한 쌍을 함께 쓴다. MHA처럼 32쌍을 따로 두지도, MQA처럼 모두가 한 쌍만 쓰지도 않는다. 아래 메모리 예시도 이 32개 query·8개 KV 그룹 설정을 사용하며, 논문의 T5 head 구성을 그대로 옮긴 것은 아니다.
원문의 공유 구조를 기호로 풀어 쓰면, query head h가 속한 그룹을 g(h)라 할 때 self-attention 출력은 다음과 같다.
o_h=\operatorname{Attention}(XW_h^Q,\;X\bar W_{g(h)}^K,\;X\bar W_{g(h)}^V).Query projection은 head마다 다르므로 같은 K/V를 읽어도 attention 확률과 출력은 다를 수 있다. Attention map을 그룹당 하나로 합치는 방법이 아니다. Head별 출력을 합치는 output projection도 유지된다. Cross-attention에서는 Q가 decoder에서, K/V가 encoder representation에서 온다는 점이 달라진다.
이 연구는 decoder의 self-attention과 cross-attention을 모두 바꾸지만 encoder self-attention에는 적용하지 않는다. Encoder는 token을 병렬 처리하므로 반복적인 KV 읽기 병목이 decoder와 다르다는 설계 근거다. GQA가 encoder에 수학적으로 적용 불가능하다는 주장은 아니다.
3. 평균으로 변환하되 추가 학습으로 적응한다
3.1 평균하는 것은 projection matrix다
기존 MHA에서 같은 그룹에 들어갈 head 집합을 Sg라 하면 K/V projection을 각각 평균한다.
\bar W_g^K=\frac1{|S_g|}\sum_{h\in S_g}W_h^K,\qquad
\bar W_g^V=\frac1{|S_g|}\sum_{h\in S_g}W_h^V.
Query projection을 평균해 head 수를 줄이는 것이 아니다. 이미 계산한 attention 확률을 평균하는 것도 아니다. G=1이면 모든 K/V projection을 평균하고, G=H이면 각 그룹이 한 head라 원래 구조로 돌아간다.
원소별 제곱오차를 기준으로 여러 행렬을 하나로 대표할 때 평균은 자연스러운 선택이다. 하지만 평균 projection이 원래 모델의 함수를 보존하지는 않는다. 선형 projection의 평균은 가능해도 softmax와 value 가중합을 거친 여러 head의 출력은 그 평균으로 일반적으로 재현되지 않는다. 이는 변환을 이해하기 위한 해설이며 논문이 제시한 품질 보존 정리가 아니다.
Figure 4의 실제 비교는 T5-Large를 MQA로 바꾸는 실험이다. K/V 평균이 첫 head 선택보다, 첫 head 선택이 무작위 초기화보다 좋았다. 이 결과를 모든 모델에서 평균이 유일한 최적 변환이라는 증명으로 확대하지 않는다. 특히 GQA의 그룹을 유사도에 따라 최적으로 찾는 별도 탐색 실험은 아니다.
3.2 5%는 추가 pretraining의 기준이다
변환 뒤 원래 pretraining recipe로 원래 step 수의 α만큼 더 학습한다. 대표 설정 α=0.05에서 저자는 약 600 TPUv3 chip-days를 보고한다. Chip-days는 장치 수에 걸친 합산 자원량이지 사람이 기다린 wall-clock 600일이라는 뜻이 아니다.
초록은 원래 pretraining compute의 5%라고 요약하지만 절차의 직접 정의는 step 비율이다. 변환으로 step당 연산도 달라지므로 정확히 전체 FLOPs의 5%라고 독립 확인한 수치는 아니다. 또한 기존 MHA checkpoint를 만드는 비용과 이후 task별 fine-tuning 비용까지 포함한 총 학습비가 5%라는 뜻도 아니다.
기존 비싼 모델을 활용할 수 있다는 장점과 추가 학습이 공짜가 아니라는 점을 함께 봐야 한다. 이 방법은 inference-time 설정만 바꾸는 무학습 cache 최적화가 아니다.
4. 줄어드는 메모리와 남는 계산을 구분한다
4.1 KV 캐시에서 저장할 head 수가 줄어든다
설명용으로 decoder self-attention의 층 수 L, batch B, cache 길이 T, head dimension d, 원소당 byte 수 b를 고정하면 KV cache의 논리적 크기는 다음과 같다.
M_{\mathrm{MHA}}=2LBT Hdb,\qquad
M_{\mathrm{GQA}}=2LBT Gdb,\qquad
\frac{M_{\mathrm{MHA}}}{M_{\mathrm{GQA}}}=\frac HG.
2는 key와 value다. 모델 weight·임시 buffer·padding·allocator·분산 복제는 제외한 해설 산술이다. Encoder–decoder 모델에서는 self-attention과 cross-attention cache를 각각 계산해야 하며 길이도 생성 길이와 입력 길이로 다르다.
예를 들어 설명용 설정 L=32, B=1, T=8,192, H=32, d=128, b=2라면 MHA는 4GiB, GQA-8은 1GiB, MQA는 128MiB다. 이는 T5 실험의 측정 메모리가 아니다. 같은 가정에서 줄어드는 head 축을 보여 주는 예다.
4.2 모든 연산이 H/G만큼 줄어들지는 않는다
Query head는 H개라 각각 query–key score와 value 가중합을 계산한다. K/V projection의 출력 폭과 cache는 줄지만 Q·output projection·FFN은 같은 비율로 작아지지 않는다. Attention score 연산도 query head 수를 유지한다. 따라서 ‘KV cache 8배 감소’를 ‘모델 전체 FLOPs 8배 감소’나 ‘서비스 지연 8배 감소’로 바꾸면 안 된다.
물리적 읽기량도 kernel이 공유 K/V를 재사용하는 방식에 달려 있다. 구현이 head 수만큼 중복 확장·복사하면 논리적 저장 절감이 그대로 실현되지 않을 수 있다. 이 경계는 계산 구조의 해설이지 원문의 kernel에서 그런 결함을 발견했다는 뜻은 아니다.
4.3 분산 복제 때문에 MQA와의 차이가 달라진다
논문은 모델 partition마다 MQA의 단일 K/V head가 복제될 수 있다고 지적한다. 설명용으로 8개 partition에 MQA head를 하나씩 복제하면 전체에 8벌이 남는다. GQA-8의 서로 다른 그룹을 각각 한 partition에 잘 배치하면 총 K/V 수는 역시 8개다. 논리적으로 head가 8배 많아도 이런 배치에서는 전체 물리 cache가 MQA보다 8배 커지지 않는다.
이 예는 그룹과 partition이 정렬되는 경우다. Table 1의 실제 병렬 배치를 재현한 것도, 임의 G와 partition 수에서 복제가 사라진다는 보장도 아니다.
5. 평가 프로토콜이 성능 비교의 의미를 정한다
모델은 T5.1.1 Large와 XXL이며 JAX·Flax·Flaxformer로 구현했다. MQA/GQA는 공개 MHA checkpoint를 변환·uptrain한다. 따라서 본문의 실험은 현대 decoder-only 모델을 바로 측정한 것이 아니다.
| 평가군 | 과제 | 입력 / 출력 길이 | 지표 |
|---|---|---|---|
| 짧은 요약 | CNN/Daily Mail | 512 / 256 | ROUGE-1 |
| 긴 요약 | arXiv, PubMed, MediaSum, Multi-News | 2,048 / 512 | ROUGE-1 |
| 번역 | WMT 2014 English→German | 512 / 256 | BLEU |
| 질문응답 | TriviaQA | 2,048 / 32 | F1 |
저자 설정, §3.1. GLUE 같은 classification benchmark는 autoregressive inference의 적용성이 낮다는 이유로 평가하지 않았다.
Fine-tuning은 learning rate 0.001, batch 128, dropout 0.1을 사용하고 convergence까지 학습한 뒤 dev 성능이 가장 높은 checkpoint를 고른다. Table 1도 dev 성능이다. 모델 선택에 사용한 dev와 별개의 blind test 결과라고 소개하지 않는다. Greedy decoding을 사용했으므로 beam search·다양한 sampling 정책에 동일한 속도·품질 관계가 검증된 것도 아니다.
MHA baseline과 5% uptrained 변형의 비교는 실용적인 checkpoint 전환 결과다. 동일하게 5%를 더 학습한 MHA 통제군이 제시되지 않아, 추가 pretraining의 효과와 구조 변경의 효과를 완전히 분리한 실험은 아니다.
6. 품질은 가깝지만 평균의 분모를 확인해야 한다
| 모델 | 원표 Average | CNN | arXiv | PubMed | MediaSum | MultiNews | WMT | TriviaQA |
|---|---|---|---|---|---|---|---|---|
| MHA-Large | 46.0 | 42.9 | 44.6 | 46.2 | 35.5 | 46.6 | 27.7 | 78.2 |
| MHA-XXL | 47.2 | 43.8 | 45.6 | 47.5 | 36.4 | 46.9 | 28.4 | 81.9 |
| MQA-XXL | 46.6 | 43.0 | 45.0 | 46.9 | 36.1 | 46.5 | 28.5 | 81.3 |
| GQA-8-XXL | 47.1 | 43.5 | 45.4 | 47.7 | 36.3 | 47.2 | 28.4 | 81.6 |
Table 1, p.3, 저자 보고. 요약 열은 ROUGE-1, 번역은 BLEU, QA는 F1이며 Average는 이를 집계한 값이다.
GQA는 MHA-XXL보다 CNN −0.3, arXiv −0.2, MediaSum −0.1, TriviaQA −0.3점이며 PubMed +0.2, MultiNews +0.3, WMT 동률이다. ‘가까운 품질’이라는 해석과 부합하지만 모든 task에서 같은 결과라는 뜻은 아니다. MQA와 비교해도 WMT는 GQA가 0.1점 낮다.
원표의 평균 차이는 MHA와 GQA 사이 0.1점이다. 하지만 ROUGE·BLEU·F1을 섞은 평균을 보편적인 ‘정답률’로 읽거나, 그 비율을 일반 지능의 보존율로 설명하지 않는다. 작은 차이에 대한 신뢰구간과 유의성도 제시하지 않는다.
MQA의 원표 평균은 단순 반올림으로 설명되지 않는다
MQA의 일곱 표시 점수 합은 327.3이고 단순 평균은 약 46.757이다. 각 task가 소수 첫째 자리로 반올림됐다고 가정해도 가능한 평균 범위는 약 [46.707, 46.807)이다. 원표 46.6이 나타내는 [46.55, 46.65)와 겹치지 않는다.
따라서 ‘같은 일곱 과제를 동일 가중치로 평균했다’는 해석 아래에서는 단순 반올림으로 설명할 수 없다. 다른 집계나 run 처리 차이인지 오기인지는 원시 결과 없이 알 수 없다. 이 글은 원표 46.6을 유지하면서 산술 불일치를 병기한다.
반면 GQA의 표시 점수 평균 47.157과 원표 47.1은 각 task의 반올림 구간을 고려하면 양립할 수 있다. 두 경우를 모두 오류라고 묶지 않는다. 이 한계가 표 전체의 질적 경향을 자동으로 뒤집는 것은 아니지만, ‘평균 +0.5’ 같은 세밀한 차이를 해석할 때는 집계 계약이 필요하다.
7. 시간 개선은 어떤 측정 조건에서 나온 것인가
| 모델 | Table 1 Tinfer, s | MHA-XXL 시간 / 해당 시간 |
|---|---|---|
| MHA-Large | 0.37 | 4.08× |
| MHA-XXL | 1.51 | 1.00× |
| MQA-XXL | 0.24 | 6.29× |
| GQA-8-XXL | 0.28 | 5.39× |
원표 시간과 그 표시값의 산술 비율. Table 1은 s로 표시한다.
§3.1은 TPUv4 chip당 sample 시간을 xprof로 측정했다고 설명한다. 8개 TPU를 사용하고, 모델마다 메모리에 들어가는 가장 큰 batch를 선택하되 TPU당 최대 32로 제한한다. 병렬화도 모델별로 따로 최적화한다. 이것은 전부 같은 batch·동일 tensor-parallel layout에서 attention 종류만 바꾼 측정이 아니다.
Cache 절약으로 더 큰 batch를 넣을 수 있는 이점도 반영될 수 있는 시스템 효율 비교로 읽는 것이 적절하다. 실제 모델별 batch 수는 제시하지 않는다. 반대로 이 값을 batch 1 사용자가 느끼는 요청 latency, token 하나 사이의 TBT, 또는 prefill을 제외한 순수 decode kernel 시간으로 단정하면 안 된다. 과제별 출력 길이도 다르며 표는 여러 과제의 평균 지표다.
GQA는 MQA보다 0.04초, 비율로 약 16.7% 더 걸린다. ‘MQA에 가까운 속도’는 동일 속도라는 뜻이 아니다. GQA-XXL의 0.28이 MHA-Large의 0.37보다 작다는 결과도 위의 batch·배치 조건을 동반한다. 모델이 더 크면 언제나 더 빠르다는 일반 명제가 아니다.
Figure 3의 ms 표기는 그대로 맞춰 쓸 수 없다
Figure 3은 같은 규모의 0.24·0.28·1.51 부근 좌표를 **Time per sample (ms)**라고 표기한다. 반면 Table 1과 Figure 6은 s다. Table 1의 단위와 Figure 3의 단위 표기가 충돌한다. 좌표를 임의로 1,000배 변환할 수는 없지만, 두 표기에서 시간 비율은 같고 절대 단위는 불확실하다.
8. 추가 학습과 그룹 수 절제가 말하는 것
8.1 0%와 5%의 차이는 모델에 따라 다르다
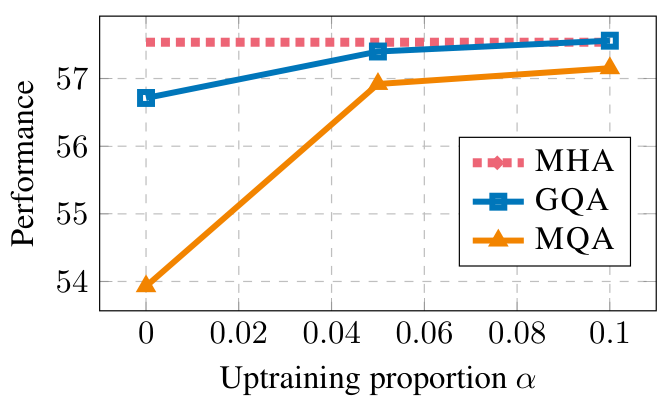
Figure 5. T5-XXL의 MQA와 GQA-8을 CNN/Daily Mail·MultiNews·TriviaQA 세 과제로 비교한다. 가로축 0은 추가 사전학습이 없다는 뜻이며 과제별 미세조정까지 생략한 조건은 아니다. 출처: Ainslie et al. (2023), v3, p.4, Fig.5 — 연구·학습 목적 인용.
GQA는 checkpoint 변환 직후에도 MQA보다 좋은 출발점에 있고, 두 방법 모두 5% uptraining에서 개선되며 10%로 늘릴 때 이득이 줄어든다는 저자 관찰이다. 여기서 α=0은 추가 pretraining이 0이라는 뜻이다. 이후 task별 fine-tuning까지 없애고 바로 zero-shot으로 평가했다는 뜻은 아니다.
절제는 CNN/Daily Mail·MultiNews·TriviaQA 세 과제를 대상으로 한다. Figure 5의 54–57대 성능과 Table 1의 46–47대 평균은 모집단이 다르므로 직접 빼면 안 된다. Figure 4는 T5-Large MQA 전환, Figure 5는 T5-XXL MQA/GQA의 uptraining이라는 차이도 유지한다. 인쇄되지 않은 세부 값을 그래프 좌표에서 정밀 실측값처럼 추출하지 않았다.
8.2 8개 그룹은 실용적인 선택이지 보편 최적값이 아니다
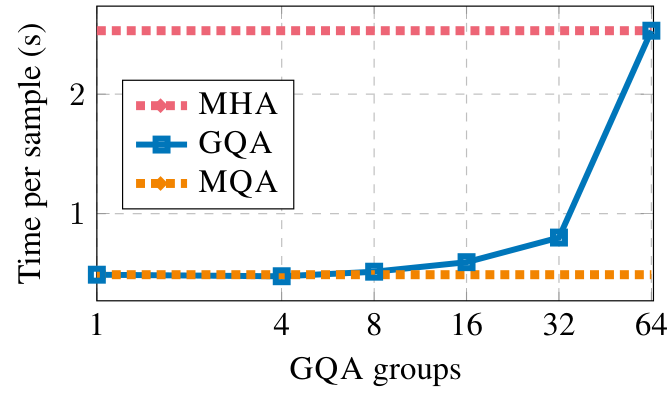
Figure 6. 입력 2,048·출력 512 설정의 group-count별 시간. 출처: Ainslie et al. (2023), v3, p.4, Fig.6 — 연구·학습 목적 인용.
그룹 수 1→4→8에서 시간 증가는 작고, 32·64 쪽으로 갈수록 증가폭이 커진다. 저자는 8을 좋은 절충으로 택했다. 하지만 Figure 6은 주로 시간 곡선이며, 모든 G에서 품질·시간·학습 비용을 함께 최적화한 표는 아니다. 이 그림만으로 임의 모델의 최적 G=8을 도출하지 않는다.
8.3 MQA 반복 실험을 없는 것으로 쓰면 안 된다
Appendix A는 from-scratch T5-Large MQA에서 pretraining loss spike가 잦았고 긴 입력 task fine-tuning이 곧바로 발산했다고 보고한다. Uptrained MQA는 더 안정적이지만 분산이 높아 불안정한 task에서는 fine-tuning 세 번의 평균을 사용했다. 반면 uptrained GQA는 안정적으로 보였고 원인을 더 조사하지 않았다고 한다.
따라서 ‘반복이 전혀 없다’는 비판은 부정확하다. 다만 모든 모델·과제에 같은 반복 횟수를 적용한 비교도 아니며, 어떤 task가 불안정했고 run별 분산이 얼마였는지 충분히 보고하지 않는다. 이 관찰을 모든 MQA가 반드시 발산한다거나 GQA가 항상 안정적이라는 보장으로 바꾸지 않는다.
9. GQA와 다른 KV 최적화는 다른 항을 바꾼다
| 접근 | 주로 바꾸는 것 | GQA와의 차이 |
|---|---|---|
| GQA | KV head 수 G, projection 구조 | 기존 MHA를 변환하면 추가 학습이 필요할 수 있음 |
| KV quantization | 원소당 byte b | Head 공유와는 별도의 정밀도·오차 축 |
| Eviction·선택적 attention | 남기거나 접근할 token 범위 T | 어느 내용에 접근할지를 바꿈 |
| FlashAttention | Attention 계산의 tiling·중간 행렬 materialization | KV head 공유 자체와는 다른 실행 최적화 |
Declarative Attention은 어떤 맥락 구간을 읽는지 바꾼다. 반면 GQA는 K/V projection을 몇 벌 둘지 결정한다. 둘 다 KV 접근 비용과 관계가 있지만, 하나는 접근할 토큰 범위를, 다른 하나는 head 축을 바꾼다는 차이가 있다.
특히 KV 캐시를 계속 보관하면서 일부만 읽는 방법은 캐시 자체를 작게 만드는 방법과 다르다. 메모리 용량과 매번 읽는 데이터량을 따로 보고, attention 연산에 쓰이는 query head 수와 KV 저장에 쓰이는 head 수도 구분해야 한다. 다른 연구의 장치 비용 모형을 현재 GQA 논문의 TPU 실험 재현으로 볼 수는 없다.
이 방법들은 조합할 수 있는 축을 제공하지만 효과가 자동으로 곱해지지는 않는다. GQA가 KV traffic을 줄이면 FFN·weight 읽기·통신 등이 상대적으로 더 큰 병목이 될 수 있다. 추가 압축이나 선택적 읽기의 실제 이득은 남은 병목과 구현을 다시 확인해야 한다.
10. 좋은 절충과 아직 검증되지 않은 범위
논문이 밝힌 한계
- 긴 생성의 품질을 평가하기 어렵고, ROUGE가 요약 품질 전체를 담지 못한다.
- 계산 자원 제약으로 XXL GQA를 처음부터 학습한 비교 모델을 만들지 않아 uptraining과 scratch training의 상대 품질을 모른다. Appendix A의 Large MQA 관찰이 이 비교를 대신하지 않는다.
- 실험은 encoder–decoder에 한정됐다. Decoder-only에서는 GQA가 MQA보다 더 유리할 것이라는 마지막 설명은 기대이며 이 논문의 검증 결과가 아니다.
References
Ainslie, J., Lee-Thorp, J., de Jong, M., Zemlyanskiy, Y., Lebrón, F., & Sanghai, S. (2023). GQA: Training generalized multi-query Transformer models from multi-head checkpoints. In H. Bouamor, J. Pino, & K. Bali (Eds.), Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing (pp. 4895–4901). Association for Computational Linguistics. https://doi.org/10.18653/v1/2023.emnlp-main.298