Recurrent Looped Transformer
RLT는 직전 토큰에서 만든 내부 상태를 다음 토큰 계산으로 넘기는 Transformer다. 긴 순서 정보를 다루는 작은 알고리즘 과제에서 일부 강점이 있었지만, 효과는 과제와 층 배분에 따라 크게 달랐고 순차 계산 비용도 늘었다.
Paper: Yifan Zhang; Jichen Feng; Shihan Qin (2026). "Recurrent Looped Transformer" (RLT-1). Technical report. 최초 공개 2026년 9월 12일, 개정 2026년 9월 17일. 공식 PDF · 프로젝트 페이지
Abstract: RLT-1은 현재 토큰의 인코더 표현에 직전 토큰의 최종 디코더 상태를 게이트로 섞고, 그 결과를 다시 Transformer 디코더에 넣는다. 인코더는 전체 문맥을 읽을 수 있는 KV 메모리를 만들고, 디코더는 최근의 자체 KV 캐시와 직전 계산 상태를 이어 받는다. 그래서 토큰마다 평가하는 논리 블록 수는 고정돼도, 앞선 상태가 현재 출력에 닿는 경로는 시퀀스 길이에 따라 길어진다. 현행 개정본은 여섯 알고리즘 과제에서 여덟 층을 인코더와 순환 디코더에 어떻게 나눌지를 시험했다. 256비트 parity에서는 5+3과 7+1이 세 시드에서 모두 100%였고, 길이 512의 swaps-S5에서는 4+4가 decoder-only Transformer보다 훨씬 높은 최종 상태 정확도를 보였다. 그러나 이득은 과제와 층 배분에 따라 달랐고, 덧셈의 길이 외 일반화와 표준 S5는 해결하지 못했다. 이 글은 19쪽 초기본이 아니라 41쪽 9월 17일 개정 PDF만을 근거로 방법·비용·실험의 범위를 재구성한다.
Executive Summary
| 항목 | 이 논문에서 확인되는 내용 |
|---|---|
| 연구 질문 | 같은 총 깊이에서 인코더 깊이와 토큰 간 순환 디코더 깊이를 어떻게 나누면 상태 추적과 길이 외 일반화가 달라지는가? |
| 핵심 장치 | 인과 인코더 KV 메모리, 직전 최종 디코더 상태의 gated merge, 층별 sliding-window attention(SWA) 캐시를 결합한다. |
| 계산의 대가 | 알려진 토큰의 인코딩은 병렬화할 수 있지만, prefill과 학습에서도 디코더 상태 갱신은 토큰 순서대로 해야 한다. |
| 가장 강한 관찰 | parity 256비트에서는 5+3·7+1이 100.00±0.00%, swaps-S5 512연산에서는 4+4가 55.70±25.78%였다. 같은 표의 Transformer는 각각 50.07±1.63%, 0.85±0.30%다. |
| 어떻게 읽어야 하나 | 소형 CPU FP32 알고리즘 실험, 세 초기값, 정확도 중심 비교다. 하드웨어 처리량·대규모 언어 모델·RL 성능을 측정한 논문은 아니다. |
1. 이 개정본이 답하려는 문제
일반 Transformer도 attention을 통해 앞 위치의 활성에 접근한다. RLT-1의 차이는 직전 토큰의 최종 디코더 상태를 다음 토큰의 입력에 직접 되먹이는 경로를 둔다는 데 있다. 상태 추적 문제에서는 그 차이가 중요할 수 있다. 예컨대 연속된 교환을 읽으며 현재 순열을 갱신하려면, 이전까지의 중간 결과가 다음 교환을 해석하는 재료가 된다.
RLT-1은 이 중간 결과를 마지막 디코더 은닉 상태로 잡는다. 현재 입력에서 얻은 표현과 직전 은닉 상태를 결합해 다음 디코더 계산을 시작한다. 논문의 주장 범위는 “순환 경로를 만들었으니 범용 추론이 좋아진다”가 아니다. 저자들이 실제로 비교한 것은 여섯 개의 합성 알고리즘 과제에서의 학습 곡선과 길이 외 정확도, 그리고 총 여덟 논리 층 안에서의 깊이 배분이다(§§1, 3).
이 범위를 먼저 고정할 필요가 있다. 개정본의 결과는 어떤 상태 갱신 문제가 순환 경로에 반응할 수 있음을 보이지만, 자연어 벤치마크·서빙 지연·가속기 효율·정책 최적화 성능의 증거는 제공하지 않는다. 논문도 §3.6에서 현재 비교가 feedback, attention 구조, 파라미터 수, 계산을 함께 바꾼다고 명시한다.
2. 필요한 개념: 두 기억과 하나의 상태
RLT-1은 비슷해 보이지만 역할이 다른 두 저장소를 쓴다.
| 구성요소 | 무엇을 보관하나 | 현재 토큰에서 하는 일 | 범위 |
|---|---|---|---|
인코더 메모리 M_{\le t} |
인코더 표현에서 투영한 key/value | 현재까지의 입력 전체에서 관련 문맥을 cross-attention으로 찾는다 | 접두부 전체 |
디코더 SWA 캐시 C_t^D |
각 디코더 층의 최근 key/value | 최근 디코더 활성에 local attention을 한다 | 층당 최대 W-1 과거 위치 |
순환 출력 s_t |
마지막 디코더 블록의 출력 | 다음 위치의 입력을 만들 때 직전 계산 결과를 전달한다 | 한 벡터 |
인코더는 인과 마스크를 쓰므로 이미 알려진 프롬프트의 표현을 위치별로 함께 계산할 수 있다. 반면 s_t와 C_t^D는 t-1의 갱신 결과가 있어야 만들어진다. 이 비대칭이 RLT의 가능성과 비용을 함께 만든다. 전체 문맥 검색은 인코더 메모리가 담당하고, 순환 상태는 ‘어디까지 계산했는가’를 다음 위치로 넘긴다. 따라서 s_t를 긴 입력 전체의 압축 저장소로 해석하는 것은 정확하지 않다(§§2.1–2.2).
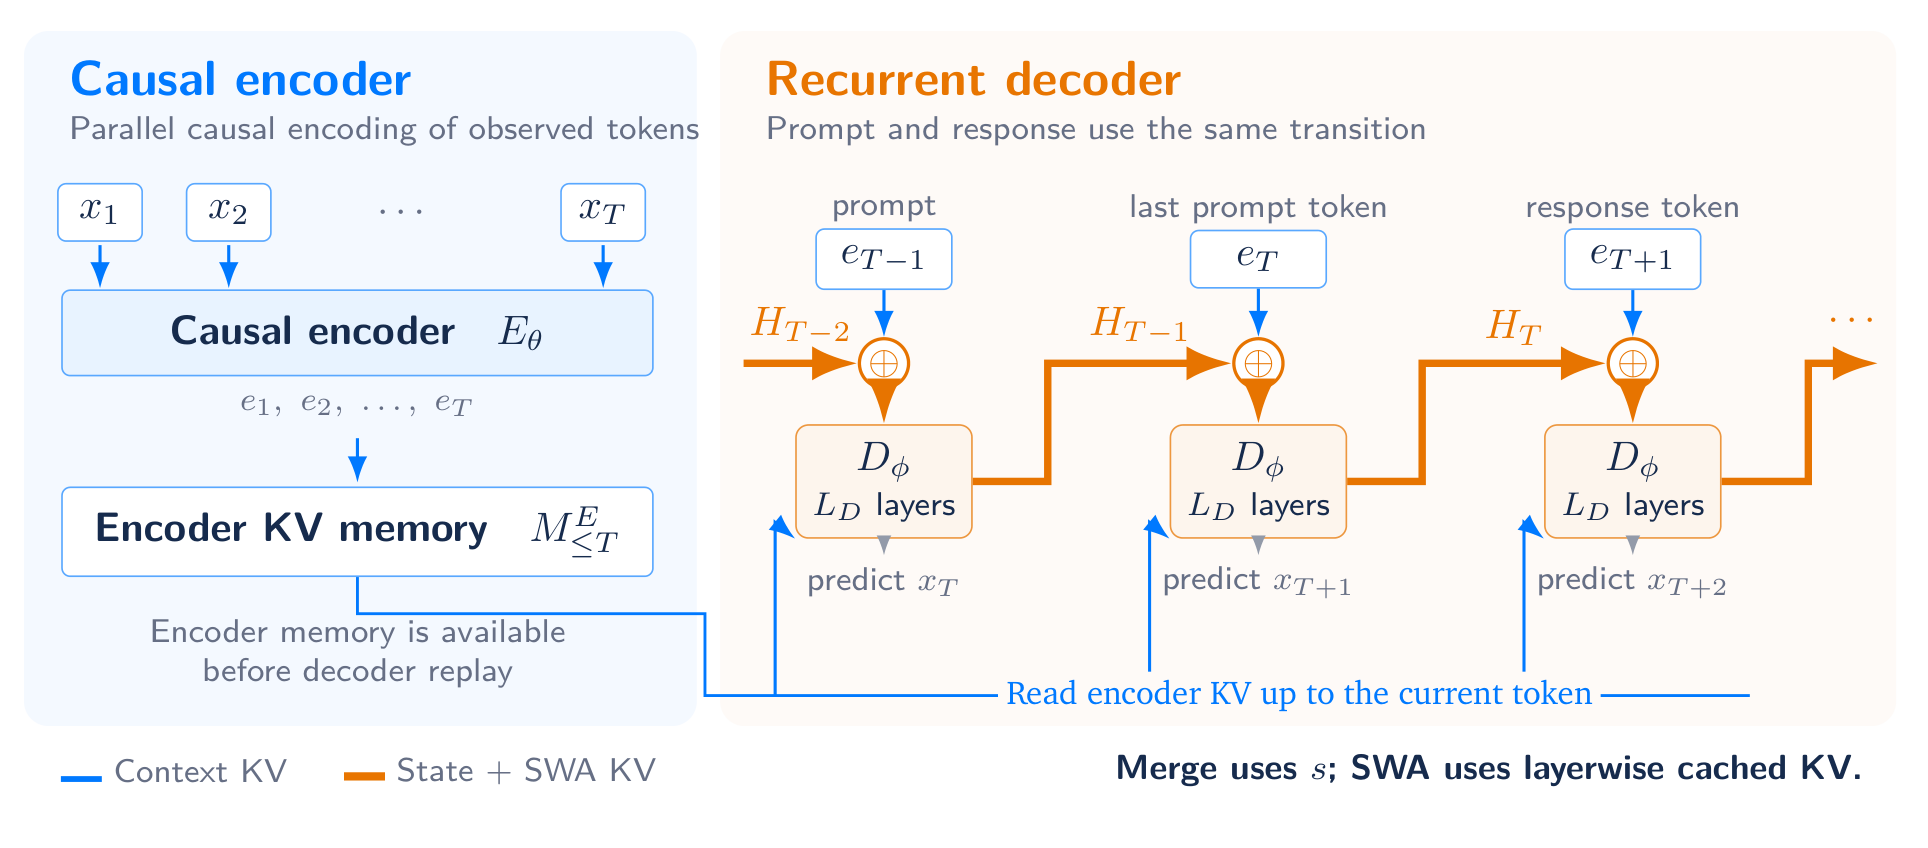
파란 경로는 앞 문맥을 찾는 메모리이고, 주황 경로는 직전 계산 상태를 다음 위치로 넘긴다. 프롬프트를 읽을 때와 답을 생성할 때 같은 상태 갱신을 쓰는 구조다. 원논문 Figure 1, p. 1을 그대로 인용했다(2026년 9월 17일 개정판).
3. 방법 재구성: 한 토큰의 전이가 다음 토큰의 출발점이 된다
독립 시퀀스는 학습된 초기 상태와 빈 디코더 캐시에서 시작한다.
H_0=(s_\star,\varnothing), \qquad H_t=(s_t,C_t^D).현재 토큰 x_t를 인코딩해 e_t를 얻고, 직전 상태를 정규화해 게이트로 섞는다.
r_{t-1}=\operatorname{RMSNorm}(s_{t-1}), \quad
g_t=\sigma(W_g[e_t;r_{t-1}]+b_g), \quad
u_t=e_t+\alpha\,g_t\odot W_s r_{t-1}.
실험 설정에서는 \alpha=0.1이다. g_t는 현재 입력과 이전 상태 사이의 기여를 좌표별로 조절하고, u_t는 디코더의 시작 입력이다. 이어서 디코더는 (1) 최근 SWA 캐시를 읽고, (2) 현재 접두부의 인코더 메모리를 cross-attention으로 읽고, (3) FFN을 적용해 s_t와 새 층별 캐시를 만든다. 다음 토큰 분포는 s_t에서 읽는다(식 2.3–2.16).
이를 절차로 쓰면 다음과 같다. 아래는 논문의 식을 읽기 위한 재구성이며, 별도의 실험 구현이나 재현을 뜻하지 않는다.
초기화: H0 = (학습된 s*, 빈 SWA 캐시)
이미 관측된 접두부: 인과 인코더 → e1:T, encoder KV memory
각 위치 t = 1 ... T 순서대로:
  ut = gated_merge(et, st-1)
  Ht = decoder(ut, encoder memory up to t, decoder SWA cache)
  st에서 다음 토큰 분포를 읽음
생성된 토큰도 인코더 캐시에 추가한 뒤 같은 전이를 한 번 적용
프롬프트와 응답의 경계에서 H_t를 초기화하지 않는 것이 핵심이다. 부록 B.1은 정확한 산술, 동등한 인과 인코더 실행, 같은 SWA 창·캐시 갱신, 결정론적 디코더 연산이라는 조건에서, 프롬프트를 한 번에 넣은 뒤 순환 prefill을 하든 증분 처리하든 같은 상태와 다음 토큰 분포를 얻는다고 귀납으로 보인다. 이것은 서비스 분할 자체가 조건부 분포를 바꾸지 않는다는 구조적 성질이다. 커널, 정밀도, 캐시 구현까지 자동으로 수치적으로 일치한다는 보장은 아니다.
4. ‘looped’의 의미와 계산 비용
인코더 깊이를 L_E, 순환 디코더 깊이를 L_D라 하자. 토큰 하나는 L_E+L_D개의 논리 블록을 평가한다. 그러나 T개 프롬프트 토큰과 n개 응답 토큰을 처리한 뒤, 과거 상태에서 현재 출력으로 가는 순환 경로는 (T+n)L_D개의 디코더 블록을 지난다(§2.6, Appendix B.3). 즉 5+3, 4+4 같은 표기는 단순한 층 배치가 아니라 토큰마다 추가하는 순환 계산의 양을 정한다.
대신 prefill이 값비싸다. 인코더 표현과 메모리는 먼저 병렬로 만들 수 있어도, 디코더는
C_{\mathrm{prefill}}(T)=C_E^{\mathrm{pf}}(T)+C_M(T)+\sum_{t=1}^{T}C_D^{\mathrm{step}}(t)처럼 T번 순서대로 갱신해야 한다(Appendix B.2). 논문이 제시한 거친 산술 차수는 밀집 attention 기준으로 O((L_E+L_D)(Td^2+T^2d)+GTd^2+L_DT\min(W,T)d)다. 차수만 보면 일반적인 밀집 Transformer와 비슷한 항이 있어도, 의존성 때문에 하드웨어 이용률은 낮아질 수 있다. 이 논문은 그 손실을 측정하지 않았으며, ‘순차 의존성이 있다’는 분석과 실제 throughput 수치를 구분해야 한다.
캐시도 공짜가 아니다. 전역 encoder KV와 층별 local SWA KV, 현재 상태를 유지해야 한다. 반대로 독립 시퀀스들의 같은 위치 갱신은 한 배치로 묶을 수 있고, encoder–decoder 가중치 공유는 파라미터 저장과 가속기 상주에 도움이 될 수 있다고 부록 C는 설명한다. 이는 구현 가능성의 분석이지 측정된 최적화 결과가 아니다. 현행 실험은 untied RLT-1을 사용했다. 부록 I의 RLT-2는 알려진 토큰을 chunk 단위로 처리하려는 별도 확장안이지만, 논문은 이를 untested라고 적는다. 따라서 여기서 말한 순차 prefill 비용과 결과는 실험된 RLT-1에 관한 것이다.
5. 실험은 무엇을 고정하고 무엇을 바꿨나
실험은 RLT-1의 untied 4+4, 5+3, 6+2, 7+1, 8+0과 8층 decoder-only Transformer를 비교한다. 8+0은 디코더 블록은 없지만 gated recurrent merge는 남아 있는 특수 구성이다. 모든 모델은 폭 512, FFN 폭 1,365, 네 attention head, 총 여덟 논리 층이다. RLT-1은 26.10–28.73M 파라미터, 기준 Transformer는 25.31M이므로 완전히 동일 파라미터 비교는 아니다(§3.1, Table 4).
| 축 | 설정 |
|---|---|
| 과제 | 덧셈, parity, 괄호 없는 mod-5, 괄호 있는 mod-5, 표준 S5, swaps-S5 — 총 여섯 개 |
| 반복 | 각 구조×과제에 초기값 42·43·44, 총 108개 완료 실행 |
| 학습 | 각 실행 2,000 optimizer step, global batch 512, 총 1,024,000 training examples |
| 최적화 | AdamW, (\beta_1,\beta_2)=(0.9,0.95), weight decay 0.1, gradient clipping 1, warmup 200 step 뒤 cosine decay |
| 실행 | CPU FP32, 네 thread; RLT TBPTT 간격 128이 모든 훈련 시퀀스를 덮어 이 실험에서는 gradient를 자르지 않음 |
| 공유 입력 | 각 과제에서 세 시드는 data-generation seed, indexed training stream, held-out 예제를 고정해 쓴다. 같은 과제·길이에서는 모든 구조와 시드가 같은 평가 예제를 받는다. |
| 길이 외 평가 | 각 실행에서 in-distribution validation loss가 가장 낮은 checkpoint를 선택하며, 테스트 결과는 선택에 쓰지 않음 |
주된 8층 덧셈 실험은 1–8자리 피연산자로 학습하고 teacher forcing 상태에서 답 토큰 정확도를 잰다. 따라서 이 주 실험은 이전 답 토큰을 틀렸을 때의 자유 생성 회복력을 직접 측정하지 않는다. 별도의 부록 J.7은 16층·seed 42 계열에서 greedy exact-answer+EOS도 보고한다. 9–32자리에서 아홉 RLT 분할은 모두 0/256, 16층 Transformer는 9자리에서만 3/256이고 그보다 긴 길이에서는 0/256이었다. 다만 네 RLT 실행은 snapshot 시점에 2,000 step을 끝내지 못했다. parity는 길이 3–40 비트, mod-5는 표현식 길이, S5는 길이 32의 순열 합성으로 훈련한다. 표준 S5는 120개 순열 전체를 쓰지만 swaps-S5는 항등원과 10개 단일 전치만 쓴다. 두 S5 결과를 같은 난이도의 단일 과제로 합쳐 읽으면 안 되는 이유다(§3.1; Appendix J.7).
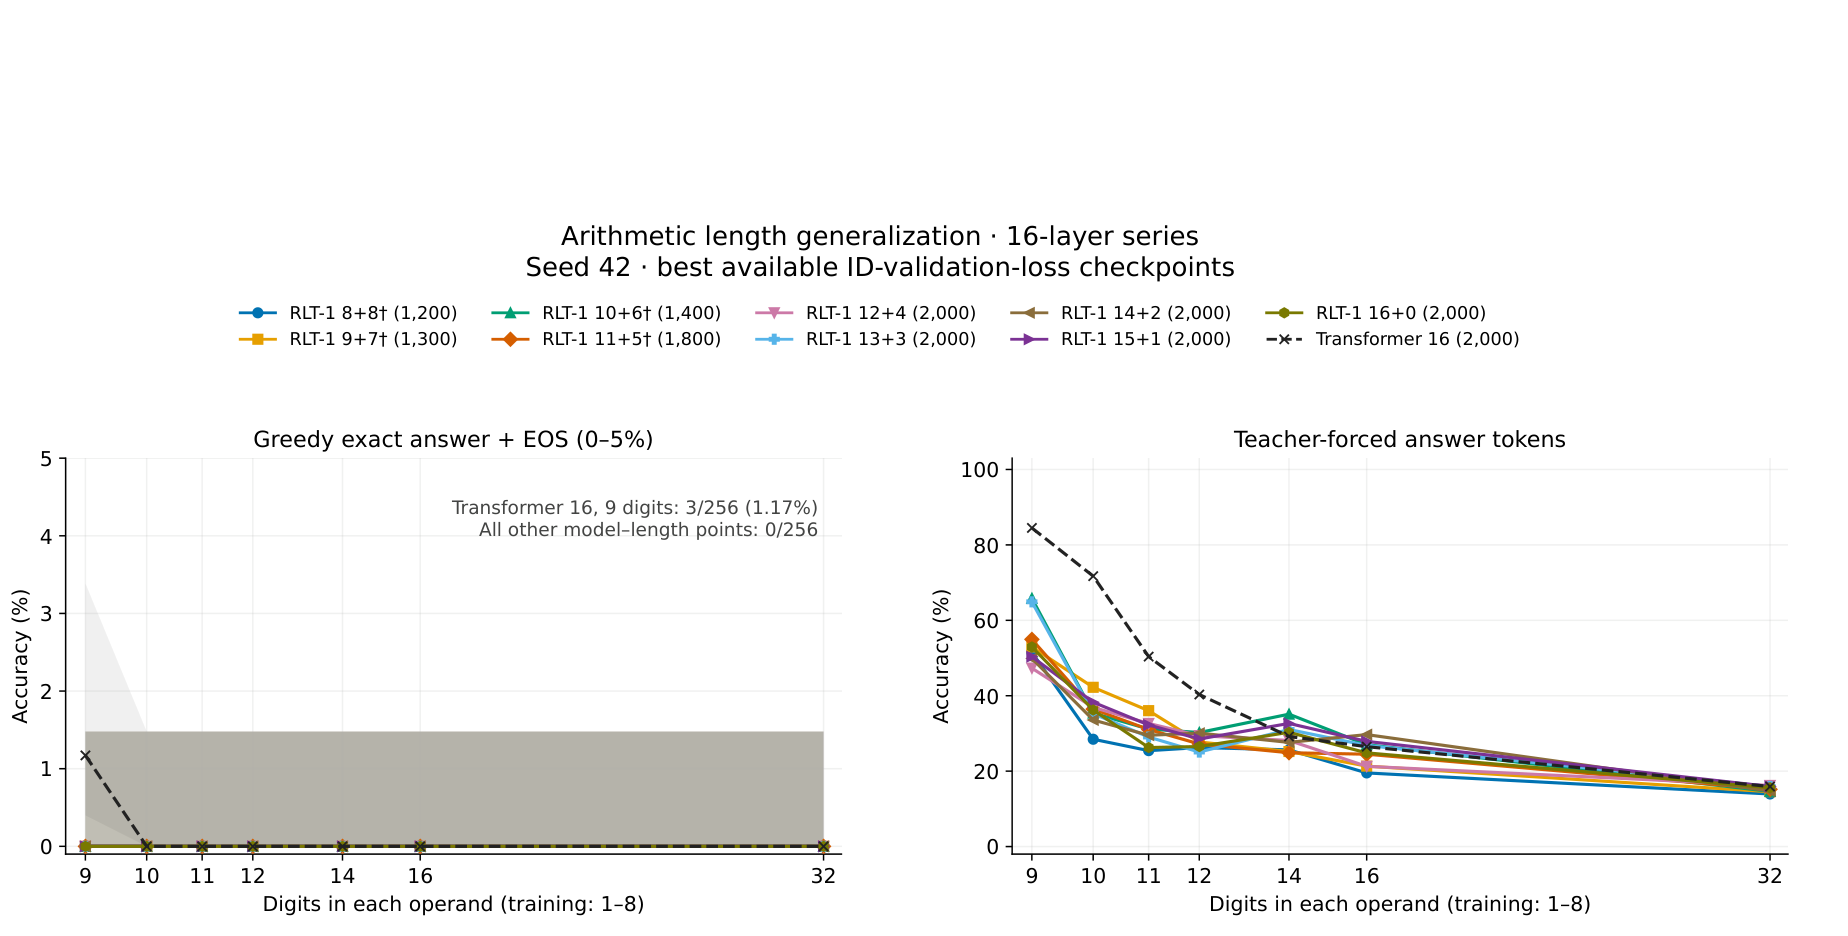
부록의 16층 실험은 초기값 하나를 쓴 별도 비교다. 왼쪽의 완전한 정답과 종료 토큰 일치, 오른쪽의 정답 접두부를 준 토큰 정확도는 다른 지표이며 일부 실행은 미완료여서 본문의 8층·세 초기값 결과와 구분해야 한다. 원논문 Figure 17, p. 41을 그대로 인용했다(2026년 9월 17일 개정판).
6. 결과: 무엇이 좋아졌고, 무엇이 그대로 어려웠나
Table 1은 훈련 길이 안의 2,000-step 정확도, Table 2는 가장 긴 시험 길이의 정확도다. 아래 수치는 과제·길이마다 모든 구조와 시드에 같은 고정 평가 예제를 주고, 세 초기값의 평균±표본 표준편차로 집계한 값이다.
| 관찰 | 개정본이 보고한 수치 | 해석의 경계 |
|---|---|---|
| parity 학습 속도 | 500 step에서 6+2는 99.44±0.98%, Transformer는 48.48±0.53% | 특정 과제에서 일부 순환 배분이 더 빨리 학습했음을 뜻한다. 모든 분할의 공통 우위는 아니다. |
| parity 256비트 | 5+3·7+1: 각각 100.00±0.00%; Transformer: 50.07±1.63% | 훈련 길이 40을 크게 넘어서도 두 분할은 세 시드 모두 유지했다. 4+4·6+2·8+0은 더 낮고 변동도 컸다. |
| swaps-S5 256연산 | 4+4: 97.30±2.76%; Transformer: 0.85±0.30% | 순열 상태를 토큰마다 갱신하는 더 제한된 입력 분포에서 큰 차이가 난다. |
| swaps-S5 512연산 | 4+4: 55.70±25.78%; Transformer: 0.85±0.30% | 평균 차이는 크지만 RLT 쪽 표준편차도 크다. 세 시드의 안정적인 동일 성능으로 읽을 수 없다. |
| flat mod-5 길이 63 | 5+3: 66.96±40.04%; Transformer: 24.48±3.89% | 5+3의 매우 큰 SD는 성공과 거의 chance 수준 실행이 공존했음을 뜻한다. |
| 덧셈 길이 32 | 모든 모델 평균 14.89–16.84% | 순환 연결만으로 훈련 범위 밖 덧셈을 해결하지 못했다. 지표도 teacher-forced token accuracy다. |
더 중요한 것은 ‘최적 분할’이 하나가 아니라는 사실이다. parity는 5+3과 7+1이 일관되게 길이 외 일반화를 보인 반면, 긴 swaps-S5에서는 4+4처럼 decoder가 더 깊은 분할이 좋았다. 표준 S5의 길이 512 최종 상태 정확도는 모든 모델이 0.72–1.43%였고, 120개 클래스의 균등 기준 0.83% 근처에 머물렀다. 따라서 논문이 입증한 것은 순환 디코더가 상태 추적 일반화를 보편적으로 해결한다는 명제가 아니라, 계산 형태에 맞는 깊이 배분이 일부 합성 과제에서 차이를 만들 수 있다는 관찰이다(§§3.4–3.5, Table 2).
결과표를 읽는 단위
Table 2의 각 행은 ‘가장 긴 길이’와 ‘그 과제의 점수 규칙’을 함께 묶은 관찰이다. parity와 mod-5는 마지막 label 정확도이고, swaps-S5는 마지막 순열 상태 정확도다. S5에는 중간 상태를 평균내는 prefix-token 정확도와 모든 중간 상태가 맞아야 하는 whole-sequence 정확도도 가능하지만, 본문 표의 주 지표는 final-state다. 마지막 상태가 맞았다고 모든 중간 예측이 맞았다는 뜻은 아니므로, 이 수치를 장기 실행을 완전히 정확히 모사했다는 증거로 넓히면 안 된다.
또한 긴 길이 결과는 각 model–seed run에서 in-distribution validation example loss가 가장 낮았던 checkpoint를 골라 평가한 값이다. earliest checkpoint tie-break와 테스트 미사용 선택 규칙은 평가 누수를 줄이려는 장치지만, 이 작은 실험에서 과제·seed·분할을 사후로 골라 일반적 우위를 선언할 근거가 되지는 않는다. 본문에서 parity의 5+3·7+1과 swaps-S5의 4+4를 나란히 쓰는 이유도 하나의 승자를 고르기 위해서가 아니라, 같은 RLT-1 안에서도 필요한 recurrent depth가 달랐다는 점을 보이기 위해서다.
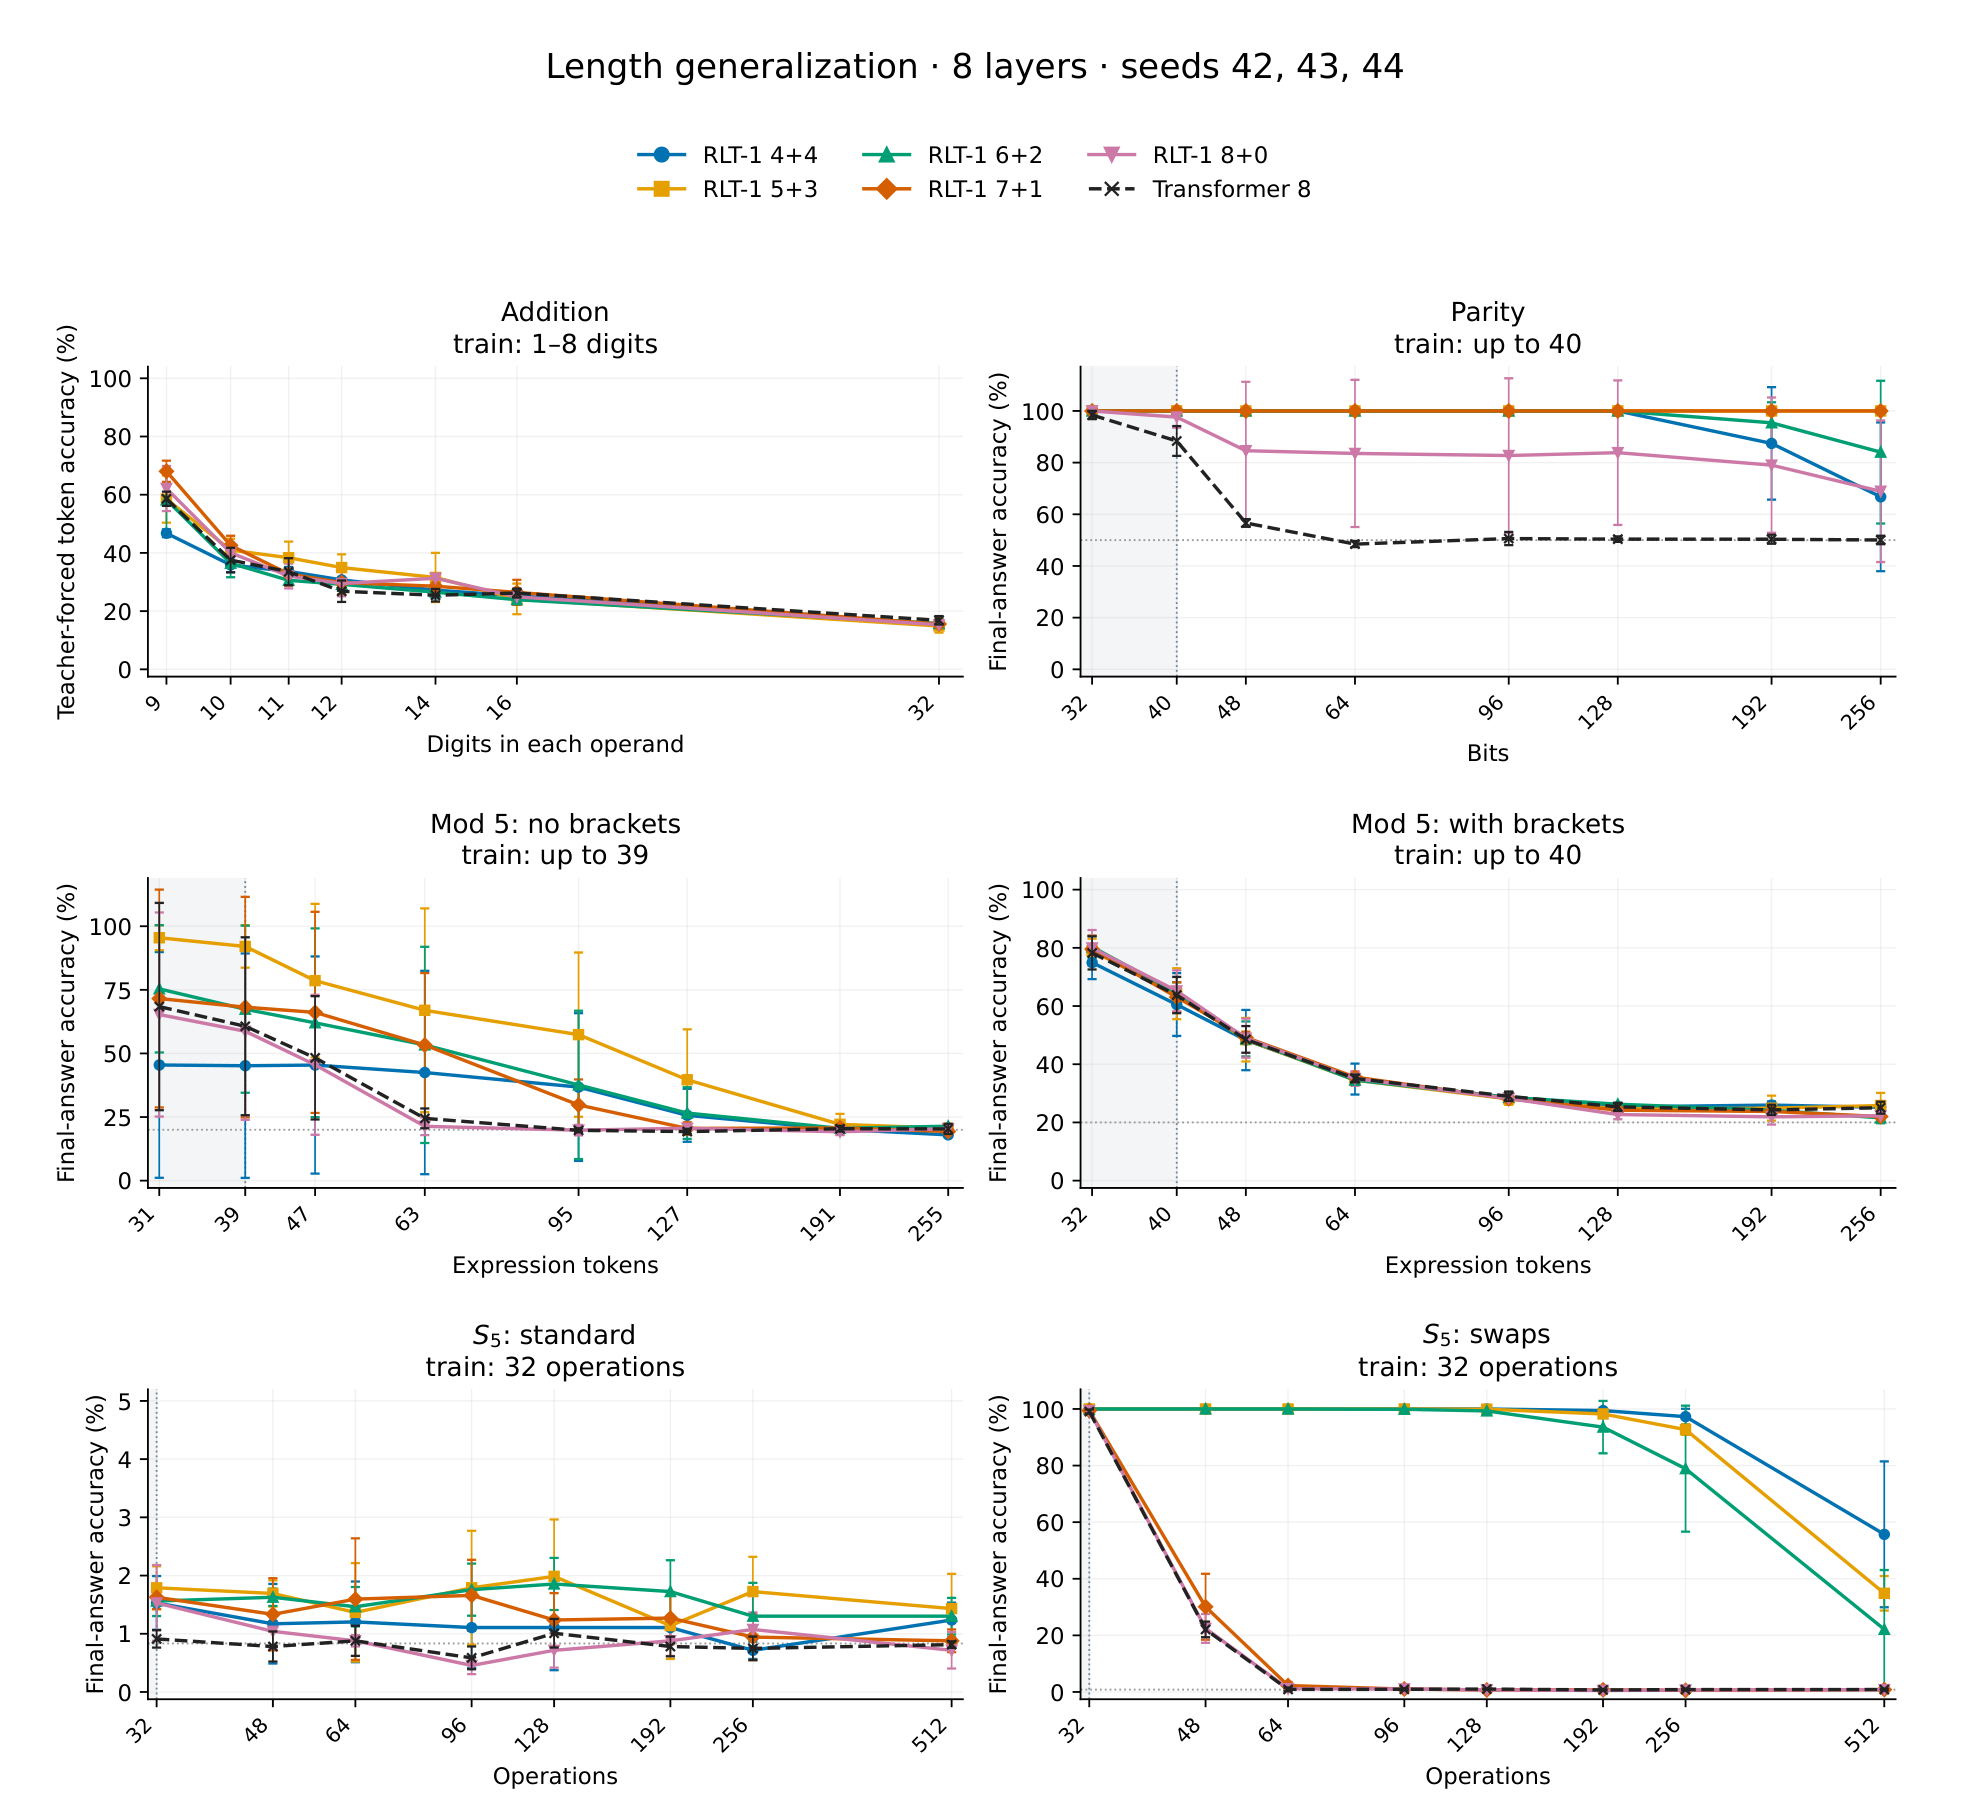
학습 때보다 입력이 길어질수록 성능이 어떻게 달라지는지 본 8층 실험이다. 훈련 길이 안의 검증 손실로 고른 체크포인트에 대해 세 초기값의 평균과 표준편차를 그렸으며, 과제마다 잘 작동하는 층 배분과 변동 폭이 다르다. 원논문 Figure 4, p. 10을 그대로 인용했다(2026년 9월 17일 개정판).
7. 비교가 답하지 못한 질문
저자들은 §3.6에서 decoder-only 비교가 여러 변수를 동시에 바꾼다고 적는다. feedback을 뺐지만 encoder–decoder 분할과 attention 구조를 유지하는 RLT-0을 정의했으나, 그 통제군의 matched 실험은 제시하지 않는다. 따라서 위 결과에서 개선분 중 얼마가 마지막 상태 feedback 자체 때문이고, 얼마가 cross-attention·SWA·파라미터 수 차이 때문인지는 이 표들만으로 분리할 수 없다.
또한 세 시드는 초기화 변동을 보여 주는 최소한의 정보지만, 더 넓은 재현성이나 유의성을 확정하기에는 작다. flat mod-5의 4+4는 세 시드가 17.58%, 19.53%, 98.96%로 갈렸고, parity 5+3 seed 42는 중간 학습에서 100%였다가 48.05%로 떨어진 뒤 다시 올라왔다. 최종 평균만으로 학습 안정성까지 판단하면 중요한 동역학을 놓친다(§§3.3, 3.6).
마지막으로 시스템 비용의 근거가 비대칭이다. 논문은 순차 prefill 의존성, 캐시 저장, 배치 기회, checkpointing을 설계·분석 수준에서 설명한다. 그러나 GPU/가속기 throughput, 지연 시간, 메모리 사용량, 에너지, 대형 모델 스케일링의 실측 표는 없다. 부록 D가 pretraining·SFT·policy-gradient replay의 정확한 상태 재구성 조건을 기술하지만, 현행 실험에는 RL 측정이 없다. 이 글도 그 절차를 실험 성과나 재현 결과로 바꾸어 말하지 않는다.
8. 결론: 구조의 약속과 현재 증거의 경계
RLT-1의 좋은 점은 질문을 구조적으로 또렷하게 만든다는 데 있다. 인코더 메모리로 긴 접두부를 읽고, 직전 디코더 계산을 gated merge로 넘기며, 토큰마다 늘어나는 순환 경로를 만든다. 이 선택은 누적 상태가 중요한 parity와 연산 순서에 따른 상태 갱신이 중요한 swaps-S5 일부 설정에서 길이 외 정확도와 연결됐다.
하지만 설계가 곧바로 범용 우위를 뜻하지는 않는다. 덧셈과 표준 S5는 그 경계를 분명히 보여 준다. 실무나 후속 연구에서 이 구조를 검토한다면, 상태 전이가 과제의 핵심인지, prefill의 순차 비용을 감수할 수 있는지, 각 층 배분을 과제별로 재평가했는지, 그리고 자유 생성·다른 시드·실제 하드웨어에서 같은 결론이 남는지를 함께 확인해야 한다. 본문 수치는 논문 보고값을 검토한 것이며, 별도의 학습 실행이나 실험 재현은 수행하지 않았다.
References
Zhang, Y., Feng, J., & Qin, S. (2026). Recurrent Looped Transformer (RLT-1; first released September 12, revised September 17, 2026). Technical report. https://yifanzhang-pro.github.io/recurrent-looped-tranformer/Recurrent_Looped_Transformer.pdf