Where Reasoning Matters: Rethinking Latent Reasoning in Semantic ID-based Generative Recommendation
IBA는 시맨틱 ID의 위치별 정보이득과 관측된 정제 이득을 이용해 잠재 추론 스텝을 배분한다. 이는 정확도 자체가 아니라 손실 감소를 활용한 대리 목표다.
Paper: Shangxin Yang; Min Gao; Zongwei Wang; Junliang Yu (2026). "Where Reasoning Matters: Rethinking Latent Reasoning in Semantic ID-based Generative Recommendation". https://arxiv.org/abs/2607.12425v1 · arXiv:2607.12425v1
Abstract: Yang et al.은 시맨틱 ID 기반 생성 추천에서 모든 토큰 위치에 같은 잠재 추론 스텝을 주는 관행을 재검토한다. 앞쪽 코드는 아이템 후보를 크게 줄이고 뒤쪽 코드는 이미 좁아진 후보를 세분하므로, 제한된 계산도 위치별 가치에 따라 나누자는 문제의식이다. Information-Gain Budget Allocation(IBA)은 전역적인 위치별 정보이득을 사전값으로 삼고, Stage 1에서 관측한 토큰 손실 감소를 감독 신호로 사용해 사용자 조건부 예측기가 각 스텝의 이득을 추정하게 한다. 이후 총예산 제약 아래에서 사용자별 스텝 열을 고르고, semantic alignment·horizontal refinement·lookahead objective로 가변 깊이 계산을 안정화한다. 저자 보고에서 TIGER와 LETTER에 IBA를 적용한 12개 지표가 모두 개선됐으며, 앞쪽 중심 6스텝 설정은 균등 8스텝과 뒤쪽 중심 6스텝 설정을 앞섰다. 다만 실제 할당기가 학습하는 값은 이론의 정확도 증가가 아니라 clipped cross-entropy 감소량에 정보이득을 곱한 대리 신호다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 시맨틱 ID의 각 토큰 위치에 같은 수의 잠재 추론 스텝을 쓰는 대신, 위치와 사용자 열에 따라 계산 예산을 다르게 배분하면 생성 추천 성능을 높일 수 있는가. |
| 핵심 기여 | 위치별 정보이득을 전역 사전값으로 두고, 사용자 문맥·토큰 위치·후보 스텝을 입력받는 gain predictor와 제약식 기반 탐색을 결합해 총 추론 예산을 사용자별로 배분한다. |
| 방법적 결과 | 기본 사전값 (3,2,1,0)을 그대로 실행하지 않는다. Stage 1의 스텝별 cross-entropy 감소량에 IG_i를 곱한 목표값을 predictor가 근사하고, 예측 이득에서 사전값 이탈 비용을 뺀 목적을 최대화해 \sum_i k_i=B인 할당을 고른다. Dual-Axis Refinement와 lookahead loss가 가변 깊이 계산을 보조한다. |
| 실험 결과 | IBA를 TIGER와 LETTER에 적용하면 Beauty·Instruments·MicroLens의 12개 지표가 모두 오른다. 앞쪽에 집중한 6스텝 prior는 균등 8스텝과 뒤쪽에 집중한 6스텝 prior를 모두 앞선다. |
| 핵심 한계 | 앞쪽 두 위치가 뒤쪽보다 중요하다는 근거는 일관되지만, 위치 1을 위치 2보다 우선하는 기본 스케줄의 세부 순서는 충분히 설명되지 않는다. 반복 통계와 튜닝 프로토콜이 보고되지 않고 \gamma_{rec} 민감도도 크다. |
목차
- 모든 위치에 같은 잠재 추론 예산을 써야 하는가
- 시맨틱 ID와 위치별 정보이득
- Dual-Axis Refinement: 가변 깊이 추론을 안정화하기
- 사용자별 예산 배분과 2단계 학습
- 기존 접근과의 차이와 설계 근거
- 평가 설계와 해석 기준
- 결과와 절제
- 결과가 뒷받침하는 범위
- 결론
1. 모든 위치에 같은 잠재 추론 예산을 써야 하는가
1.1 시맨틱 ID 기반 생성 추천
전통적인 순차 추천은 아이템마다 붙은 독립적인 ID를 분류 대상으로 다룬다. 아이템 수가 늘면 출력 공간도 함께 커지고, 서로 의미가 비슷한 두 아이템이라도 ID 사이에는 구조적인 관계가 없다. 시맨틱 ID 기반 생성 추천은 이 문제를 “다음 아이템의 토큰 열을 생성하는 문제”로 바꾼다. 이 논문에서는 아이템의 제목·카테고리·설명을 Sentence-T5로 임베딩한 뒤 RQ-VAE로 양자화해 네 개짜리 계층 코드
S_v=(c_1,c_2,c_3,c_4)를 만든다. T5 encoder는 사용자의 과거 상호작용 열 H_u=(v_1,\ldots,v_T)을 문맥 벡터 q_u로 바꾸고, decoder는 다음 아이템의 시맨틱 ID를 왼쪽에서 오른쪽으로 생성한다.
P(S\mid q_u)=\prod_{i=1}^{L}P(c_i\mid c_{<i},q_u)이때 앞 토큰은 넓은 후보 공간을 큰 군집으로 나누고, 뒤 토큰은 앞에서 남은 후보를 잔차적으로 세분한다. 생성 중에는 카탈로그에 실제로 존재하는 시맨틱 ID만 이어지도록 prefix trie가 출력을 제한한다. 따라서 모델은 임의의 토큰 열이 아니라 유효한 아이템 ID를 생성한다.
1.2 잠재 추론과 균등 배분
표준 생성기는 decoder가 만든 은닉 상태를 한 번 projection해 다음 토큰을 정한다. 잠재 추론은 명시적인 reasoning token을 출력하지 않고, 토큰을 확정하기 전에 같은 위치의 은닉 상태에 계산을 더한다. 위치 i의 초기 상태와 k_i번의 정제를 간단히 쓰면 다음과 같다.
H_i^{(0)}=f_\theta(q_u,c_{<i}), \qquad H_i^{(j)}=R_\phi^{(j)}(H_i^{(j-1)},q_u,c_{<i})P(c_i\mid c_{<i},q_u)=\operatorname{softmax}\big(g_i(H_i^{(k_i)})\big)중간 상태는 출력 토큰 열에 붙지 않는다. 정제가 끝난 뒤 확정된 c_i만 다음 위치에 전달된다. 그러므로 이 글에서 reasoning은 인간처럼 근거를 언어로 전개하는 능력이 아니라 test-time hidden-state refinement를 뜻한다.
기존 접근은 흔히 모든 위치에 같은 K를 준다. 네 위치에 두 스텝씩 주면 총 여덟 번의 추가 계산이 든다. 구현은 단순하지만 각 위치가 아이템 식별에 기여하는 정보량과 추가 계산의 효용이 같다는 강한 가정을 숨긴다.
1.3 연구 질문
논문이 실제로 묻는 질문은 세 층으로 나뉜다.
| 질문 | 확인해야 할 것 |
|---|---|
| 정보 구조 | 시맨틱 ID 위치마다 아이템 후보의 불확실성을 줄이는 정도가 다른가. |
| 계산 배분 | 총 refinement budget이 고정되어 있을 때 어느 위치에 몇 스텝을 배치해야 하는가. |
| 실행 안정성 | 위치마다 다른 횟수로 decoder 상태를 반복 정제해도 표현이 codeword 공간에서 표류하지 않게 할 수 있는가. |
IBA는 첫 질문에 위치별 정보이득, 두 번째에 gain predictor와 제약식 기반 할당, 세 번째에 Dual-Axis Refinement로 답한다. 이 세 요소를 분리해서 봐야 한다. 정보이득이 크다는 사실만으로 특정 사용자에게 세 번째 스텝이 유용하다는 결론이 나오지는 않으며, predictor가 사용자별 이득을 예측하더라도 반복 정제가 불안정하면 그 배분을 실행할 수 없기 때문이다.
2. 시맨틱 ID와 위치별 정보이득
2.1 접두사 조건부 엔트로피와 정보이득
측정 방식은 접두사 기준이다. 학습 상호작용에서 아이템 v_i의 경험적 빈도를 p(v_i)=n_{v_i}/C로 두고, 위치 t까지 같은 접두사 y_{1:t}를 공유하는 아이템을 후보 집합 S(y_{1:t})로 묶는다. 후보 집합 내부에서 확률을 다시 정규화한 뒤 조건부 엔트로피를 계산한다.
E(y_{1:t})=-\sum_{v_i\in S(y_{1:t})}p_t(v_i)\log_2p_t(v_i)한 토큰을 더 관측했을 때 줄어든 엔트로피가 위치 t의 정보이득이다.
IG_t=E(y_{1:t-1})-E(y_{1:t})이 값은 모델의 예측에서 얻지 않는다. 학습 상호작용 빈도와 시맨틱 ID 접두사로 미리 계산한 전역적 위치 통계다. 특정 사용자의 난이도나 현재 decoder의 불확실성을 직접 나타내지 않는다는 점이 뒤의 allocator를 이해하는 데 중요하다. 학습 집합에서 추정한 평균값이 Figure 2다.
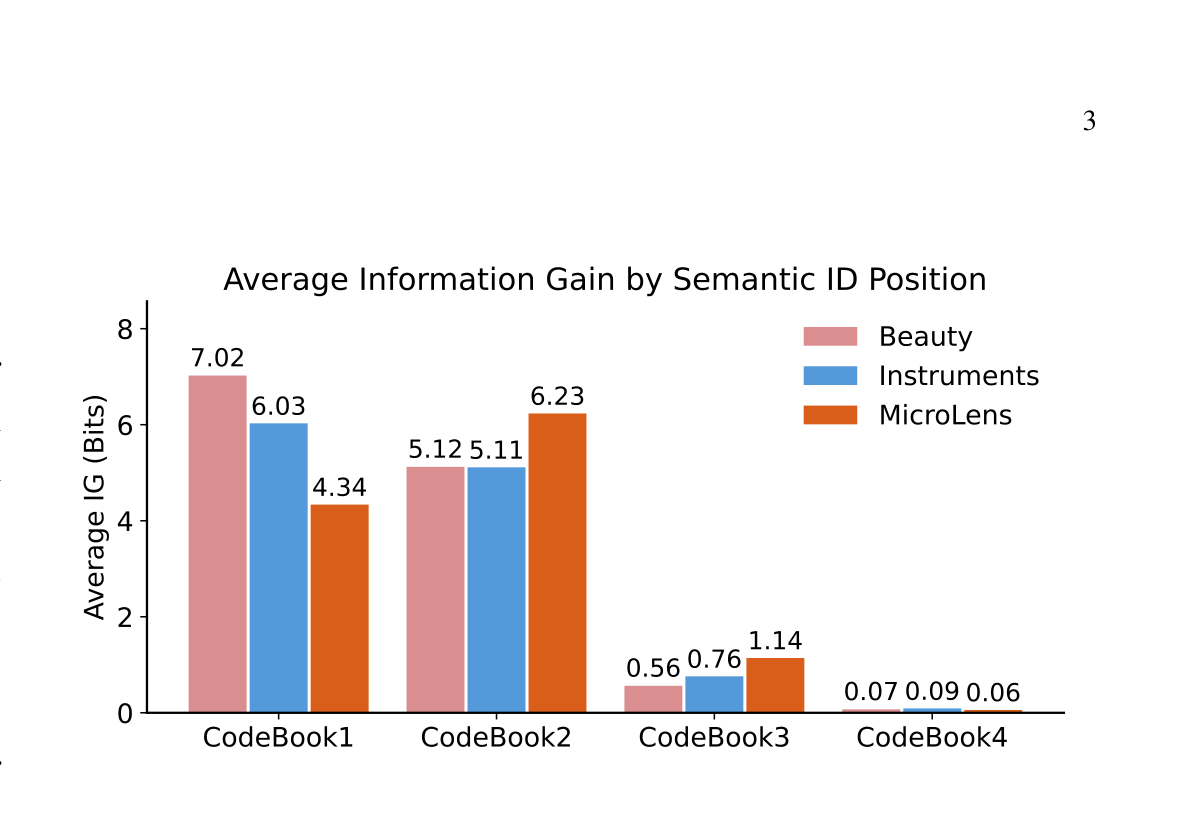
그림 1. Beauty·Instruments·MicroLens의 시맨틱 ID 위치별 평균 정보이득. 출처: Yang et al. (2026), Figure 2, arXiv:2607.12425v1. 원문 도판을 캡처·축소.
Figure 2가 보고한 값은 다음과 같다.
| 위치 | Beauty | Instruments | MicroLens |
|---|---|---|---|
| CodeBook1 | 7.02 | 6.03 | 4.34 |
| CodeBook2 | 5.12 | 5.11 | 6.23 |
| CodeBook3 | 0.56 | 0.76 | 1.14 |
| CodeBook4 | 0.07 | 0.09 | 0.06 |
2.2 세 데이터셋의 위치별 패턴
세 데이터셋 모두 3·4번 위치의 정보이득이 앞의 두 위치보다 매우 작다. Beauty와 Instruments는 위치 1에서 4까지 단조 감소하지만 MicroLens는 위치 2가 6.23으로 위치 1의 4.34보다 43.5% 높다.
논문은 이 차이를 "slightly higher"라고 표현하지만 43.5%는 작다고 보기 어렵다. 이 결과는 앞쪽 두 위치가 뒤쪽보다 중요하다는 일반화는 지지하되, 위치 1이 언제나 가장 중요하다는 순서는 지지하지 않는다.
2.3 RQ-VAE의 구조적 직관과 MicroLens의 예외
RQ-VAE는 첫 코드북이 거친 군집을 잡고 뒤 코드북이 잔차를 담는 구조다. 앞쪽 위치가 더 많은 정보를 담는 경향은 이 설계에서 어느 정도 예상할 수 있다. 논문의 측정 기여는 감소 폭을 정량화하고, MicroLens에서는 앞의 두 위치 순서가 뒤집힌다는 예외를 함께 보여 준 데 있다.
3. Dual-Axis Refinement: 가변 깊이 추론을 안정화하기
3.1 전체 파이프라인
IBA의 출발점은 “어디에 몇 스텝을 쓸 것인가”지만, 가변 스텝을 곧바로 기존 decoder에 적용하지 않는다. 어떤 위치는 세 번, 어떤 위치는 한 번, 어떤 위치는 추가 정제 없이 예측하면 은닉 상태가 서로 다른 깊이의 변환을 거친다. 반복 과정에서 상태가 해당 위치의 codeword 공간에서 멀어지면 스텝 수를 잘 배분해도 예측은 불안정해질 수 있다.
이를 위해 IBA는 계산의 방향을 두 축으로 나눈다.
| 축 | 질문 | 동작 |
|---|---|---|
| Vertical semantic alignment | 현재 상태가 이 위치의 semantic ID 공간과 맞닿아 있는가. | 매 스텝의 raw decoder state를 별도 alignment stack과 FiLM으로 정렬한다. |
| Horizontal hidden refinement | 같은 위치에서 추가 계산을 어떻게 이어 갈 것인가. | 직전 raw state를 anchor로 남기고 aligned state·step embedding을 섞어 decoder에 다시 넣는다. |
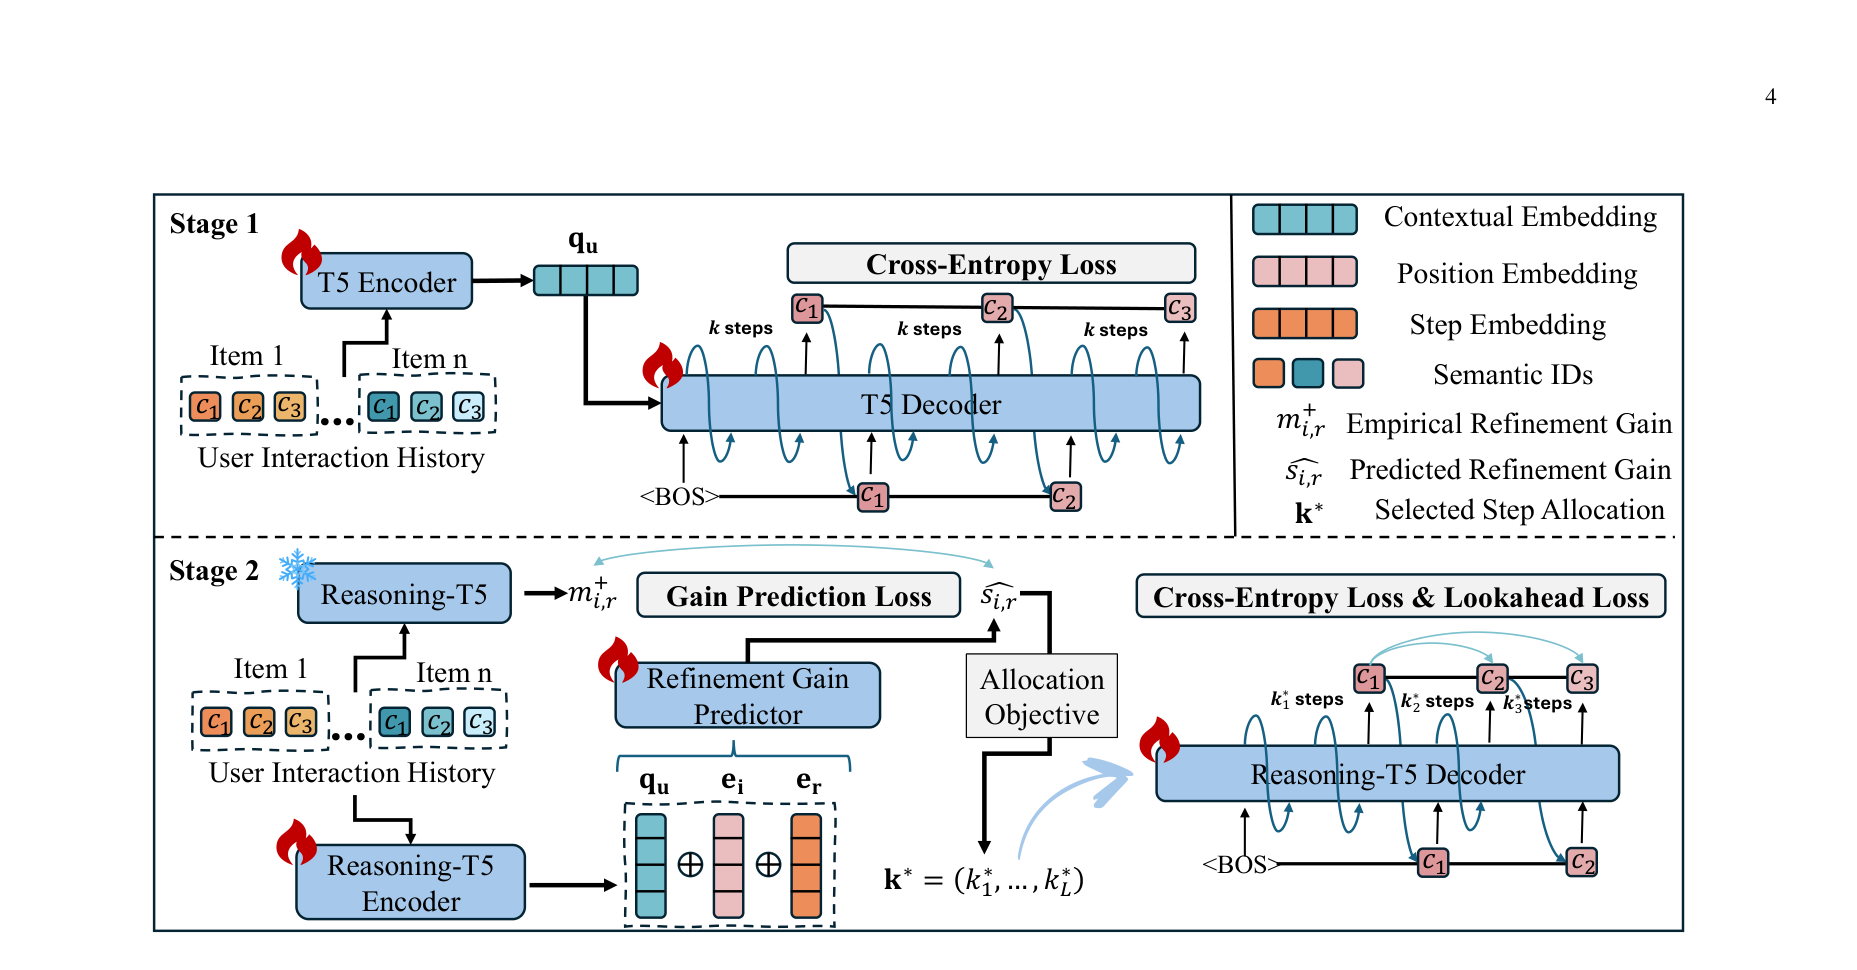
그림 2. IBA의 2단계 학습, refinement gain predictor, 위치별 동적 스텝 배분. 출처: Yang et al. (2026), Figure 3, arXiv:2607.12425v1. 원문 도판을 캡처·축소.
그림의 Stage 1은 균등 정제 모델에서 스텝별 손실 감소를 수집하고, Stage 2는 그 값으로 사용자별 할당을 학습한다. 세부 학습 절차는 4장에서 이어서 본다.
3.2 Vertical semantic alignment
위치 t와 정제 스텝 j에서 decoder가 만든 raw state를 H_{raw,t}^{(j)}라 하자. IBA는 이를 바로 token logits로 보내지 않고, T5 decoder block 구조를 재사용한 alignment stack에 통과시킨다.
H_{align,t}^{(j)}=\operatorname{DecoderStack}_{align}\big(H_{raw,t}^{(j)}\big)이 stack의 목적은 단순히 층을 더 쌓는 데 있지 않다. RQ-VAE의 위치별 codebook C_t가 정의하는 semantic ID 표현 공간과 T5 decoder의 문맥 표현 사이의 간극을 줄이는 것이 목적이다. 논문의 Figure 6은 Instruments의 첫 위치에서 raw state, aligned state, 정답 codeword embedding을 PCA로 투영한다. aligned state가 codeword 쪽으로 이동하는 시각적 패턴은 보이지만, 이는 2차원 정성 분석이다. 거리 감소량이나 causal effect를 정량적으로 검증한 결과는 아니다.
3.3 스텝별 FiLM 조절
같은 alignment를 매번 반복하면 각 스텝의 역할을 구분하기 어렵다. IBA는 스텝별 MLP가 raw state에서 scale과 shift를 만들도록 한다.
\gamma_t^{(j)},\beta_t^{(j)}=\operatorname{MLP}^{(j)}\big(H_{raw,t}^{(j)}\big)H_{out,t}^{(j)}=\big(1+\gamma_t^{(j)}\big)\odot H_{align,t}^{(j)}+\beta_t^{(j)}여기서 (1+\gamma) 형태는 scale이 0일 때 aligned signal을 그대로 보존한다. 즉 FiLM은 각 refinement step이 semantic dimension을 얼마나 증폭하거나 억제할지 조절하되, 정렬된 표현을 기준점으로 유지한다.
3.4 Horizontal hidden refinement
다음 스텝에 직전 aligned state만 넣으면 작은 오차가 반복될 때 누적될 수 있다. IBA는 raw decoder state를 anchor로 남기고, 직전 aligned state와 learnable step embedding a_j를 함께 섞는다.
H_{in,t}^{(j)}=(1-\gamma_{rec})H_{raw,t}^{(j-1)}+\gamma_{rec}H_{out,t}^{(j-1)}+a_jH_{raw,t}^{(j)}=\operatorname{Decoder}\big(H_{in,t}^{(j)}\big)최종적으로 선택된 k_t^*번의 refinement가 끝나면 위치별 LM head가 logits를 만든다.
z_t=\operatorname{LMHead}_t\big(H_{out,t}^{(k_t^*)}\big)\gamma_{rec}는 과거 raw state와 직전 aligned state 사이의 균형을 정한다. 너무 작으면 반복 정제의 피드백이 약하고, 너무 크면 이미 변환된 표현에 의존하면서 trajectory가 흔들릴 수 있다. 논문은 0.3부터 0.7까지 비교해 0.5를 기본값으로 택한다. 다만 MicroLens에서 민감도가 크므로 이 계수는 구현 세부가 아니라 결과를 좌우하는 핵심 하이퍼파라미터에 가깝다.
3.5 스텝이 0인 위치도 같은 모듈을 쓴다
k_t^*=0이면 반복 decoder update는 건너뛰지만, 초기 상태 H_{out,t}^{(0)}는 semantic alignment를 거친 뒤 예측에 쓰인다. 따라서 기본 prior의 마지막 값이 0이라고 해서 네 번째 토큰이 원래 TIGER와 완전히 같은 경로를 쓰는 것은 아니다. IBA의 alignment module과 늘어난 파라미터는 그대로 남는다. 이 구분은 “6스텝 IBA”를 “TIGER에 계산 여섯 번만 더한 모델”로 단순화하지 않게 해준다.
4. 사용자별 예산 배분과 2단계 학습
4.1 이론적 효용: 정보량과 정제 가능성을 곱한다
정보이득만 큰 위치라도 모델이 이미 충분히 잘 맞히거나 추가 계산으로 개선되지 않으면 스텝을 더 줄 이유가 없다. 논문은 위치 t에서 k번 정제한 뒤 token을 정확히 예측할 확률을 q_t(k)라 두고 기대 효용을 정의한다.
U_t(k)=q_t(k)IG_t한 스텝을 추가했을 때의 효용은 다음과 같다.
\Delta U_t(k)=\big(q_t(k+1)-q_t(k)\big)IG_t=\rho_t(k)IG_t이 식이 주는 직관은 명확하다. 후보 공간을 많이 줄이는 위치이면서, 한 번 더 생각했을 때 token accuracy가 실제로 오르는 위치에 계산을 써야 한다. 그러나 실제 학습은 q_t(k)나 \rho_t(k)를 직접 관측하지 않는다. 다음 절의 cross-entropy 감소량을 대리 신호로 쓴다.
4.2 Gain predictor는 무엇을 입력받고 무엇을 학습하는가
사용자 u의 encoder context q_u, semantic ID 위치 embedding e_i, 후보 refinement step embedding e_r를 이어 붙여 작은 MLP에 넣는다.
\widehat{s}_{i,r}=\operatorname{Softplus}\big(g_\psi([q_u;e_i;e_r])\big)Softplus는 예측 이득을 음수가 아닌 값으로 제한한다. \widehat{s}_{i,r}는 “이 사용자에게 위치 i의 r번째 추가 스텝을 배정했을 때 얻을 이득”의 추정치다.
감독 신호는 Stage 1 checkpoint를 최대 K_{max} 스텝까지 펼쳐 얻는다. 위치 i에서 r번 정제한 logits의 token cross-entropy를 \ell_i^{(r)}라 두고, 한 스텝을 더했을 때 줄어든 loss에 정보이득을 곱한다.
m_{i,r}^{+}=\max\big(0,\ell_i^{(r-1)}-\ell_i^{(r)}\big)IG_i\mathcal{L}_{gain}=\sum_{i=1}^{L}\sum_{r=1}^{K_{max}}\left(\widehat{s}_{i,r}-\operatorname{sg}(m_{i,r}^{+})\right)^2두 선택이 중요하다. 첫째, loss가 오르는 negative gain은 0으로 잘린다. predictor는 “이 스텝이 해로울 수 있음”을 음수로 학습하지 않고 “추가 이득 없음”으로만 배운다. 둘째, target에는 stop-gradient가 걸려 allocator의 회귀 손실이 Stage 1의 관측값을 역으로 바꾸지 못한다.
여기서 이론과 구현 사이에 간극이 생긴다. 이론의 \rho_t(k)는 정확 token probability의 증가지만, 실제 m_{i,r}^{+}는 clipped cross-entropy 감소다. 연속적인 감독 신호를 얻기 쉬운 합리적인 선택이지만, predictor가 Eq. (9)의 효용을 직접 추정한다고 표현하면 과하다. 논문은 이 대리값과 실제 할당 효용 사이의 calibration을 보고하지 않는다.
4.3 사전값은 고정 스케줄이 아니라 연성 제약이다
predictor가 모든 후보 스텝의 이득을 내면 allocator는 다음 목적을 최대화한다.
k^*=\arg\max_{k\in\mathcal{K}}\left[\sum_{i=1}^{L}\sum_{r=1}^{k_i}\widehat{s}_{i,r}-\lambda_P\lVert k-k^{prior}\rVert_1\right]\mathcal{K}=\left\{k\mid 0\le k_i\le K_{max},\ \sum_{i=1}^{L}k_i=B\right\}첫 항은 선택한 스텝들의 예측 이득을 합하고, 둘째 항은 기본 사전값에서 멀어진 만큼 벌점을 준다. 기본값은 k^{prior}=(3,2,1,0), 총예산은 B=6, 사전값 가중치는 \lambda_P=0.1이다. 따라서 모든 사용자에게 (3,2,1,0)을 그대로 적용하는 것이 아니다. predictor의 신호가 충분하면 같은 총예산 안에서 다른 열을 고를 수 있다.
L=4와 K_{max}가 작기 때문에 논문은 가능한 정수 할당을 enumeration해 최적값을 찾는다. 선택은 사용자당 한 번만 계산되고 beam search 후보들이 공유한다. beam마다 allocator를 다시 돌리지 않으므로 decoding은 결정적이고 추가 탐색 비용도 제한된다. 다만 v1은 K_{max}의 실제 값과 동률인 allocation의 tie-breaking 규칙을 보고하지 않는다.
4.4 Stage 1: 균등 정제로 이득 목표값 만들기
처음부터 가변 깊이를 학습하면 refinement 동작 자체와 allocator의 판단이 동시에 흔들릴 수 있다. Stage 1은 모든 위치에 같은 K=2를 주고 semantic ID cross-entropy로 200에폭 학습한다.
k_i=K \quad \text{for all } i이 checkpoint는 두 역할을 한다. 먼저 위치마다 반복 정제를 수행할 수 있는 Reasoning-T5를 만들고, 이어 각 후보 스텝의 \ell_i^{(r-1)}-\ell_i^{(r)}를 측정해 gain predictor의 target을 제공한다.
4.5 Stage 2: 선택된 스텝 열로 공동 미세조정하기
Stage 2는 Stage 1 checkpoint에서 시작해 50에폭 미세조정한다. 각 사용자에 대해 predictor가 gain을 계산하고, allocator가 k^*를 선택하며, recommender는 추론 때와 같은 선택 스케줄로 token을 예측한다. 최종 loss는 세 항의 합이다.
\mathcal{L}_{stage2}=\mathcal{L}_{main}+\lambda_{LA}\mathcal{L}_{LA}+\lambda_{gain}\mathcal{L}_{gain}\mathcal{L}{main}은 선택된 최종 state의 semantic ID prediction loss다. \mathcal{L}{gain}은 predictor를 Stage 1 target에 맞추고, \mathcal{L}_{LA}는 앞 위치의 refined state가 가까운 미래 위치도 예측하도록 만든다.
논문은 Stage 2 학습 이후의 gain calibration과 실제 allocation 분포를 별도로 보고하지 않는다.
4.6 Lookahead: 앞 토큰의 계산이 뒤 토큰에도 남게 하기
앞 위치에 계산을 몰면 그 표현이 현재 token만 잘 맞히는 데 소진될 수 있다. IBA는 위치 t의 최종 refined state에 offset embedding o_\delta를 더해 가까운 미래 token c_{t+\delta}도 예측하게 한다.
P_\delta(c_{t+\delta}\mid q_u,c_{<t})=\operatorname{softmax}\left(\operatorname{LMHead}_{t+\delta}\left(H_{out,t}^{(k_t^*)}+o_\delta\right)\right)최대 offset은 \Delta=2다. 유효한 모든 (t,\delta) 쌍에서 평균 cross-entropy를 구해 \mathcal{L}{LA}로 사용한다. 이는 별도의 미래 token을 생성하는 inference 절차가 아니라 training-time auxiliary objective다. 기본 weight \lambda{LA}=0.15를 넘겨 크게 주면 특히 MicroLens 성능이 내려가므로, lookahead가 main objective를 지배하지 않게 해야 한다.
4.7 알고리즘으로 다시 쓰기
아래는 논문의 Eq. (16)–(27)을 실행 순서대로 재구성한 것이다.
입력: user history H_u, global IG_1...IG_L, budget B, prior k_prior

1. 모든 위치에 K=2를 주고 Reasoning-T5를 학습한다.
2. 위치·후보 스텝별 손실 감소를 측정하고, 음수는 0으로 자른 뒤 IG_i를 곱한다.
3. 사용자 문맥·위치·스텝 embedding으로 이득을 예측한다.
4. 합계가 B인 할당 중 예측 이득에서 사전값 이탈 비용을 뺀 값이 가장 큰 k*를 고른다.
5. k*에 따라 Dual-Axis Refinement를 실행한다.
6. main·lookahead·gain prediction loss로 Stage 2를 미세조정한다.
7. 추론에서는 사용자당 할당을 한 번 선택해 모든 beam candidate에 공유한다.
알고리즘 1. 논문의 수식과 설명을 바탕으로 재구성한 IBA 학습·추론 절차. 원문 의사코드를 복사한 것이 아니다.
5. 기존 접근과의 차이와 설계 근거
5.1 비교 축
IBA는 새로운 item tokenizer나 거대한 추천 backbone을 제안하지 않는다. TIGER와 LETTER 위에 refinement와 allocation을 얹어 “추가 계산의 위치”를 최적화한다.
| 접근 | 계산 방식 | IBA와의 차이 |
|---|---|---|
| SASRec·CASER | 일반 item ID를 직접 ranking | 생성형 semantic ID 모델이 아닌 전통 순차 추천 기준선 |
| TIGER | RQ-VAE semantic ID를 T5로 생성 | IBA가 직접 확장하는 기본 backbone |
| LETTER | collaborative signal을 반영한 learnable tokenization | tokenizer를 개선하며 IBA는 생성 중 계산을 배분 |
| LatentR3 | 강화학습 기반 latent reasoning | 논문 비교상 위치별 IG allocation이 없음 |
| CARE | cascaded ranking 관점의 semantic ID latent reasoning | 명시적인 position-wise IG allocation을 제시하지 않음 |
| IBA | TIGER·LETTER에서 위치별 hidden-state refinement | 사용자별로 스텝을 고르되 총예산을 고정 |
이 비교에서 조심할 점은 IBA가 LatentR3나 CARE와 동일한 backbone·학습 예산 아래 순수 allocator만 비교한 것은 아니라는 사실이다. Table II는 서로 다른 시스템의 최종 점수 비교이고, IBA 내부의 인과적 기여는 Table III·IV에서 따로 판단해야 한다.
5.2 각 장치는 어떤 실패를 막는가
| 장치 | 막으려는 실패 양상 | 작동 논리 |
|---|---|---|
| IG 사전값 | predictor가 적은 신호로 임의의 위치에 예산을 몰아주는 현상 | 학습 데이터의 prefix entropy 감소를 전역 방향으로 제공 |
| Gain predictor | 같은 위치라도 사용자마다 refinement 효용이 다른 문제 | 사용자 문맥과 위치·스텝 embedding으로 한계 이득을 예측 |
| 사전값 이탈 벌점 | noisy gain prediction이 구조적 패턴에서 과도하게 벗어나는 문제 | L_1 비용으로 사전값 주변을 선호하되 이탈은 허용 |
| Vertical alignment | 반복 decoder update가 codeword 공간에서 표류하는 문제 | 매 스텝을 위치별 semantic ID 공간에 다시 정렬 |
| Raw-state anchor | aligned state만 되먹이며 오차가 누적되는 문제 | raw와 aligned state를 \gamma_{rec}로 혼합 |
| Lookahead | 앞 위치의 추가 계산이 현재 token에만 과적합되는 문제 | refined prefix state로 가까운 뒤 token까지 예측 |
6. 평가 설계와 해석 기준
6.1 데이터셋과 전처리
평가는 두 종류의 Amazon review 데이터와 micro-video 데이터에서 이뤄진다. 사용자는 최소 5회 이상 상호작용한 경우만 남기고, 입력 이력은 최대 20개 아이템으로 제한한다. 각 사용자에서 하나의 held-out next-item을 예측하는 leave-one-out protocol을 사용한다.
| 데이터셋 | 사용자 | 아이템 | 상호작용 | 사용자당 평균 상호작용 |
|---|---|---|---|---|
| Instruments | 24,772 | 9,922 | 206,153 | 8.32 |
| Beauty | 22,363 | 12,101 | 198,502 | 8.88 |
| MicroLens | 13,210 | 5,312 | 78,255 | 5.92 |
Amazon 두 데이터셋은 상품 영역이 다르지만 같은 review corpus 계열이고, MicroLens는 micro-video 소비라는 별도 도메인이다. 세 데이터셋 모두 상대적으로 짧은 사용자 이력을 가지며, 산업 규모의 긴 sequence나 매우 큰 catalog에서 allocator가 같은 양상을 보이는지는 이 평가로 알 수 없다.
6.2 백본·기준선·지표
기준선은 전통 순차 추천 SASRec·CASER, latent reasoning 추천 LatentR3, semantic ID 생성 추천 TIGER·LETTER, reasoning-enhanced semantic ID 추천 CARE다. 각 방법의 개념적 차이는 5.1에서 정리했다. 논문은 TIGER와 LETTER 각각에 IBA를 붙여 특정 tokenizer나 backbone에 묶이지 않는 개선인지 확인한다.
주요 지표는 Recall@5·10과 NDCG@5·10이다. leave-one-out에서는 사용자마다 정답 아이템이 하나이므로 Recall은 top-K 안에 정답이 들어왔는지를, NDCG는 그 정답이 목록 앞쪽에 얼마나 높게 놓였는지를 반영한다. 다만 Table II의 모든 기준선이 같은 수의 파라미터, 같은 training compute, 같은 reasoning budget을 쓰는 통제 실험은 아니다.
6.3 학습과 추론 설정
| 항목 | 설정 |
|---|---|
| Backbone | 모든 실험에서 T5-small |
| Semantic ID | Sentence-T5 item embedding → RQ-VAE → 4-token hierarchical ID |
| Stage 1 | 균등 K=2, 200 epochs, learning rate 5\times10^{-4} |
| Stage 2 | 50 epochs, learning rate 5\times10^{-5} |
| Batch | 128, gradient accumulation 2 |
| 기본 할당 | k^{prior}=(3,2,1,0), B=6, \lambda_P=0.1 |
| Refinement | L_{align}=5, \gamma_{rec}=0.5 |
| Lookahead | \Delta=2, \lambda_{LA}=0.15 |
| Decoding | beam size 20, 최대 생성 길이 10, prefix trie constraint |
| Hardware | NVIDIA RTX 4090 24GB, random seed 42 |
이 표만으로 exact reproduction이 완성되지는 않는다. Eq. (16)–(21)의 K_{max}와 전체 Stage 2 loss의 \lambda_{gain} 수치가 v1 구현 세부에 없다. RQ-VAE의 codebook 크기와 tokenizer 학습 세부도 본문의 설명만으로는 충분하지 않으며.
6.4 비교를 읽을 때의 통제 조건
Table III는 균등 사전 스케줄 (2,2,2,2), 뒤쪽 중심 (0,1,2,3), 앞쪽 중심 (3,2,1,0)을 비교한다. 균등 설정은 총 8스텝이고 나머지 둘은 6스텝이다. 따라서 앞쪽과 뒤쪽의 방향 효과는 같은 예산에서 비교할 수 있지만, 균등과 비균등의 차이는 총예산 8 대 6이 함께 바뀐다. 6스텝 균등 스케줄은 제시되지 않는다.
Table IV는 alignment, predictor, lookahead를 하나씩 제거한다. predictor를 제거한 모델은 사용자별 할당 없이 (3,2,1,0)을 모두에게 고정 적용한다. 따라서 full model과의 차이는 사용자 조건부 할당의 추가 효과를 보여 주지만, IG 사전값 자체의 효과를 제거한 비교는 아니다.
6.5 통계 보고와 해석의 상한
논문은 seed 42를 사용했다고 적지만 독립 반복 횟수, 분산, 신뢰구간, 유의성 검정을 보고하지 않는다. 하이퍼파라미터를 어떤 validation split과 기준으로 선택했는지도 설명하지 않는다. 주 결과 12개가 모두 같은 방향이라는 패턴은 확인할 수 있지만, .0001이나 .0002 수준의 절제 차이가 실행 변동보다 큰지는 판단할 수 없다.
7. 결과와 절제
7.1 두 백본의 12개 지표
Table II의 12개 지표를 모바일에서도 비교할 수 있도록 데이터셋별로 나눴다.
Instruments
| Method | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| SASRec | .0512 | .0746 | .0301 | .0373 |
| CASER | .0563 | .0746 | .0443 | .0502 |
| LatentR3 | .0749 | .0963 | .0641 | .0709 |
| CARE | .0572 | .0872 | .0413 | .0510 |
| TIGER | .0687 | .0853 | .0576 | .0629 |
| TIGER+IBA | .0780 | .0975 | .0663 | .0725 |
| LETTER | .0705 | .0882 | .0604 | .0661 |
| LETTER+IBA | .0766 | .0964 | .0656 | .0719 |
Beauty
| Method | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| SASRec | .0196 | .0368 | .0106 | .0160 |
| CASER | .0203 | .0340 | .0125 | .0170 |
| LatentR3 | .0268 | .0453 | .0161 | .0220 |
| CARE | .0229 | .0444 | .0135 | .0204 |
| TIGER | .0206 | .0355 | .0127 | .0174 |
| TIGER+IBA | .0277 | .0453 | .0173 | .0230 |
| LETTER | .0216 | .0362 | .0129 | .0176 |
| LETTER+IBA | .0274 | .0475 | .0172 | .0236 |
MicroLens
| Method | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| SASRec | .0375 | .0698 | .0210 | .0314 |
| CASER | .0157 | .0301 | .0076 | .0122 |
| LatentR3 | .0388 | .0617 | .0248 | .0322 |
| CARE | .0372 | .0583 | .0233 | .0301 |
| TIGER | .0350 | .0561 | .0221 | .0289 |
| TIGER+IBA | .0431 | .0646 | .0278 | .0347 |
| LETTER | .0464 | .0729 | .0298 | .0382 |
| LETTER+IBA | .0540 | .0780 | .0360 | .0437 |
IBA를 얹으면 TIGER와 LETTER 모두 열두 지표 전부에서 오른다. 이 부분은 예외가 없다.
MicroLens에서 TIGER+IBA는 네 지표 모두 기본 LETTER보다 낮다(R@5 .0431 대 .0464). IBA가 약한 백본을 항상 더 강한 백본 위로 올리는 것은 아니다. Beauty R@10에서는 TIGER+IBA(.0453)와 LatentR3(.0453)가 동률이고, Instruments R@10에서 LETTER+IBA(.0964)와 LatentR3(.0963)의 차이는 .0001이다.
논문도 §IV.B에서 가장 강한 IBA 백본은 데이터셋마다 다르다고 명시한다.
7.2 스텝 배분 방향 비교
Table III는 prior의 방향을 같은 예산에서 직접 비교할 수 있는 핵심 실험이다.
| 스케줄 | 총 스텝 | Ins R@10 | Ins N@10 | Mic R@10 | Mic N@10 |
|---|---|---|---|---|---|
| (2,2,2,2) 균등 | 8 | .0961 | .0718 | .0605 | .0335 |
| (0,1,2,3) 뒤로 | 6 | .0947 | .0707 | .0597 | .0330 |
| (3,2,1,0) 앞으로(기본) | 6 | .0975 | .0725 | .0646 | .0347 |
기본 설정은 6스텝으로 균등 8스텝을 앞서고, 같은 6스텝을 뒤쪽에 배분한 설정보다도 높다. 앞쪽과 뒤쪽 prior의 비교는 같은 예산에서 방향 효과를 분리한다. 다만 균등과 비균등의 차이는 총예산이 8 대 6으로 달라 등예산 비교가 아니다.
7.3 정보이득과 관측 정제 이득
4.1의 효용식은 정보이득과 추가 정제로 얻는 token accuracy 증가를 함께 요구한다. Figure 7은 이 직관을 점검하기 위해 균등 k=2 체크포인트에서 teacher forcing으로 측정한 위치별 Token Hit@5를 보여 준다. 다만 Hit@5는 논문의 정확 예측 확률 q_t(k)와 같은 양이 아니므로 \rho_t의 직접 관측값으로 볼 수는 없다.
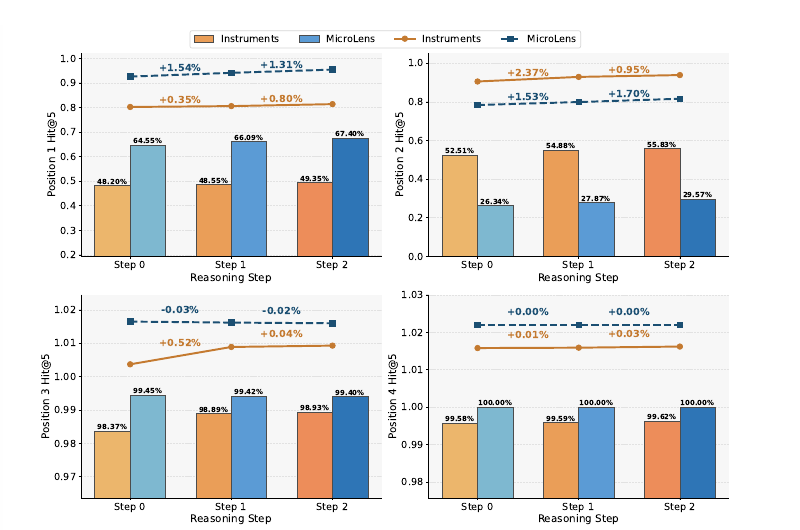
그림 3. Instruments·MicroLens에서 위치별 정제 스텝에 따른 Token Hit@5. 출처: Yang et al. (2026), Figure 7, arXiv:2607.12425v1. 원문 PDF 10쪽의 Figure 7만 캡처·축소.
Instruments Token Hit@5
| 위치 | Step 0 | Step 1 | Step 2 | 0→1 | 1→2 |
|---|---|---|---|---|---|
| 1 | 48.20 | 48.55 | 49.35 | +0.35 | +0.80 |
| 2 | 52.51 | 54.88 | 55.83 | +2.37 | +0.95 |
| 3 | 98.37 | 98.89 | 98.93 | +0.52 | +0.04 |
| 4 | 99.58 | 99.59 | 99.62 | +0.01 | +0.03 |
MicroLens Token Hit@5
| 위치 | Step 0 | Step 1 | Step 2 | 0→1 | 1→2 |
|---|---|---|---|---|---|
| 1 | 64.55 | 66.09 | 67.40 | +1.54 | +1.31 |
| 2 | 26.34 | 27.87 | 29.57 | +1.53 | +1.70 |
| 3 | 99.45 | 99.42 | 99.40 | −0.03 | −0.02 |
| 4 | 100.00 | 100.00 | 100.00 | 0.00 | 0.00 |
3·4번 위치는 Step 0에서 이미 98~100% Hit@5에 도달해 추가 정제의 관측 이득이 매우 작다. 이 결과는 뒤쪽 위치에 균등하게 계산을 쓰는 것이 비효율적일 수 있다는 진단을 직접 뒷받침한다.
앞의 두 위치에서는 다른 패턴이 보인다. Hit@5 증분을 확률 단위로 바꿔 정보이득과 곱한 탐색적 대리값은 네 경우 모두 위치 2에서 더 크다.
| 탐색적 대리값: Hit@5 증분 × IG | 위치 1 | 위치 2 | 더 큰 위치 |
|---|---|---|---|
| Instruments, 첫 스텝 | .0035 × 6.03 = .0211 | .0237 × 5.11 = .1211 | 위치 2 (5.7배) |
| MicroLens, 첫 스텝 | .0154 × 4.34 = .0668 | .0153 × 6.23 = .0953 | 위치 2 (1.4배) |
| Instruments, 둘째 스텝 | .0080 × 6.03 = .0482 | .0095 × 5.11 = .0485 | 위치 2 |
| MicroLens, 둘째 스텝 | .0131 × 4.34 = .0569 | .0170 × 6.23 = .1059 | 위치 2 (1.9배) |
이 표는 논문의 \Delta U_t를 재현한 것이 아니다. Hit@5가 q_t(k)와 다르기 때문이다. 다만 앞쪽 두 위치를 하나로 묶는 설명은 지지해도, 기본 prior의 세밀한 1>2>3>4 순서를 독립적으로 입증하지는 못한다는 신호는 남는다. MicroLens의 정보이득 자체도 위치 2가 위치 1보다 높다.
그럼에도 Table III에서는 (3,2,1,0) 사전값이 균등 8스텝과 뒤쪽 6스텝을 앞선다. 사전 스케줄은 사용자별 예측기가 조정하므로 최종 배분과 같지 않지만, Table III가 배분 방향의 효과를 비교한다는 사실은 유지된다. Figure 7은 Step 0·1·2만 보여 주므로 위치 1에 배정된 세 번째 정제의 효과는 직접 측정하지 않는다.
7.4 구성요소 절제의 규모
Table IV는 세 구성요소를 하나씩 제거한 전체 결과다.
| Variant | Ins R@10 | Ins N@10 | Mic R@10 | Mic N@10 |
|---|---|---|---|---|
| Full IBA | .0975 | .0725 | .0646 | .0347 |
| w/o Alignment | .0939 | .0724 | .0556 | .0303 |
| w/o Predictor | .0958 | .0715 | .0628 | .0345 |
| w/o Lookahead | .0948 | .0714 | .0612 | .0338 |
세 요소를 제거하면 네 지표가 모두 낮아지지만 폭은 크게 다르다. Alignment 제거는 MicroLens R@10에서 .0090의 차이를 만들지만 Instruments NDCG@10에서는 .0001에 그친다. predictor 제거의 차이도 .0002에서 .0018까지 달라진다. 반복 횟수와 분산이 보고되지 않아 작은 차이가 실행 변동과 구분되는지는 판단할 수 없다. NDCG 변화가 어떤 사용자들의 어느 순위 이동에서 발생했는지도 집계 점수만으로는 알 수 없다.
7.5 계산 예산과 지연시간
정확도 향상이 더 많은 계산을 무제한으로 쓴 결과인지 확인하려면 같은 refinement module에서 스텝 수를 달리한 비교가 필요하다. Instruments의 generation 단계 측정은 다음과 같다.
| 방법 | 파라미터 | R@10 | NDCG@10 | 사용자당 생성 시간 |
|---|---|---|---|---|
| TIGER | 60.9M | .0853 | .0629 | 20.99ms |
IBA, 균등 (2,2,2,2) |
83.5M | .0961 | .0718 | 25.78ms |
IBA, 앞쪽 (3,2,1,0) |
83.5M | .0975 | .0725 | 24.61ms |
앞쪽 6스텝 IBA는 균등 8스텝보다 1.17ms 빠르면서 R@10과 NDCG@10이 각각 .0014, .0007 높다. 이는 같은 IBA 파라미터 안에서 계산 배치가 양과 함께 중요하다는 근거다. 반면 기본 TIGER보다는 파라미터가 22.6M 늘고 generation time도 3.62ms 증가한다. 측정은 같은 RTX 4090, beam size, decoding 설정에서 이뤄졌지만 Instruments 한 데이터셋의 model generation 구간만 포함한다. 데이터 로딩·feature 처리·네트워크·후처리를 포함한 서비스 전체 latency 결과는 아니다.
8. 결과가 뒷받침하는 범위
8.1 가장 강한 근거: 앞쪽과 뒤쪽의 차이
Table III의 앞쪽 사전값 (3,2,1,0)과 뒤쪽 사전값 (0,1,2,3)은 모두 6스텝이므로 배분 방향의 효과를 같은 예산에서 비교한다. 앞쪽 사전값이 Instruments와 MicroLens 네 지표에서 모두 높고, 균등 8스텝도 앞선다는 결과는 계산량을 앞쪽에 집중하는 설계를 직접 지지한다.
IBA가 TIGER와 LETTER에 모두 적용되고 세 데이터셋의 12개 지표가 일관되게 오른다는 점도 모듈형 설계의 근거다. 다만 가장 강한 IBA 백본은 데이터셋마다 다르며, MicroLens에서는 TIGER+IBA가 기본 LETTER보다 낮다.
8.2 기본 스케줄과 학습 대리값의 경계
현재 근거는 앞쪽 두 위치에 뒤쪽보다 많은 계산을 주는 방향을 지지하지만, 1>2>3>4라는 세부 순서가 정보이득 때문에 최적이라고 입증하지는 않는다. MicroLens의 정보이득과 Figure 7의 탐색적 계산은 오히려 위치 2의 가치를 보여 준다. 다만 Hit@5는 효용식의 정확 예측 확률이 아니고, 사전 스케줄도 사용자별 예측기가 조정하므로 이 관찰만으로 최적 배분을 역산할 수는 없다.
학습 신호에도 같은 절제가 필요하다. 이론은 token accuracy 증가를 사용하지만 실제 predictor는 clipped cross-entropy 감소를 목표값으로 배운다. 두 값은 관련 있지만 같지 않으며, 예측 이득과 실제 추천 효용 사이의 calibration은 보고되지 않는다. 사용자별 차이는 전역 IG_i가 아니라 q_u를 입력받는 predictor에서 들어가지만, 실제 할당 분포나 사용자 집단별 효과도 제시되지 않는다.
논문은 Stage 2 학습 이후의 gain calibration과 실제 추론 예산 allocation 분포를 별도로 보고하지 않는다.
8.3 통계·튜닝·일반화의 경계
논문은 독립 반복 횟수, 분산, 신뢰구간, 유의성 검정을 보고하지 않는다. seed 42를 사용했다고만 적혀 있어 독립 실행 수를 확정할 수도 없다. 이 때문에 주 결과의 일관된 방향은 확인할 수 있지만 .0001이나 .0002 수준의 구성요소별 차이가 안정적인지는 판단하기 어렵다.
Figure 5에서 \gamma_{rec}=0.5는 네 지표 모두 가장 높다. MicroLens R@10은 \gamma_{rec}=0.3부터 0.7까지 약 .0539, .0525, .0646, .0479, .0450으로 읽힌다. 기본값과 최저값의 차이는 약 .0196으로, 같은 데이터셋에서 IBA가 TIGER에 더한 .0085보다 크다. 값은 도판 눈금에서 읽은 근사치지만 모델이 이 계수에 민감하다는 방향은 분명하다. 하이퍼파라미터 선택·검증 protocol이 없어 외부 재현에서 이 민감도를 어떻게 통제할지는 열려 있다.
IBA는 TIGER와 LETTER 두 백본에만 적용된다. Instruments에서 강한 LatentR3에는 적용하지 않았고 이유도 설명하지 않는다. 시맨틱 ID 길이는 4로 고정되어 (3,2,1,0) prior도 이 길이에 묶이며, 다른 코드 길이와 코드북 크기는 시험하지 않는다. 데이터셋도 Amazon 계열 둘과 micro-video 하나라 도메인 범위가 제한적이다.
논문이 말하는 reasoning도 명시적 사고 과정이 아니라 hidden-state refinement이므로, 인간형 추론 능력의 향상으로 확대 해석해서는 안 된다.
8.4 현재 근거로 남는 기여
IBA는 잠재 추론의 총량뿐 아니라 계산을 어느 토큰 위치에 배치하는지도 추천 성능을 바꿀 수 있음을 실험 가능한 문제로 만든다. 뒤쪽 위치의 낮은 정보이득과 포화된 Hit@5를 정량화하고, 앞쪽 prior와 뒤쪽 prior를 같은 6스텝에서 비교한 것이 핵심 근거다.
특정 백본을 새로 설계하는 대신 기존 TIGER와 LETTER에 배분·정렬·예측·lookahead 모듈을 얹는 구성도 재사용 가능성을 높인다. 논문이 MicroLens의 비단조 정보이득과 데이터셋별 최강 백본 차이를 본문에 함께 적은 점은 결과의 적용 범위를 판단하는 데 도움이 된다.
9. 결론
IBA는 잠재 추론의 질문을 “얼마나 더 계산할 것인가”에서 “어느 위치에 계산을 쓸 것인가”로 옮긴다. 전역 정보이득과 사용자별 예상 이득을 결합하고, 고정된 총예산 안에서 선택한 스텝 열을 Dual-Axis Refinement로 실행하는 것이 방법의 핵심이다.
같은 6스텝을 앞쪽과 뒤쪽에 배치한 비교는 앞쪽 집중의 효과를 직접 지지하고, 두 backbone의 주 결과도 일관된 개선을 보인다. 그러나 앞의 두 위치 사이의 세부 우선순위, cross-entropy 대리값과 실제 추천 효용의 정렬, 작은 절제 차이의 안정성은 아직 확정되지 않았다.
따라서 IBA는 계산 배치가 추천 품질을 바꾼다는 근거와 이를 실행할 설계를 제시한 연구로 읽는 편이 정확하다. 최적 배분 원리를 주장하려면 등예산 균등 비교, 반복 통계, 실제 할당 분포와 predictor calibration, 더 다양한 ID 길이와 backbone이 필요하다.
References
He, Y., Sun, Y., Tan, J., Chen, Y., Kong, X., Shen, C., Wang, X., Zhang, A., & Chua, T.-S. (2026). Reasoning over semantic IDs enhances generative recommendation (arXiv:2603.23183). arXiv. https://arxiv.org/abs/2603.23183
Kang, W.-C., & McAuley, J. (2018). Self-attentive sequential recommendation. In 2018 IEEE International Conference on Data Mining (ICDM) (pp. 197–206). IEEE.
Lin, X., Liu, P., Wang, W., Hu, Y., Xu, C., Feng, F., Wang, Q., & Chua, T.-S. (2026). Bringing reasoning to generative recommendation through the lens of cascaded ranking. In Proceedings of the ACM Web Conference 2026 (WWW '26) (pp. 8939–8949).
Rajput, S., Mehta, N., Singh, A., Hulikal Keshavan, R., Vu, T., Heldt, L., Hong, L., Tay, Y., Tran, V., & Samost, J. (2023). Recommender systems with generative retrieval. Advances in Neural Information Processing Systems, 36, 10299–10315.
Tang, J., & Wang, K. (2018). Personalized Top-N sequential recommendation via convolutional sequence embedding. In Proceedings of the Eleventh ACM International Conference on Web Search and Data Mining (pp. 565–573).
Wang, W., Bao, H., Lin, X., Zhang, J., Li, Y., Feng, F., Ng, S.-K., & Chua, T.-S. (2024). Learnable item tokenization for generative recommendation. In Proceedings of the 33rd ACM International Conference on Information and Knowledge Management (pp. 2400–2409).
Yang, S., Gao, M., Wang, Z., & Yu, J. (2026). Where reasoning matters: Rethinking latent reasoning in semantic ID-based generative recommendation (arXiv:2607.12425v1). arXiv. https://arxiv.org/abs/2607.12425v1
Zhang, Y., Xu, W., Zhao, X., Wang, W., Feng, F., He, X., & Chua, T.-S. (2026). Reinforced latent reasoning for LLM-based recommendation. In Proceedings of the International Conference on Learning Representations.